【何が起きたか】研究実験から実製造ラインへ:Intel Foundryによる量産出荷の到達点
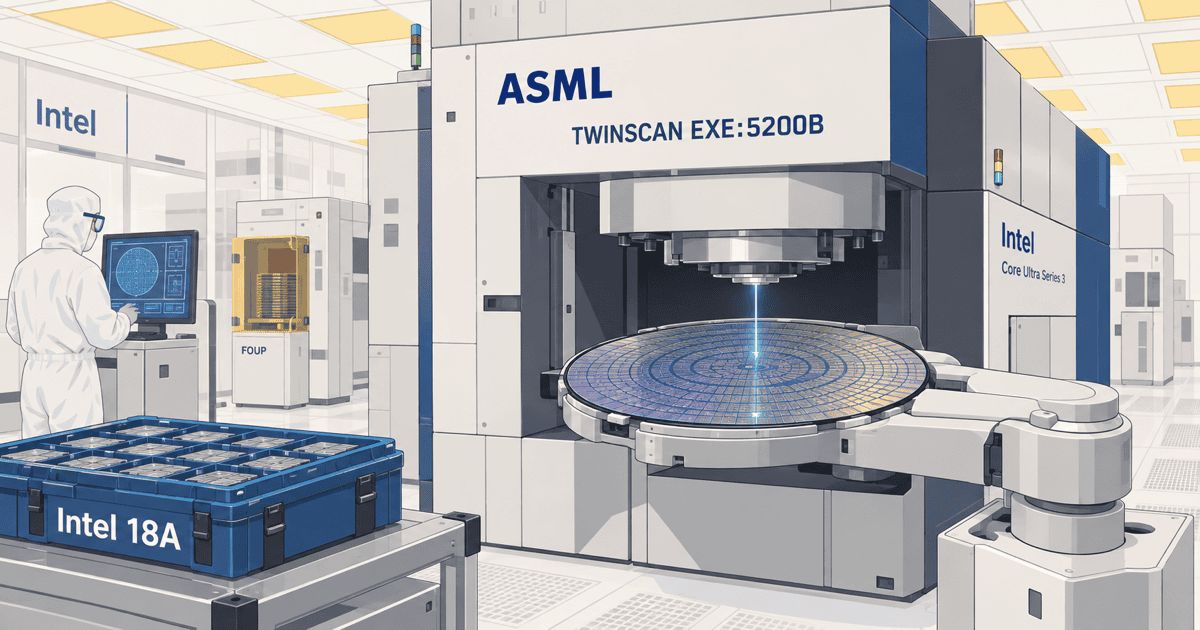
半導体の受託製造を手がけるIntel Foundryは、次世代の露光技術であるHigh-NA EUV(開口数を高めた極端紫外線露光)装置を用い、量産出荷を達成しました[1]。対象製品は、クライアントPC向けプロセッサー「Core Ultra Series 3」(開発コード名:Panther Lake)の一部です[2]。今回の進展は、装置の据え付けや基礎実験の完了を意味するものではありません。実際の商用ロジック半導体として、顧客向けに高ボリューム量産出荷を行う段階へ到達したことを示しています[3]。2024年の装置設置から始まった取り組みは、製品ウエハーでの試験を経て、2026年7月に量産出荷へと結実しました[4]。
ただし、この量産は製造工程の全面的な切り替えではありません。Intelは最先端プロセス「Intel 18A」(Intelのプロセス名称、2nmクラス)において、特定層に限定してHigh-NAを導入しています[5]。その他の多くの層では、従来の0.33 NA EUV露光装置(NXEプラットフォーム)が引き続き併用されています[6, 7]。米オレゴン州の拠点でIntel 18Aの特定層がHigh-NAに対応する認定(デュアルクオリファイ)を受けました[8, 9]。装置メーカーのオランダASMLによると、従来装置と同等の歩留まり(良品率)で顧客へ出荷されています[10]。なお、具体的にどの配線層や接続層にHigh-NAが使われているかは公表されていません[11]。
Intelは2026年9月の国際学会「SPIE」において、現行の標準的な6インチマスクを用いた分割露光技術(レチクル・スティッチング)の成果を発表しました[12]。同社は装置の初期認証や研究開発、特定層の量産を合わせ、High-NAで累計100万枚を超えるウエハー(半導体基板)を処理したと公表しています[13, 14, 15]。この100万枚超という数値は、Panther Lake量産ライン単独の実績ではなく、研究開発やテストを含めた合算値です[16, 17]。一方、ASMLも2026年4月に、High-NAプラットフォーム全体で累計50万枚超の処理と80%超の稼働率を達成したと明らかにしました[18]。しかし、Intel公式発表では個別ラインの歩留まりや稼働率は非公開であり、期待値を満たしているという定性的な説明にとどまっています[19]。
直前の推移図が示すように、Intelは2024年の装置導入から2025年末の受入試験を経て、2026年7月に量産出荷へと着実に進展させました[4]。2025年12月に受入試験を通過した第2世代装置「TWINSCAN EXE
」では、毎時175枚のウエハー出力と0.7nmの重ね合わせ精度が報告されています[20]。ASMLのロードマップでも、スティッチングなしで毎時175枚、スティッチングありで毎時135枚のスループット(処理能力)と、0.8nm以下の装置間重ね合わせ精度が示されています[21]。また別の仕様表では、製品上オーバーレイ1.2nmや専用チャック内0.7nm以下といった厳格な指標が定められています[22]。後輩Intelが量産出荷を始めたなら、すべての工程が次世代装置に切り替わったと捉えてよいのでしょうか。
先輩そこは注意が必要だね。今回はチップ全体ではなく、ごく一部の重要な層に絞って併用している段階だよ。
後輩全面移行ではないのですね。既存の装置と組み合わせる形をとる理由は何ですか。
先輩詳しい理由は公表されていないね。公開情報では、選択層をHigh-NAとNXEの双方で認証しているよ。
後輩選択層に限定した段階的な導入といえるわけですね。
【なぜ今か】2nm以降の微細化限界と多重露光削減がもたらす経済的要請
半導体産業がHigh-NAを必要とする背景には、2nm世代以降における微細化の物理的限界があります[23]。露光装置が解像できる最小寸法は、照射する光の波長と開口数(NA: レンズの集光能力)によって決まります。ASMLのHigh-NA装置「TWINSCAN EXE
」は、光源波長13.5nmを維持したまま、開口数を従来の0.33から0.55へと引き上げました[24, 25]。これにより、解像度は従来の13nmから8nmへと向上しています[24]。単一露光で1.7倍微細なパターンを形成でき、最大2.9倍のトランジスタ密度を実現できます[24]。像の明瞭度を示すイメージングコントラストも従来装置比で40%改善しました[25, 26]。微細化以上に切実な動機となっているのが、多重パターニング(露光と加工を複数回繰り返す手法)の削減です[27]。微細化が進むにつれ、一部のcritical layerでは、従来3〜4回のLow-NA露光工程を重ねる必要が生じていました[27, 28, 29, 30]。High-NAを導入すれば、ロジック半導体の18nmピッチ配線やDRAMの28nmコンタクトピッチを含むパターンクラスなどを、1回の露光で形成できます[31]。露光回数を1回に集約できれば、フォトマスクの枚数や成膜、エッチングなどの付随プロセスが大幅に省かれ、製造期間の短縮につながります[32]。またASMLの試算モデルによると、ウエハー1枚あたりの製造時排出量(Scope 1および2)を最大30%削減できる可能性があります[33, 34, 35]。
ただし、注意すべき前提条件もあります。Intel 18Aで報告された性能電力比15%向上やチップ密度30%改善は、新構造「RibbonFET」や裏面配線「PowerVia」などとの複合効果です。公開情報からHigh-NA単独の寄与度は切り分けられません[36]。またIntelの発表では、21nmピッチの直接描画が配線向けに示される一方、self-aligned trench contactsは補完的パターニング手法と位置付けられています[37]。材料面では研究機関imecが金属酸化物レジスト(MOR)を用い、20nmピッチ配線で90%超の電気的歩留まりを実証しました[38, 39]。しかし、これは初期テスト構造による検証にとどまります[39]。装置性能面では、ASMLの仕様でEXE
、MMO 0.8nm以下とされ、量産投入を支える指標ですが、個別ラインの採算を示すものではありません[40]。総合的に見ると、2nm世代の解像度要求と多重露光削減が2026年の実製造移行を促した主な要因と本稿では推定します[41, 42]。| 項目 | 従来型EUV(NXE) | High-NA EUV(EXE) |
|---|---|---|
| 開口数(NA) | 0.33 | 0.55 |
| 光源波長 | 13.5 nm | 13.5 nm |
| 解像度 | 13 nm | 8 nm |
| パターン微細化(単一露光) | 基準(1.0倍) | 1.7倍微細化 |
| トランジスタ密度向上 | 基準(1.0倍) | 最大2.9倍 |
| イメージングコントラスト | 基準 | +40%向上 |
| 装置間重ね合わせ精度(MMO) | 0.9 nm以下 | 0.8 nm以下 |
| 仕様スループット | 220枚/時(線量30 mJ/cm²) | 175枚/時(スティッチングなし) 135枚/時(スティッチングあり)(線量50 mJ/cm²) |
直前の表は、従来型EUVとHigh-NA EUVの主要な光学仕様と生産性能を比較したものです[24, 25, 40]。High-NAは解像性能と微細化能力で大きく優位に立つ一方、処理能力はスティッチングの有無や露光線量に左右されます[40]。
後輩露光回数が減って工程が簡略化されるなら、製造コストもすぐに下がるのでしょうか。
先輩そう単純にはいかないよ。露光工程自体は減っても、装置自体の減価償却費や周辺材料のコストが初期は重くのしかかるからね。
後輩製造ステップが減るメリットと、新規投資の負担の綱引きになるわけですね。
先輩その通りだね。量産規模が拡大して歩留まりが安定して初めて、工程削減の経済的メリットが投資額を上回るんだよ。
後輩単純な工程数の比較だけでなく、トータルの投資回収を見極める必要があるのですね。
【何が変わるか】光学系とプロセスの激変:露光フィールド半減と焦点深度低下への挑戦
High-NA EUVの導入は、半導体の光学系とウエハー処理プロセスに激変をもたらします。最大の変化は、アナモルフィック光学系(縦横で異なる縮小倍率を持つ光学系)の採用に伴い、露光フィールドが半減したことです[43, 44]。従来の標準的な6インチマスクをそのまま使い続けるため、光学倍率は横4倍、縦8倍という非対称な設計になりました[43]。この結果、ウエハー上で一度に露光できる面積が従来の半分になります[43, 44]。面積の大きなチップを製造する場合、回路をマスク内に収めるフロアプランニングを行うか、分割露光して繋ぎ合わせるスティッチングが必須となります[45, 46]。スティッチングを行うと、EXE
また、装置間重ね合わせ精度(MMO)では0.8nm以下が求められ、従来装置NXE
.9nm以下より厳しい精度が課されます[49]。さらに深刻な物理的課題が、焦点深度(ピントが合う深さの範囲)の低下です。研究機関imecの予測によると、実効焦点深度は従来の0.33 NAと比べて2分の1から3分の1に狭まります[50, 51, 52]。ピントの許容範囲が極めて狭くなるため、パターンの倒れを防ぐにはレジスト(感光材)の膜厚を20nm未満へと薄くしなければなりません[51, 52]。極薄のレジスト層では、光子の少なさや分子分布のゆらぎによって生じる「確率的欠陥」(断線や短絡などの欠陥)のリスクが高まります[53, 54]。微細欠陥を見つける電子線(e-beam)検査は有効ですが、ウエハー全面の検査時間が大幅に増加する問題を抱えています[54]。フォトマスク側の管理項目も大幅に増加しています。光の入射角が広がるため、マスク表面の凹凸構造によって影が生じる「マスク3D効果」が悪化しやすくなります[55, 56]。マスク上のわずかな寸法誤差がウエハー上に拡大転写されるため、低屈折率な新しい吸収体材料の採用が重要になります[55, 56]。マスクを異物から保護するペリクル(防塵膜)については、縦8倍の光学設計により面上のパワー密度が下がる利点があります[57]。しかし、露光ステージの激しい加速に耐え、600Wを超える高出力光源でも劣化しない耐久性と透過率が求められます[57, 58]。
量産採算の観点では、装置価格と供給網の制約が課題として挙げられます。ロイター通信などの報道によると、High-NA装置の価格は1台あたり約3億5000万ドルに達します[59]。光源出力についても、ASMLは2025年4月に1,000Wの実験デモを達成しましたが、商用準備にはなお時間が必要です[60]。さらに、重要光学部品の供給元は独Carl Zeiss SMTの1社のみであり、光学部品の生産能力が装置の供給規模を制約する可能性があります[61]。公表された80%超の稼働率はプラットフォーム全体の実績であり、個別ラインの安定稼働には継続的な改善が必要です[62]。量産においては、解像度の実証だけでなく、スティッチングに伴うコストや薄膜レジストの欠陥管理、部品供給の拡大が主なリスク要因と考えられます[63]。
後輩露光できる面積が半分になると、設計側にはどんな制約が生まれるのですか。
先輩大きなチップを作る場合、回路を2回に分けて露光してウエハー上で繋ぎ合わせる技術が必要になるんだ。
後輩重要パターンに許容値を超えるズレが生じると、歩留まり低下や不良につながり得るわけですね。
先輩だからこそ、設計段階から繋ぎ目を意識した配置配線や、極めて精密な位置合わせが求められるんだよ。
後輩光学系の変化が、半導体の回路設計そのもののルール変更を求めているわけですね。
【誰に影響するか:サプライチェーン】EDA・マスク・材料・検査エコシステムへの波及
High-NAの実用化は、露光装置単体の更新にとどまらず、設計から材料、検査に至る半導体エコシステム全体に波及しています。半導体設計会社は、横4倍・縦8倍のアナモルフィック光学系と半減した露光フィールドを前提に、設計ルールの見直しを進めています[64]。回路設計を支援するEDA(電子設計自動化)ツール企業は、従来の配置配線から、スティッチングを考慮した最適化ソフトウェアへと設計フローを拡張させています[64, 65]。光学近接効果補正(OPC)や逆リソグラフィー技術(ILT)には膨大なGPUやHPC(高性能計算)資源が必要とされ、計算インフラへの投資負担が増しています[66]。
フォトマスク製造のルールも一変しました。マスク3D効果や吸収体の材質、反射率の均一性、経年変化による粗さなどを同時に管理することが求められています[67]。ペリクル企業においても、単なる部材提供にとどまらず、露光スループットの損失や高出力耐久性、ステージ加速下の寿命を最適化するライフサイクル管理の重要性が今後は高まる可能性があります[68]。レジスト材料を手がける企業は、狭まった焦点深度に対応するため、20nm未満の極薄膜化を進めています。化学増幅型レジスト(CAR)の薄膜延伸と、金属酸化物レジスト(MOR)の最適化が急務となっています[69]。
微細パターンの欠陥検出を担う検査装置メーカーでは、電子線(e-beam)やマルチビーム技術と設計データを連動させ、確率的欠陥を捉える手法の確立が進んでいます[70]。ファウンドリを利用する顧客企業にとっては、全面移行ではなく、重要層のみをHigh-NAで処理する選択的なプロセス採用となります[71]。当面の運用としては、現行の6インチマスクを用い、回路のフロアプランニングやIntelのPDK(プロセス設計キット)を活用する形をとります[72]。そして将来的には、スティッチングの制約を解消して生産性を引き上げるため、6×12インチの大型マスクへの移行構想が推進されています[72, 73]。
後輩露光装置が進化しても、材料や検査が追いつかなければ意味がないということですか。
先輩まさにそこが半導体製造の難しいところだね。装置、マスク、レジスト、検査装置が足並みを揃えないと、ラインは動かないよ。
後輩ファウンドリ1社の技術力だけでは、新世代のプロセスは完成しないのですね。
先輩サプライチェーン全体が同じ目標に向けて巨額の開発投資を分担して、初めてエコシステムが成立するんだ。
後輩装置だけでなく、周辺技術の成熟度が実用化の鍵を握っているのですね。
【誰に影響するか:競合比較】TSMC、Samsung、Rapidus、GFの動向と戦略格差
先端半導体の受託製造を担う主要ファウンドリ各社は、High-NAの導入時期や先端プロセス戦略において明確な温度差を見せています[74]。世界最大手である台湾TSMCは、すでにHigh-NA装置を取得して研究開発を開始しています[75]。しかし、先端ノードでの量産開始目標は2030年と設定しています[76, 77]。現時点で、開発中の「A14」プロセスへの量産適用は明示されていません[78]。同社は当面、既存の0.33 NA EUV装置の稼働効率向上や材料欠陥の低減を進めます[79]。さらにNVIDIA「cuLitho」を用いた計算リソグラフィーの量産導入により、既存露光技術を延命させる方針です[80]。
TSMCはHigh-NA導入に先立つ2029年に、A14互換の設計ルールで6%の面積削減を実現する「A13」プロセスの生産を予定しています[81]。また同年に、裏面電力供給「Super Power Rail」を採用した「A12」を投入し、AIや高性能計算向けの性能向上を図ります[82]。同社は新ペリクルや電子線検査の開発を進めつつ、将来の大型12インチマスクについても2031年のパイロットライン稼働、2033年の量産投入というロードマップを描いています[76, 83]。
韓国Samsung Electronicsは、半導体R&D複合拠点「NRD-K」にHigh-NA装置を組み込む計画を進めています[84]。ただし、同社が公表しているHigh-NAの量産目標は、ロジック半導体ではなく、2028年までの次世代DRAMへの適用です[85, 86]。ファウンドリ事業における具体的な採用ノードやファブ計画は公式資料から確定できません[87]。同社はBroadcomとの提携覚書にみられるように、先端メモリー、ファウンドリ、先端パッケージングを包括したソリューション提案を強みとしています[88]。露光工程の削減策としては米Applied Materialsのパターン加工技術「Sculpta」の開発にも参加していますが、代替技術としての認証状況は公表されていません[89, 90]。またASMLによる従来型EUVの生産性向上も続いており、DRAM層での単一露光化が進められています[91]。
日本のRapidus(ラピダス)は、北海道千歳市の「IIM-1」において2nm GAA(全周ゲート)ロジックの開発を進めています[92]。同社は2024年12月に従来型EUV装置「NXE
」を設置し、2025年4月にパイロットラインを稼働させました[92]。2025年7月には2nmトランジスタの試作と電気特性取得を発表し、2026年初頭のPDK提供と2027年の量産を目指しています[93]。確認した公開資料ではHigh-NA装置の導入計画を確認できず、既存EUV装置と独自の設計支援ツール群「Raads」による差別化に注力しています[94, 95]。一方、米GlobalFoundriesは2018年に7nm開発を無期限停止し、高付加価値な差別化プロセスへと舵を切りました[96, 97]。同社の最新資料でもHigh-NA装置の導入計画は示されておらず、先端微細化競争からは一線を画しています[98]。このように各社の戦略は分かれています。先行するIntelは製造現場での学習効果を得られる一方、将来ノードであるIntel 14Aの継続性などを巡り、外部顧客が慎重な姿勢をとるリスクも指摘されています[99]。High-NAの導入遅れによる不利は一律の性能差ではなく、既存露光技術で歩留まりやコストを維持できなくなった層から顕在化するとみられます[100]。
| ファウンドリ企業 | High-NA EUVの導入・量産目標 | 先端ノード戦略と主たる技術アプローチ | 備考・補足 |
|---|---|---|---|
| Intel Foundry | 2024年R&D導入、2026年7月にPanther Lake特定層で量産出荷開始(累計100万枚超処理) | Intel 18Aの特定層で従来型EUVと併用。Intelの従来計画では、次のIntel 14Aへ適用を拡大する位置付けだった | 世界に先駆けて商用ロジック製品の一部層で量産出荷を先行 |
| TSMC | 装置取得・R&D中。先端ノード量産は2030年開始目標 | 既存EUV延命、A13(2029年、面積6%減)、A12(裏面電力供給)、cuLitho生産導入 | 6インチマスクで初期量産、2031年に12インチマスクのパイロットライン目標 |
| Samsung Electronics | R&D拠点NRD-Kに導入計画。2028年までに次世代DRAM量産導入計画 | メモリー先行で量産導入。ロジック向け適用ノードは未特定。Sculpta評価等 | メモリー、先端ファウンドリ、先端パッケージングの包括提案を推進 |
| Rapidus | 導入計画は未公表(計画確認できず) | 従来型EUV(NXE)を用いて2nm GAAの試作と2027年量産を目指す | 設計支援ツール群「Raads」の提供など顧客支援で差別化 |
| GlobalFoundries | 計画未公表(先端微細化から撤退) | 2018年に7nm開発を無期限停止。機能特化型の差別化プロセスへ特化 | 先端微細化競争から転換し、高付加価値プロセスに経営資源を集中 |
直前の表は、主要ファウンドリ各社のHigh-NA EUVに対する姿勢と先端戦略を整理したものです[2, 10, 13, 74, 76, 81, 85, 92, 94, 97, 98]。Intelが量産実績で先行する一方、他社は投資採算性や既存技術の延命効果を見極めながら独自の道を選択しています[74]。
後輩TSMCが導入を急がず既存技術を延命させているのは、技術的に遅れているからですか。
先輩遅れとは断定できないね。公開計画上は、既存EUVの改善を続けつつ2030年量産を目指しているよ。
後輩既存装置の改良で十分な性能が出せるなら、無理に高価な新装置を入れない方が顧客にとっても得策ということですね。
先輩先行して知見を蓄積する戦略と、技術がこなれてから一気に投資する戦略のどちらが勝つかは、今後の歩留まり次第だよ。
後輩各社が置かれた事業環境や顧客層の違いが、そのまま露光技術の導入時期の差として現れているのですね。