なぜ今コードレビューのモデル選定が重要なのか
ソフトウェア開発の現場では、プルリクエスト(コードの変更を統合するための要求)の件数が急増しています。GitHubの統計では、2025年にマージ(変更を統合)されたプルリクエストは月平均4,320万件に達し、前年比で23%増加しました[1]。PRの増加に伴い、新規開発者の80%が参加初週にコード支援ツールのCopilotを利用するなど、開発初期から自動化が進んでいます[2]。2026年3月にはCopilot code reviewの累計利用が6,000万件を超え、GitHub上のコードレビューの5件に1件超を占める規模に拡大しました[3]。
しかし、AIレビューの導入によって人間の確認作業が不要になるわけではありません。実運用データを分析した研究では、AIによるレビューコメントの56.3%が誤検出などを理由に開発者から拒否されています[4]。また、開発者の66%が「ほぼ正しいが不十分な解決策」への対応を負担に感じています[5]。そのため、モデル選定ではAPI(ソフトウェア同士を接続する仕組み)の利用費用だけでなく、人間が再確認する工数を含めた費用対効果の見極めが重要になります。
50件のPR実験で見えたLunaとAstraの決定的な性能差
OpenAIが提供するモデルのうち、GPT-5.6 Lunaはコスト重視の用途に向けたモデルです[6]。標準API価格は入力100万トークン(AIが扱う文字単位)あたり0.20ドル、出力100万トークンあたり1.20ドルです[7]。最上位のGPT-6 Astraは入力10ドル、出力50ドルで、安全なコードレビュー向けと位置付けられています[8]。
同一の50件の公開プルリクエストを用いた独立実験では、両モデルに顕著な差が現れました。Entelligenceの記事が報告した実験では、1レビューあたりの費用はLunaが0.0041ドル、Astraが0.113ドルと、Lunaが約28分の1と報告されています[9]。記事で報告された平均レビュー時間も、50件のPRを対象とした試行においてLunaが23秒、Astraが36秒で、Lunaの方が短い結果でした[10]。ただし、同実験記事での検出精度は全バグを対象とする検出率(再現率)ではなく、全指摘を分母とする適合率(Precision)を指します。検証済みバグの検出数はLunaの69件に対しAstraが92件で、適合率もLunaの74%(約4件に1件が誤検出)に対しAstraは96%(誤検出4件)と開きが生じました[11]。
| 項目 | GPT-5.6 Luna | GPT-6 Astra |
|---|---|---|
| 入力価格(100万トークン) | 0.20ドル[7] | 10.00ドル[8] |
| 出力価格(100万トークン) | 1.20ドル[7] | 50.00ドル[8] |
| 1レビューあたり費用 | 0.0041ドル[9] | 0.113ドル[9] |
| 平均レビュー時間 | 23秒[10] | 36秒[10] |
| 検証済みバグ検出数 | 69件[11] | 92件[11] |
| 検出精度 | 74%[11] | 96%[11] |
欠陥の種別別に見ると、特にセキュリティ領域で大きな性能差が記録されています。検証対象となった24件のセキュリティ欠陥のうち、同実験ではAstraが19件を検出した一方、Lunaは9件にとどまったと報告されました[12]。また、同実験では、認証(本人確認)と認可(権限付与)を担うKeycloak(オープンソースの認証基盤)のプルリクエストを検証しました。記事の報告値では、Astraの検出精度は93%、Lunaは50%でした[13]。日常的なロジック検証では差が縮まるものの、今回の実験結果では、権限管理PRへの単独利用には慎重さが必要と示唆されています。
実験結果を実運用へ適用する際の注意点と測定の限界
今回の実験結果をそのまま実務へ適用することには、いくつかの注意点が存在します。この検証は、5つのリポジトリ(コードと履歴を管理する場所)から抽出した50件のプルリクエストを用いた限定的な事例研究です[14]。また、正解バグの判定者に被験者であるAstra自身が含まれており、判定バイアスが生じた可能性が指摘されています[15]。さらに、対象コードはすべてモデルの学習期間以前のものであり、事前の学習による影響を完全に排除できていません[16]。
後輩実験で高い精度が出ているなら、そのまま開発現場に導入しても問題ないように思えます。なぜ慎重になる必要があるんですか?
先輩実験環境と実際の現場では、AIに渡される情報の深さが大きく異なるからだよ。今回の実験はコードの差分だけを与えていて、リポジトリ全体の文脈や履歴を考慮していないんだ。
後輩それって、前後のコードとのつながりを見ずに判断しているということですか?
先輩その通りだね。特に認証や状態管理のように、システム全体の影響を確認すべき領域では、差分情報だけだと正確な判断が難しくなるよ。
後輩単にモデルの性能比較を見るだけでは、現場で使えるかどうかの判断基準にはならないんですね。
先輩そうだね。提示された数値だけでなく、どのような条件下で測定されたのかという前提を見極めることが大切だよ。
コードレビューにおける重要な課題の一つは、変更箇所の周辺文脈を把握することです。先行研究では、変更差分(変更前後のコードの違い)だけを与えた場合、性能上位のモデルでも人間が指摘する問題の15〜31%しか検出できないとされています[17]。加えて、150行超の差分ではF1(適合率と再現率の調和平均)が大幅に低下する傾向も確認されています[18]。周辺ファイルとの依存関係を考慮しない単一の実験結果をもって、実運用での成否を断定することはできません。
単一モデルから「二段階ルーティング」への運用変化
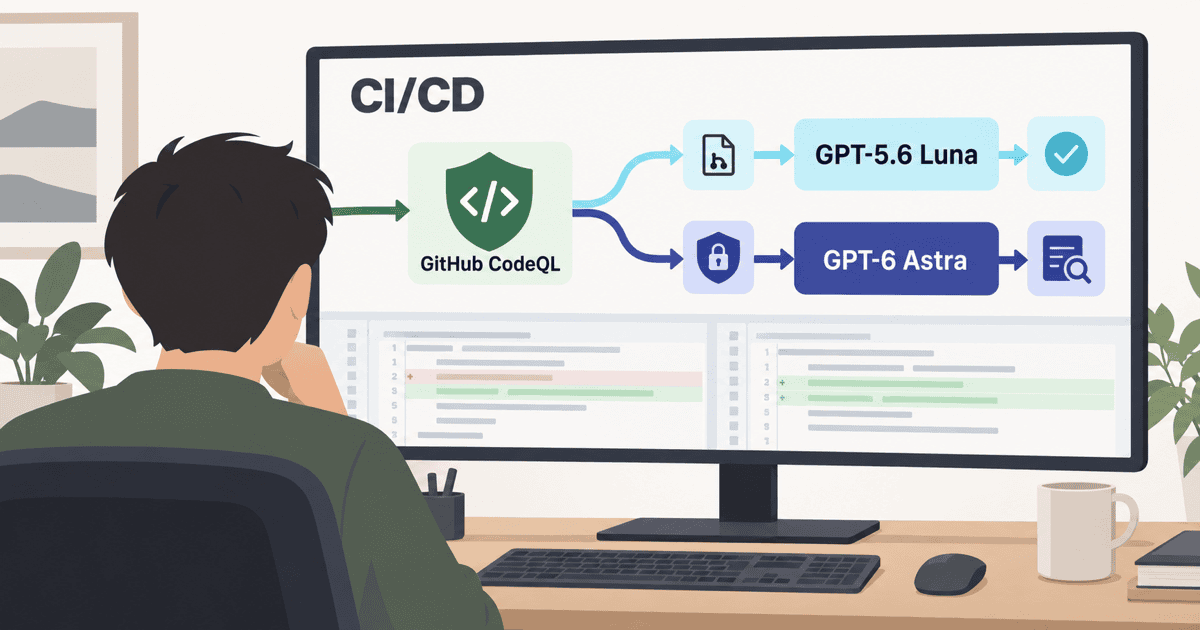
すべてのコードレビューを単一の高機能モデルに任せる運用は、費用対効果の面で合理的ではありません。そこで推奨されるのが、変更リスクに応じてモデルを振り分ける「二段階ルーティング」です[19]。日常的な軽微な変更は低コストなLunaで確認し、セキュリティや認証など高リスクな領域のみをAstraへ回します[20]。これにより、費用を抑えつつ重大欠陥の見逃しを減らせる可能性がありますが、実運用での検証が必要です。
また、AIツールは既存の自動化ツールや人間の承認プロセスを置き換えるものではありません。GitHub CodeQLなどの静的解析(実行せずにコードを検査する手法)で、規則違反を機械的に遮断します[21]。さらに、AIはコメントによる助言にとどめ、最終的な統合承認は人間が判断する体制を維持することが大切です[22]。
開発規模と組織の役割で異なる導入インパクト
組織の規模や役割によって、二段階レビューの導入効果と留意点は異なります。個人開発者やスタートアップでは、安価なLunaの活用により全変更への網羅的な確認体制を構築できます[23]。ただし、誤検出による確認負荷を抑えるため、重大度に応じた通知の選別や出力フォーマットの定義が不可欠です。
一方、大企業ではレビュー精度に加えて、コンプライアンス(法令や社内規程への適合)管理も重要な論点になります。OpenAIのAPIでは、乱用監視ログは最長30日保持される場合があり、ログに顧客コンテンツが含まれる可能性があります[24]。そのため、セキュリティ責任者は機密コードの送信方針やデータ保持条件を事前に精査する必要があります[25]。さらに、AIモデルのバージョンやプロンプト(AIへの指示文)、人間の承認記録を監査ログ(操作や判断の記録)として一元管理する体制が求められます[26]。


