なぜ今か:単一ダイの物理限界と先端パッケージングの必然性
AIやクラウドなどの計算需要が急激に拡大しています。これに伴い、半導体パッケージング技術の役割は大きく変化しました。単なるチップの保護や配線を行う後工程ではなくなりました。製品の性能や電力効率、コストを左右するシステム設計要素となっています[1]。本記事では、TSMC・Intel・Samsungの先端パッケージングの違い、量産性、供給網を比較し、AIチップ開発の選定基準を解説します。
AIアクセラレーターは極めて大きなシリコン面積を必要とします。しかし、先端微細化プロセスでは製造コストの急増や歩留まりの悪化が課題となります[2]。ここでいう歩留まりとは、製造したチップ全体に占める良品の割合です。さらに、露光装置が一度に焼き付けられる上限面積である「レチクル限界(約800平方ミリメートル)」が、単一ダイの物理的な壁として立ちはだかります[3]。半導体ダイとは、ウェハーから切り出された個々のチップのことです。
Intelは、最新の多コアCPU実装において単一レチクルフィールド(約800平方ミリメートル)を超えるシリコン面積が必要になると説明しています[4]。欠陥密度が同じであれば、小型チップレットの方が大型ダイよりも高い歩留まりを得られます[5]。そのため、高性能コンピューティングでは大型ダイを分割して製造する手法が必要になります[6]。チップレットとは、機能を分割した小型チップのことです。
この分割設計はすでに実製品で採用されています。NVIDIAのBlackwell Ultraは、レチクル限界サイズのダイ2個を10TB/sのダイ間接続で結合しています[7]。これにより、単一のAIアクセラレーターとして動作させています。NVIDIA Blackwellも同様に、レチクル限界ダイ2個を10TB/sのダイ間接続で結んでいます[8]。
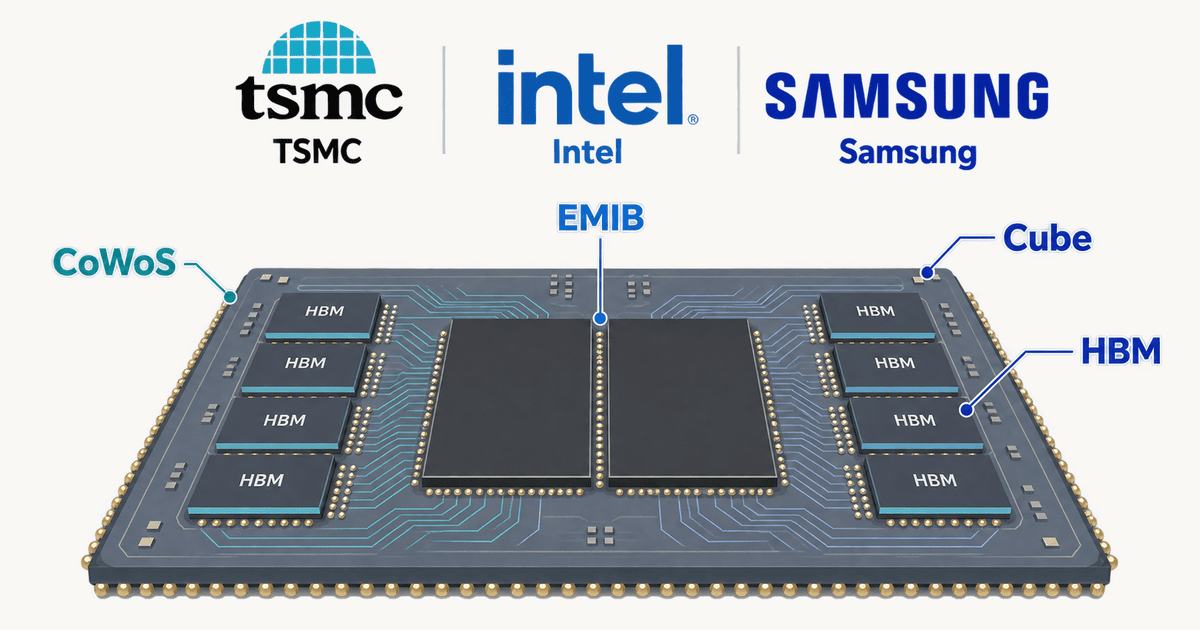
TSMC、Intel、Samsung Foundryの主要3社は、チップレット設計を先端パッケージングの中心に据えています。いずれも水平配置の2.5Dや垂直積層の3Dを用意しています。これらにより、複数の異種ダイを単一パッケージへ統合しています[9]。先端パッケージングとは、複数チップを高密度に結合する技術です。2.5Dは平面基板上で並べて接続し、3Dは上下に積み重ねて接続します。ただし、チップレット化によって自動的に低消費電力が実現するわけではありません。パッケージ内配線はオンチップ配線に比べて帯域やエネルギー効率で不利になり得ます。そのため、ダイ分割や配置、接続方式の協調設計が求められます[10]。
後輩AIチップの性能を高めるなら、最初から1枚の大きなチップとして作った方が速いのではないでしょうか?
先輩製造装置が一度に露光できる面積には約800平方ミリメートルという物理的な上限があるんだよ。
後輩製造装置の物理限界があるんですね。だから小さく分けてからつなぎ合わせる必要があるわけですか。
先輩その通りだね。ただ、分けたダイをつなぐパッケージ内配線は、チップ内部の配線よりも電力や帯域で不利になりやすいんだ。
後輩単に分割すれば解決するわけではなく、ダイ同士をいかに高密度に結ぶかが勝負になるんですね。
先輩まさにそこが各ファウンドリーによる先端パッケージング競争の焦点だよ。
何が起きたか:TSMC・Intel・Samsungの3大ファウンドリーによる技術体系比較
TSMCは、先端パッケージングの総合基盤として「3DFabric」を展開しています[11, 12]。同質・異種のチップレットを統合し、性能、電力効率、コストを最適化する狙いがあります。水平集積のCoWoS(Chip-on-Wafer-on-Substrate)やInFO、垂直積層のSoIC(System on Integrated Chips)で構成されています。
CoWoSの主力であるCoWoS-Sは、ロジックダイとHBM(高帯域幅メモリ)をシリコンインターポーザ上で接続します[13, 14]。CoWoS-Sは最大3.3倍レチクル(約2,700平方ミリメートル)のインターポーザサイズに対応します[15]。さらに大規模な構成には、CoWoS-RやCoWoS-Lが推奨されています。CoWoS-RはRDL(再配線層)インターポーザを用い、最小4マイクロメートルの配線ピッチを提供します[16]。RDL層や接合層が熱膨張係数の差を緩衝し、ひずみエネルギー密度を低減します[17]。
また、InFOは高密度RDLとTIV(貫通ビア)を用いるウェハーレベル統合技術です[18]。モバイルからネットワーク向けに優れたコスト性能を発揮します[19]。垂直積層のSoICは、CoW(Chip on Wafer)とWoW(Wafer-on-Wafer)の両方式に対応します[20, 21]。銅-銅接合とTSV(シリコン貫通電極)を組み合わせ、10マイクロメートル未満の微細ピッチで接続します[22, 23]。SoICで積層したダイは、さらにCoWoSやInFOへ組み込むことが可能です。
Intel Foundryは、独自の水平・垂直接続技術を確立しています。水平接続の2.5Dでは「EMIB(Embedded Multi-die Interconnect Bridge)」を展開しています[24]。基板内に局所的なシリコンブリッジを埋め込み、全面シリコンインターポーザなしでロジック間やHBM接続を実現します[25, 26]。インターポーザ型としては、シリコンインターポーザを用いる「Foveros-S」とRDL型の「Foveros-R」を提供しています[27]。Foveros-Sのマイクロバンプピッチは36マイクロメートルで、両方式ともオープン規格のUCIeに対応しています[28]。
垂直積層では「Foveros Direct 3D」を提供しています。これはアクティブなベースダイへCu-to-Cuハイブリッドボンディングで直接積層する技術です[29]。接続ピッチは10マイクロメートル未満を達成しています[30, 31, 32]。さらにIntelは、垂直Foverosと水平EMIBを組み合わせた「EMIB 3.5D」も開発しています[33]。またオープン規格のUCIeを活用し、異なるファウンドリーのダイを混載する設計を支援しています[34]。
Samsung Foundryは、異種集積パッケージングを「Cube」体系として提供しています[35]。水平統合の2.xDでは、シリコンインターポーザの「Cube-S」、RDLにシリコンブリッジを埋め込む「Cube-E」、RDLの「Cube-R」を用意しています[36, 37]。量産可能なCube-Sは、3.3倍レチクル基板上の標準構成で先端ロジックと最大8個のHBMを統合可能です[38, 39]。8個を超える大型構成も対象としています。高帯域幅、低遅延、反り制御を重視した設計です[40, 41]。
垂直積層の3D領域では、TSVと熱圧着接合を用いる量産ルートの「3D Cube-T」を提供しています[42]。次世代ルートとして、バンプレスCuハイブリッド接合を採用した「3D Cube-H」を開発中です[43, 44]。Cube-Hは6マイクロメートル未満の接合を開発中です。さらにSamsungは、HBMコントローラーをベースダイへ統合するカスタムHBMの開発も進めています[45]。
| ファウンドリー | 水平集積(2.5D / 2.xD)技術 | 水平インターポーザ構造・主な仕様 | 垂直積層(3D)技術 | 垂直接合方式・ピッチ仕様 |
|---|---|---|---|---|
| TSMC | CoWoS-S / CoWoS-R / CoWoS-L / InFO | CoWoS-S:シリコンインターポーザ(最大3.3倍レチクル、約2,700mm²) CoWoS-R:RDLインターポーザ(最小4μm配線ピッチ) | TSMC-SoIC(CoW / WoW) | 銅-銅接合+TSV(ボンドピッチ10μm未満) |
| Intel | EMIB / Foveros-S / Foveros-R | EMIB:基板埋め込み局所シリコンブリッジ Foveros-S:シリコンインターポーザ(バンプピッチ36μm、UCIe対応) Foveros-R:RDLファンアウト型(UCIe対応) | Foveros Direct 3D / EMIB 3.5D | Cu-to-Cuハイブリッドボンディング(ピッチ10μm未満) EMIB 3.5DはFoverosとEMIBを統合 |
| Samsung | Cube-S / Cube-E / Cube-R | Cube-S:シリコンインターポーザ(3.3倍レチクルでHBM最大8個。8個超は大型構成) Cube-E:RDL+埋め込みシリコンブリッジ Cube-R:RDLインターポーザ | 3D Cube-T / 3D Cube-H | Cube-T:TSV+熱圧着接合(量産対応) Cube-H:バンプレスハイブリッドCu接合(6μm未満、開発中) |
後輩3社とも水平と垂直の両方を用意していますが、構造上の違いはどこにあるんですか?
先輩チップの下に全面シリコンインターポーザを敷くか、必要な箇所だけに局所ブリッジを埋め込むかで思想が分かれているよ。
後輩全面にシリコンを敷く方式と、部分的に埋め込む方式があるわけですね。
先輩そうだね。TSMCのCoWoS-SやSamsungのCube-Sは全面シリコンを活用し、IntelのEMIBやSamsungのCube-Eは局所ブリッジを使う構造だよ。
後輩3D積層の接合技術でも、従来の突起を使う方式と金属同士を直接くっつける方式で世代が分かれていますね。
先輩その通りだよ。ハイブリッドボンディングによって10マイクロメートル未満の超微細ピッチが実現し、配線密度が高まっているんだ。
何が変わるか:インターポーザ構造・熱設計・歩留まり管理のトレードオフ
先端パッケージングの採用は、単に集積度を高めるだけではありません。配線密度、コスト、放熱性能、歩留まり管理の間で複雑なトレードオフが発生します。
まず、インターポーザ構造によるトレードオフが存在します。TSMCのCoWoS-Sに代表される全面シリコンインターポーザは、極めて高い配線密度を持ちます。しかし、サイズは最大3.3倍レチクル(約2,700平方ミリメートル)までに制約されます。それ以上の拡張にはCoWoS-LやCoWoS-Rが推奨されています[46]。同一方式で無制限に大型化できるわけではありません。
これに対し、TSMCのCoWoS-Rは柔軟なポリマーと銅を用いたRDLインターポーザを採用しています。C4バンプ層やアンダーフィル層が熱膨張係数の差を緩衝します。これにより、ひずみエネルギー密度を低減し、大型パッケージの反りや接合信頼性を緩和する選択肢となります[47]。
IntelのEMIBは、基板内に局所的なシリコンブリッジを埋め込む手法です。全面インターポーザを使わないため、部材コストを抑制できます。Intelの公式比較資料によると、EMIBブリッジのウェハー利用率は90%に達します。これに対し、全面Si/RDLインターポーザの利用率は60%にとどまります。これにより、インターポーザ費用を抑え、ウェハー利用率を高める利点が示されています[48]。
SamsungのCube-Sは、3.3倍レチクルのシリコンインターポーザ上で最大8個のHBMを統合可能です。しかし、HBM数の増加はインターポーザ面積の拡大、熱対策、反り設計と連動します[49]。一方、SamsungはCube-Rを低コスト志向の選択肢として説明しています。全面シリコン級の密度を必要としない設計では、コストと量産性のトレードオフを取りやすいとされています[50]。
垂直3D積層では、熱密度と量産性のトレードオフがより厳しくなります。Samsungの3D Cube-Hは6マイクロメートル未満のバンプレス接合を開発中ですが、微細化に伴う量産成熟度との兼ね合いが課題となります[51]。熱管理に関して、Samsungは水平配置が熱蓄積の管理に適すると説明しています。TSMCは3D積層の主要課題に熱を挙げています。Intelは高熱密度製品に熱制御付き検査を導入しています。微細な垂直接続による帯域向上の反面、熱密度やテスト負荷が課題になり得ます[52]。
歩留まり管理の面でも重大な変化が起きています。小型チップレット化により、単一大型ダイに比べてダイ単体の歩留まりは向上します。しかし、ダイ数や接合箇所の増加に伴い、組立歩留まりとのトレードオフが指摘されています。そのため、チップレット化だけで最終パッケージの歩留まりが自動的に改善するわけではないと分析されています[53]。
この問題に対し、各社は組み立て前のダイ選別や多段階テストを提供しています。事前に「既知良品ダイ(KGD)」を選別する手法が重視されています。TSMCは工程内テストを重視し、Intelは熱制御テストや最終システムレベルテスト(SLT)を導入しています。また、Samsungも各種試験体制を提供しています。積層が複雑になるほど、早期検出の重要性が増す可能性があります[54]。Intelではウェハーソートから最終テストまでの試験体系や、シンギュレートダイテストを提供しています[55, 56]。
後輩小さなダイに分ければ歩留まりが上がってコストも下がる、と単純に考えてよいのでしょうか?
先輩ダイ自体の歩留まりは上がっても、組み立て工程や接合箇所が増えることで別のリスクが生じるんだよ。
後輩1つのパッケージに複数のダイを集める以上、不良ダイが含まれるとパッケージ全体の歩留まりやコストに影響してしまいますね。
先輩その通りだね。さらに垂直に積み重ねると熱が逃げにくくなり、放熱設計やテスト設備の負担も重くなるんだ。
後輩だからこそ組み立てる前の厳格なダイ選別や熱管理テストが、重要な工程や負担になるわけですね。
先輩そうした検査体制を自前や提携先でしっかり確保できるかが、製造の成否を分けるんだよ。
供給網の現状:量産実績・巨額投資・OSATエコシステムの囲い込み
TSMCではAI需要を背景にCoWoS能力が逼迫し、OSATを含む組立・テスト能力が制約になり得ます。主要3社は巨額の設備投資を進めるとともに、外部OSAT(半導体組立・テスト受託企業)や部材メーカーとの提携体制を強化しています。
TSMCは、CoWoS-Sを長年量産してきた実績を持ちます。2023年にCoWoS-R、2024年にCoWoS-Lを量産へ移行させました。大型レチクル製品は2026年に量産開始が見込まれています[57]。2026年時点で5.5倍レチクルのCoWoSを生産中であり、2028年には約10個の大型演算ダイと20個のHBMスタックを統合する14倍レチクル版の量産を計画しています[58]。
製造拠点として、TSMCは台湾に最大の先端バックエンド拠点「Advanced Backend Fab 6」を開設しました。敷地面積14.3ヘクタールを誇り、年間100万枚超の12インチ換算3DFabric処理能力と、年間1,000万時間超の試験能力を備えています[59]。同社のCEOは、CoWoS能力を2023年から2024年に2倍超とし、2024年から2025年にも2倍以上へ増やす意向を示しました。同時に、全体供給にはOSATパートナーとの協業が必要だと説明しています[60, 61]。TSMCの全社設備投資は2025年実績で408億9,500万ドルであり、2026年は520億〜560億ドルを見込んでいます[62]。
さらにTSMCは「3DFabric Alliance」を組織しています。メモリーでMicron、Samsung Memory、SK hynix、OSATでAmkor、ASE、SPIL、STATSChipPAC、基板でIBIDEN、Toppan、Unimicronと連携しています[63]。米国ではAmkorと協業し、アリゾナ州ピオリアの拠点でCoWoSやInFOのターンキー受託を提供する計画です[64]。ただし、AI需要に対する自社容量は非常に逼迫した状態と説明されており、HBMや基板、OSATの供給余力が実質的な制約になり得ると指摘されています[65]。
Intel Foundryは、100製品を超える2.5D製品の量産実績を公表しています[66, 67, 68]。全ファウンドリー合計の3倍に達する2.5D能力を持つと自社評価しています[69]。最大でレチクル限界の6倍、113×116ミリメートルの大型パッケージ実績を掲げています。EMIBは2017年から、Foveros-Sは2019年から量産されています。新しいFoveros-Rは2027年の量産準備段階とされています[70]。
Intelの先端パッケージ拠点は、米国ニューメキシコ、マレーシア、ベトナム、コスタリカに分散しています[71]。ニューメキシコ州Rio RanchoのFab 9には35億ドルを投資し、2024年1月に開設しました[72]。マレーシアPenangでは70億ドルを投じた3D先端パッケージ拠点を建設中ですが、立ち上げ時期は市場環境に連動する方針へ変更されました。Intelの2025年純設備投資は112億400万ドル、2026年の設備投資コミットメントは91億ドルです[73]。Intelは自社ASATと外部OSATの双方を選択可能にしています。Amkorとの提携により、EMIB組立を韓国、ポルトガル、米国へと拡大しています[74]。同社はFCxGA基板等の最大単独購入者と説明していますが、サプライヤー名の網羅的な開示は行っていません[75]。
Samsung Foundryは、3.3倍シリコンインターポーザ上に最大8個のHBMを統合するCube-Sを量産可能としています。8個を超えるHBM構成も提供しています[76]。2023年時点で国内外のHPC顧客から複数受注を獲得し、ロジック、HBM、2.5Dパッケージを組み合わせるターンキーサービスの生産開始を予定していました[77]。Samsungは2022年にX-Cubeについて、マイクロバンプ型を2024年、バンプレス型を2026年に量産可能とするロードマップを示しました[78]。
Samsungの製造網は、韓国(Giheung、Hwaseong、Pyeongtaek)と米国(Austin、Taylor)に展開しています[79]。米国Taylorクラスターには370億ドル以上の投資を計画しており、2026年の暫定稼働を目指しています[80]。Samsung Electronicsの2025年設備投資は52.7兆ウォンで、DS部門が47.5兆ウォンを占めました[81]。Samsungは「MDI Alliance」を通じてワンストップのターンキーサービスを提供しています。社内製造に加え、Amkor、JCET、ASE-Kr、Hana MicronをOSATとして起用しています。さらにPCB容量を長期契約(LTA)で事前確保しています[82]。2026年7月にはBroadcomとのMOUを締結し、HBM供給と2nm先端パッケージでの協業を開始しました[83]。ただし、基板容量の事前確保が必要な点は、依然として供給制約が存在することを示しているとみられます[84]。
| ファウンドリー | 量産実績・最大規模 | 主な製造拠点・投資動向 | 提携エコシステム・外部OSAT |
|---|---|---|---|
| TSMC | ・CoWoS-Sは長年量産、CoWoS-R(2023年)、CoWoS-L(2024年) ・2026年に5.5倍レチクル生産中、2028年に14倍レチクル(ダイ10個、HBM20個)計画 | ・Advanced Backend Fab 6(敷地14.3ha、年100万枚超の処理能力) ・全社設備投資:2025年408.95億ドル、2026年見通し520億〜560億ドル | ・3DFabric Alliance(メモリ3社、OSAT4社、基板3社) ・米国アリゾナ州でAmkorと協業 |
| Intel | ・2.5D製品を100超量産 ・最大6倍レチクル(113×116mm) ・EMIBは2017年から、Foveros-Sは2019年から量産 | ・ニューメキシコ州Fab 9(35億ドル投資、2024年開設) ・マレーシアPenang(70億ドル投資、立ち上げは市場連動) ・2025年純設備投資112.04億ドル | ・自社ASATおよび外部OSATの選択制 ・Amkor提携で韓国・ポルトガル・米国へEMIB組立を拡大 |
| Samsung | ・Cube-S(3.3倍レチクル、HBM最大8個、8個超向け構成あり) ・マイクロバンプ型3D(2024年)、バンプレス型(2026年予定) | ・韓国拠点および米国Taylorクラスター(370億ドル超投資計画、2026年稼働目標) ・2025年設備投資52.7兆ウォン(DS部門47.5兆ウォン) | ・MDI Allianceによるワンストップ・ターンキー提供 ・外部OSAT:Amkor、JCET、ASE-Kr、Hana Micron ・PCB容量を長期契約(LTA)で事前確保 |
後輩ファウンドリーを比較するとき、回路の微細化だけでなく組み立て能力まで見る必要があるのはなぜですか?
先輩TSMCではCoWoSやOSAT能力がAI向け供給の制約要因になっていると説明されているからだよ。
後輩前工程でウェハーを順調に作れても、パッケージングの枠が足りなければ完成品として出荷できないわけですね。
先輩その通りだね。だから各社は自社工場の増設だけでなく、外部のOSATや基板メーカーと提携して供給網を囲い込んでいるんだ。
後輩自社設備だけで完結させず、パートナー企業まで含めたエコシステム全体の供給余力を見極める必要があるんですね。
先輩まさにそこが、実務上の納期や調達リスクを左右する重要な判断基準になるよ。
誰に影響するか:AIチップ開発者が直面するファウンドリー選定基準
先端パッケージングの進化は、AI半導体を開発する設計者に直接影響を及ぼします。各ファウンドリーには異なる強みがあり、最適解は一律には定まりません。
量産競争力について、公開情報からはTSMCの供給力が目立ちますが、比較可能な実績データは限定的です[85]。HBMを大量に搭載する大規模アクセラレーターにおいて、量産成熟度を最重視する場合に有力な選択肢となります。
Intel Foundryは、100超の2.5D量産実績に加え、自社ASATとAmkor提携による複線化を進めています。特にUCIeなどのオープン規格を用いた異種チップレット接続を支援しています。異なるファウンドリーで製造されたロジックやメモリの混載が可能です。過去にはAlteraがSK hynixのHBM2をStratix 10 FPGAへ統合した実製品例もあります[86]。マルチファウンドリー構成を志向する設計者に適しています。
Samsung Foundryは、先進ロジック、メモリ、パッケージングを一体提供するターンキーサービスを展開しています[87]。ウェハー製造から先端パッケージ、マルチフィジックス解析、各種試験までを含むターンキーサービスを提供しています[88]。メモリとロジックの一括調達やリードタイム短縮を狙える可能性があります。Cubeシリーズによる熱やコストの選択肢も豊富です。
このように最適解が一律に決まらない理由は明確です。要求されるHBMの搭載数、許容される熱抵抗やパッケージ面積、コスト予算、さらに他社製チップレットを混載するかどうかによって、最適な選択肢が根本から分かれるためです[89, 90]。チップ開発者には、単なる接続密度だけでなく、熱対策やテスト体制、基板供給網までを含めた総合的な見極めが求められます。
後輩結局のところ、どのファウンドリーのパッケージング技術を選ぶべきなのでしょうか?
先輩一律に1つの正解があるわけではないんだよ。HBMの搭載数や発熱の許容量、調達の柔軟性によって選ぶべき相手が変わるからね。
後輩単一ファウンドリーにすべて任せるのか、他社のダイも混ぜて柔軟に調達するのかでも分かれますね。
先輩その通りだね。量産実績を重視するのか、オープン規格による混載を狙うのか、垂直統合のワンストップを選ぶのかという設計思想の違いだよ。
後輩単なる回路技術の優劣ではなく、製品全体のシステム要件と供給体制をすり合わせて選定する必要があるわけですね。
先輩まさに半導体の競争軸が、プロセスの微細化からパッケージングを含めた総合設計へとシフトした証拠だね。