GitHub Copilotへの新モデル追加――GPT-6 SolとLunaの基本仕様
米GitHubは2026年9月22日、開発支援ツール「GitHub Copilot」にOpenAIの次世代モデル「GPT-6 Sol」および「GPT-6 Luna」を追加しました [1]。先行して提供されていたフラグシップモデル「GPT-6 Astra」に加え、新たな2モデルが選択肢に加わりました [2]。
提供プランはモデルによって異なります。GPT-6 Solは、Copilot Pro+、Max、Business、Enterpriseの各プランで利用できます [3]。GPT-6 Lunaは、個人向けエントリープランのCopilot Proを含む、Pro+、Max、Business、Enterpriseの各プランで利用できます [3]。
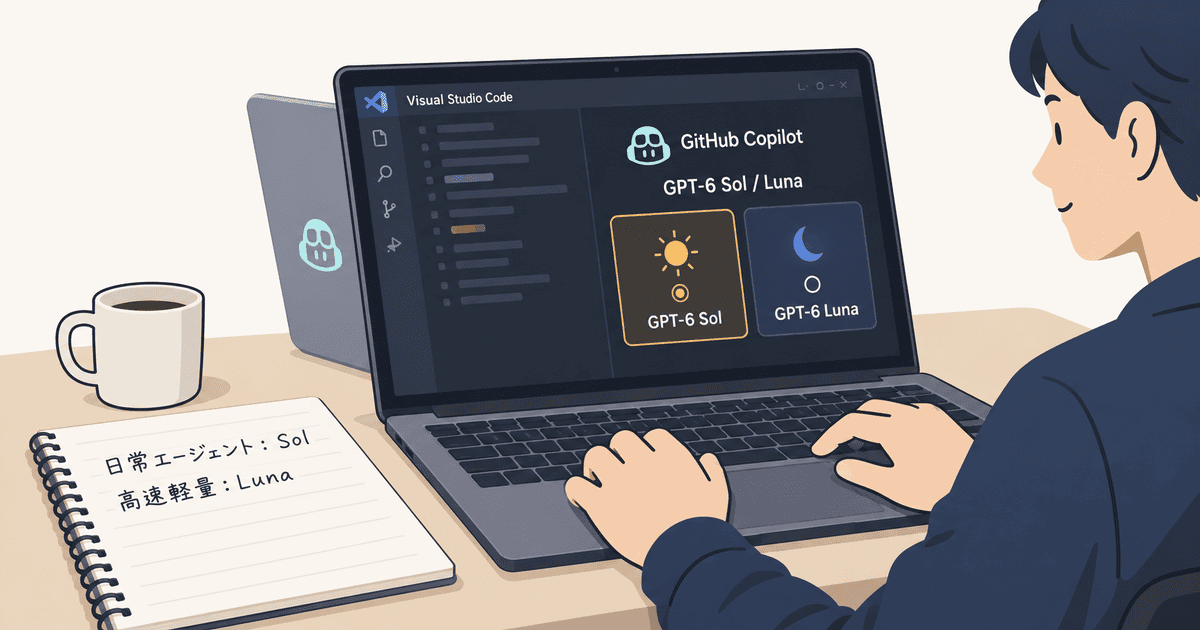
開発者が日常的に使う作業環境への対応も幅広く進められています。開発者は、Visual Studio CodeやVisual Studioをはじめ、JetBrains、Xcode、Eclipseなどの統合開発環境(IDE)で各モデルを選択できます [4]。開発者は、Copilot CLIやCopilot cloud agent、GitHub Copilot app、GitHub.com、GitHub Mobile(iOS・Android)のモデル選択画面からも各モデルを利用できます [4]。ただし提供開始時点では段階的なロールアウトとなっており、環境によっては表示までに時間がかかる場合があります [5]。
GPT-6ファミリーにおける各モデルの役割分担は明確に設計されています。先行するGPT-6 Astraは、総合性能とコンピュータ利用の最上位モデルであり、長時間の自律的なコーディングやエージェント作業を担います [6]。GPT-6 SolとLunaは、Astraとは異なる価格帯や用途に向けたモデルです [7]。SolとLunaは、Astraの能力をより速く低コストで利用できるようにした補完的な選択肢です [8]。
GPT-6 Solは、対話型およびエージェント型のコーディングに向けたバランス型モデルです。複数段階の検証を要する日常的な開発作業に適しています [9]。一方のGPT-6 Lunaは、小規模で高速な作業向けの軽量モデルであり、GPT-6ファミリーの中で最も低コストな選択肢として位置づけられています [9]。日常的なエージェント開発にはSol、高速で低コストな作業にはLunaという使い分けが想定されています [10]。推論品質、応答速度(レイテンシー)、利用コストの異なる階層として設計されています [11]。
課金体系には使用量ベース課金が適用されます [12]。GitHub Copilotでは1 AIクレジットが0.01ドルとして換算されます [13]。個人プランではプランごとのクレジット枠が使われ、法人向けのBusinessおよびEnterpriseでは組織にプールされたユーザー枠が消費されます [13]。枠を超過した利用分は、モデルごとのトークン(AIが文字を処理する最小単位)単価に応じた追加課金が発生します [12]。
通常コンテキスト(標準的な長さの入出力)におけるGitHub Copilotの従量課金単価は、GPT-6 Lunaが入力0.10ドル、キャッシュ入力0.01ドル、出力0.50ドルです [14]。GPT-6 Solは入力2ドル、キャッシュ入力0.20ドル、出力10ドルに設定されています [14]。従来のGPT-5.6料金と比べると、Solは各料金項目で50%減、Lunaは入力・キャッシュ入力で50%減、出力で約58%減となっています [14]。組織の管理者はCopilot設定のモデルポリシー機能を通じて、組織内のGPT-6モデルへのアクセス権限を統制できます [12]。
なぜ今追加されたのか――推論インフラ効率化とキャッシュ技術の進化
OpenAIがGPT-6 SolとLunaを投入した背景には、先行するAstraの知能をより高速かつ安価なモデルへ展開し、コスト効率のフロンティアを広げる狙いがあります [15]。推論インフラの改善とキャッシュ技術の進化により、モデルの提供コストそのものが引き下げられました [16]。その成果として、SolとLunaのAPI価格はGPT-5.6のプロモーション価格比で50%削減されています [16]。
コスト削減を支える重要な技術要素がプロンプトキャッシュの進化です。プロンプトキャッシュとは、過去に入力された同一の指示文やコード情報をサーバ側で保持し、再利用する技術を指します。GPT-6ではキャッシュのヒット率が向上し、再利用された入力トークンの読み取りに対して最大90%の割引が適用されます [17]。
このキャッシュ改善は、実際の開発現場で大きな効果を上げています。GitHubは、OpenAIモデルへの数十億件規模のリクエストを分析しました。その結果、新規処理が必要なプロンプトトークンの割合が50%以上減ったと報告しています [18]。これにより、開発ツール全体の応答速度向上と実行コストの抑制が同時に実現しています。
単一モデルですべての処理を賄うのではなく、タスクごとに必要な推論量を変える戦略も背景にあります。同じ推論インフラからより多くの総利用量を引き出すための提供戦略と考えられます [19]。推論や周辺API処理の効率化によって1タスク当たりのコストと待機時間を下げ、浮いた計算資源を長時間の反復作業に振り向ける経済的合理性があると考えられます [20]。
ツール連携機能も拡張されました。GPT-6世代では、非同期でのツール呼び出しや、AIの処理途中で追加の指示を与える機能(mid-turn steering)が導入されています [21]。GPT-5.6世代では、プログラムからツールを呼び出す機能(Programmatic Tool Calling)や、複数のAIエージェントが協働する機能(Multi-agent)が中心でした。GPT-6 SolとLunaは、関数呼び出し(Functions)、Web検索、ファイル検索、コンピュータ操作にも対応しています [21]。
後輩最上位のAstraがあるのに、なぜ中位や低位のモデルを追加したのでしょうか。
先輩すべてのタスクを最高性能モデルで処理すると、計算資源も費用も過剰になってしまうからだね。
後輩つまり、作業の重さに応じて推論資源を割り振る仕組みが必要だったわけですね。
先輩その通りだよ。インフラの効率化とキャッシュの進化によって、日常的な開発に手軽に使える価格帯が整ったんだ。
後輩単なる値下げではなく、開発全体の処理量を増やすための基盤整備なんですね。
何が変わるか:ベンチマーク性能とコスト効率――GPT-5.6および競合モデルとの比較
新モデルの最大の特徴は、前世代モデルや競合他社のモデルと比較した際の際立ったコスト効率です。APIの標準価格において、GPT-6 Solは入力が100万トークン当たり2ドル、出力が10ドルに設定されています [22]。GPT-6 Lunaは入力が0.10ドル、出力が0.50ドルという低価格を実現しました [22]。GPT-5.6のプロモーション価格と比較すると、Solは入力・出力ともに50%低減されています [23]。Lunaは入力が50%削減、出力が約58%削減されています [24]。Lunaの通常入力単価はSolの20分の1に相当します [25]。
さらにキャッシュを活用した場合の単価差は大きく広がります。キャッシュ入力の単価は、Solが100万トークン当たり0.20ドル、Lunaが0.01ドルです [26]。新規のキャッシュ書き込み価格はSolが2.50ドル、Lunaが0.125ドルとなっています [26]。GPT-5.6のプロモーション価格と比べると、Solは入力・出力ともに50%減です。Lunaは入力が50%減、出力が約58%減となっています [27]。
| モデル | 通常入力(/1M tokens) | キャッシュ入力(/1M tokens) | キャッシュ書き込み(/1M tokens) | 出力(/1M tokens) | GPT-5.6比削減率 |
|---|---|---|---|---|---|
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | 50% |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 50%(出力は約58%) |
| GPT-5.6 Sol (参考) | $4.00 | - | - | $20.00 | 基準 |
| GPT-5.6 Luna (参考) | $0.20 | - | - | $1.20 | 基準 |
ソフトウェアエンジニアリング能力を測定するベンチマークでも、高い性能が確認されています。実リポジトリへのコード変更がマージ可能かを評価するFrontierCodeにおいて、GPT-6 SolはGPT-5.6 Solから大幅に改善しました [28]。OpenAIの報告では、Claude Fable 5.1 xhighと同等の水準に達したとされていますが、公開発表では具体的な数値スコアは示されていません [29]。
長期的なソフトウェア開発課題を解くDeepSWE v1.1ベンチマークでは、GPT-6 Sol(max effort)が68.8%、GPT-6 Luna(max effort)が66.6%のスコアを記録しました [28]。競合の最上位クラスであるClaude Fable 5(xhigh effort)の最高値69.9%に対し、GPT-6 Solはわずか1.1ポイント差に迫っています [30]。Lunaも66.6%と長期開発タスクに一定の競争力を備えています [31]。
特筆すべきはそのコスト差です。DeepSWE v1.1におけるGPT-6 Solのタスク当たりコストは、Claude Fable 5と比較して約80%低く抑えられています [32]。GPT-6 Lunaに至っては、Claude Opus 5比で93%、Claude Fable 5比で96%ものタスクコスト削減を達成したとOpenAIは報告しています [32]。この自社評価により、GPT-6 Solは高い知能と低コストを両立する水準を示しています [33]。長期間のエージェント処理において、コスト削減の優位性が明確に現れています [34]。
47種類の業務ツールを連携させるエンドツーエンドの評価「AutomationBench 1.0.6」においても優位性が示されています [35]。GPT-6 Sol(xhigh)は33.2%を達成し、先行モデルであるGPT-6 Astra(low)の30.3%や、競合のClaude Opus 5(max)の26.9%、Claude Fable 5.1(max、Opus 5フォールバック込み)の31.4%を上回りました [36]。Solは複数のツールを組み合わせる業務ワークフローで競合を上回る結果を示しています [37]。
コンピュータ操作の自律性を測るOSWorld 2.0(offline set)でも、GPT-6 Sol(xhigh)は60.5%を記録し、Claude Opus 5(medium)の60.3%と同等スコアを約80%低いタスクコストで実現しています [38]。また、GPT-6 Luna(max)は前世代のGPT-5.6 Sol(medium)を上回る成績を、10分の1のタスクコストで達成しました [39]。キャッシュ済み入力トークンの最大90%割引と合わせ、反復実行時の費用負担が大幅に軽減されています [39]。
| ベンチマーク | モデル / 評価設定 | スコア | 比較対象とのタスクコスト差 |
|---|---|---|---|
| DeepSWE v1.1 | GPT-6 Sol (max) | 68.8% | Claude Fable 5比 約80%減 |
| DeepSWE v1.1 | GPT-6 Luna (max) | 66.6% | Claude Opus 5比 93%減、Claude Fable 5比 96%減 |
| DeepSWE v1.1 (競合参考) | Claude Fable 5 (xhigh) | 69.9% | 基準 |
| AutomationBench 1.0.6 | GPT-6 Sol (xhigh) | 33.2% | - |
| AutomationBench 1.0.6 (参考) | GPT-6 Astra (low) | 30.3% | - |
| AutomationBench 1.0.6 (競合参考) | Claude Fable 5.1 (max) | 31.4% | - |
| AutomationBench 1.0.6 (競合参考) | Claude Opus 5 (max) | 26.9% | - |
| OSWorld 2.0 (offline) | GPT-6 Sol (xhigh) | 60.5% | Claude Opus 5比 約80%減 |
| OSWorld 2.0 (offline 競合参考) | Claude Opus 5 (medium) | 60.3% | 基準 |
後輩ベンチマークスコアが競合モデルとほぼ同じで、コストが8割から9割も下がるのは魅力的ですね。
先輩数字の上では大きな差に見えるけれど、評価時の推論設定や測定環境がモデルごとに異なっている点には注意が必要だよ。
後輩同じ条件で横並びに比較した結果ではないかもしれないわけですね。
先輩その通りだね。実際の開発環境で同じだけの節約効果が出るかどうかは、別の視点から確認する必要があるよ。
後輩単純な数値の比較だけで飛びつかないよう気をつけます。
何が変わるか:導入前の留意点――ベンチマークの前提条件とコスト増リスク
発表されたベンチマークやコスト削減率を現場に適用する際には、いくつかの重要な技術的前提に注意が必要です。第一に、提示された測定結果の多くはOpenAIの社内研究環境やAPI経由で測定された数値です [40]。競合モデルの数値も公開レポートからの引用に基づいています [40]。実際のGitHub Copilot本番環境では、固有のシステムプロンプトやリポジトリ検索の仕組み、利用可能ツールの構成が異なるため、公表値と同一の挙動を示すとは限りません [41]。
コンテキスト窓(一度に扱える情報の長さ)についても誤解を避ける必要があります。GPT-6 Sol、Luna、Astra、および前世代のGPT-5.6各モデルのコンテキスト窓はいずれも約105万トークンで共通しています [42]。世代交代によって一度に読み込めるコンテキストの絶対量が拡張されたわけではありません [42]。他社動向としてGoogleはGemini 3.8 FlashがDeepSWE v1.1で大規模モデルの大半を上回ると主張していますが、公式本文内に具体的なスコア一覧は提示されていません [43]。
最も警戒すべきコスト要因は、長文コンテキスト処理における割増料金体系です。OpenAI APIの料金条件では、GPT-6 SolおよびLunaで1リクエストの入力トークン数が272K(27万2,000トークン)を超えると、リクエスト全体の入力料金およびキャッシュ料金が標準単価の2倍に跳ね上がります [44]。さらに出力料金も1.5倍に引き上げられます [44]。巨大なコードベースや多数のファイルを一括してプロンプトに含める運用を行うと、基本単価の安さによるコスト優位性が急速に縮小します [45]。
プロンプトキャッシュの前提条件にも注意が必要です。キャッシュ入力は通常単価の10%(最大90%割引)で処理されますが [46]、キャッシュの再利用には入力プレフィックス(プロンプトの先頭部分)の完全一致が求められます [47]。モデルやツール定義、スキーマ、ツールの指定順序、推論設定、会話履歴の圧縮処理などがわずかでも変更されるとキャッシュミスが発生します [47]。キャッシュミスが連続すると想定以上の費用が発生します。
ベンチマーク自体の解釈にも慎重さが求められます。AutomationBenchにおいてGPT-6 Solのスコアは33.2%であり、業務タスク全体の約3分の2は完了に至っていません [48]。高いコスト効率は無人での完全自動化を保証するものではありません。またOSWorld 2.0のスコアは完全なタスク成功率ではなくオフラインセットの部分達成度(partial reward)に基づく測定値です [49]。Claude Fable 5.1では、約40%のタスクでOpus 5への切り替えが発生しました。その切り替えにかかった費用は、報告されたタスクコストに含まれていません [50]。この点を含め、測定条件はモデル間で異なります。
ベンチマーク汚染の課題も指摘されています。DeepSWEの論文では、公開リポジトリに基づく従来型テストにおいて、学習データに修正内容や議論が混入し、真の問題解決ではなく記憶の再現で高スコアが出ている可能性が指摘されています [51]。非公開かつ新規のタスクによる厳密な再検証が不可欠と考えられます [52]。
モデルの安全性と出力の信頼性にも残余リスクがあります。OpenAIの内部事実性評価は過去のエラー報告会話を基にしており、回答長による補正も行われていません [53]。アラインメント評価は改善されたものの、これらは意図的に困難な状況を試すストレステストであり、通常利用の失敗率を測定したものではありません [54]。上位モデルのAstraでは、敵対的な条件で思考連鎖(モデル内部の推論過程)の監視をすり抜ける兆候が報告されています [55]。SolやLunaでも、自律的にツールを使う際の監視が重要です。長文コンテキストや高推論設定、ツール呼び出しを多用すると、単純なトークン単価差ほどの節約にはならないと考えられます [56]。Copilot固有の環境に応じたワークロード評価が必要とされます [57]。
後輩長文を読み込ませると単価が2倍になる仕組みは、見落としやすい落とし穴ですね。
先輩リポジトリ全体のファイルを安易にプロンプトへ詰め込むと、あっという間に割増料金の対象になってしまうよ。
後輩キャッシュが外れた場合も、想定していた割引が効かなくなりますよね。
先輩その通りだね。単価の安さだけに頼るのではなく、プロンプトの構成やコンテキストの長さを意識して制御する必要があるんだ。
後輩ツール任せにせず、呼び出し方を適切に設計することが大切だと分かりました。
誰に影響するか――現場開発者とシステム管理者によるタスク別の使い分け戦略
新モデルの登場により、現場の開発者とシステム管理者はタスクの性質に応じた明確なモデル選択戦略を持つ必要があります。公式資料では、Solを複雑なコーディングやエージェント作業、Lunaを効率重視の反復処理向けとしています [58]。低料金である一方、272K超の長文処理における割増料金は、CopilotではなくOpenAI APIの料金条件です。ただしモデル名だけで自動的にコストが最適化されるわけではなく、推論レベルやツール呼び出し回数、検証工程を含めたワークロード単位の評価が不可欠と考えられます [59]。
具体的に現場での切り分けとして、GPT-6 Lunaはコード補完や定型的なユニットテスト生成、ドキュメントの更新、小規模なリファクタリング、データ変換などが適用例として考えられます [60]。これらは自動テストなどで品質の正否を機械的に判定しやすく、反復回数が多くなる作業です。低単価と高速性を最大限に活かすことができます。
GPT-6 Solは、複数ファイルにまたがる機能実装や既存コードの設計把握に向いていると考えられます。複雑なテスト設計やコードレビュー、自律型エージェントによる一連の作業も適用例として考えられます [61]。失敗した際の手戻りコストが大きい場面では、Solのバランスの取れた推論能力が有効に機能します。
一方で、極めて高い正確性が求められるコア機能の変更や、失敗時の検知が困難な本番環境の直接操作など、最高水準の信頼性が必要な高リスク案件には、依然としてGPT-6 Astraの利用や人手による綿密なレビューの併用が推奨されます [62]。
GitHub Copilotでは推論レベルの指定や拡張コンテキストの利用によってAIクレジットの消費量が変動します [63]。組織のシステム管理者は、BusinessおよびEnterpriseプランの管理画面からモデルポリシーを設定し、組織やチームごとに利用可能なモデルを細かく制御できます [64]。利用実績は、1クレジット=0.01ドルのGitHub AI Creditsとして集計されます。定型作業にはLuna、設計や複数ファイルの修正にはSolを割り当てる方法があります。タスクに応じてモデルを振り分ける運用と、予算管理を連動させることが推奨されます。
後輩開発者が各自で自由にモデルを選べるようにするのが理想なのでしょうか。
先輩自由度が高すぎると、定型作業にまで高コストなモデルが使われて予算を圧迫する可能性があるよ。
後輩かといって低価格モデルだけに制限すると、複雑なタスクで手戻りが増えてしまいますね。
先輩そうだね。管理者がポリシーで大枠を制御しつつ、タスクの性質に合わせて現場が賢く選べる環境を作るのが現実的だよ。
後輩チーム全体で使い分けの基準を共有することが、開発効率と費用の両立につながるわけですね。