何が起きているか:プロンプト調整からコンテキスト全体の制御へ
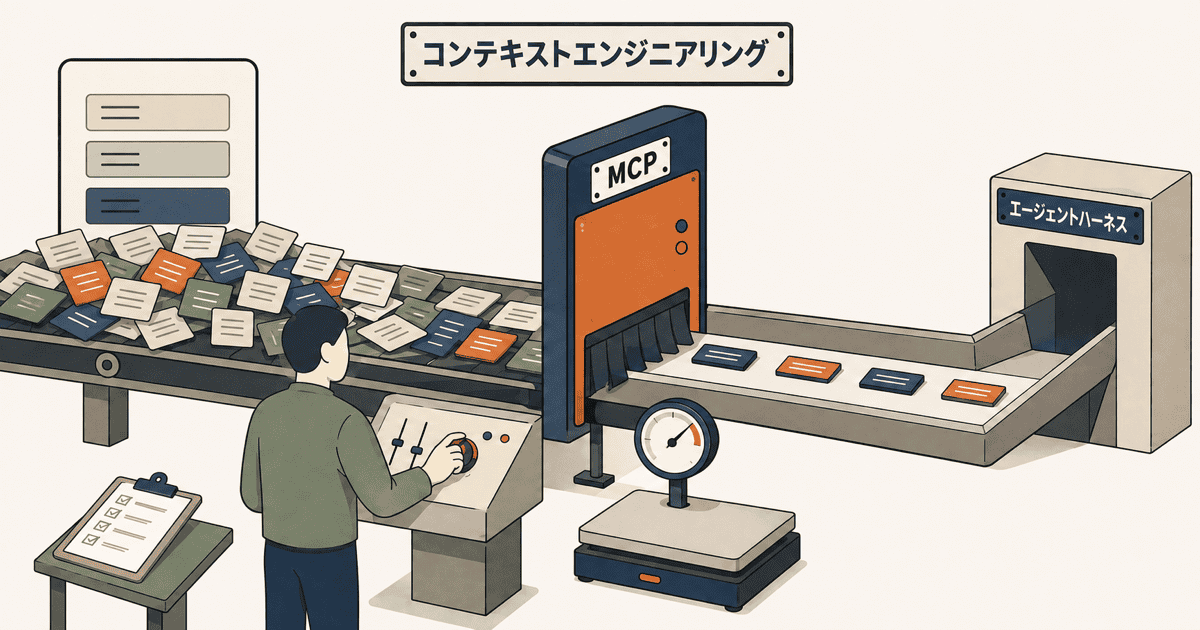
大規模言語モデル(LLM)を本番環境で活用する際、入力設計の焦点は単一の指示文から推論時の情報状態全体へと移っています。本番向けAIにおけるコンテキストエンジニアリングとは、モデルの推論時に目的達成へ最も有効な情報トークンの集合を選び、維持・更新するためのシステム設計を指します[1]。
これまでのプロンプトエンジニアリングは、主にLLMに対する指示文の書き方や構成の最適化を担ってきました[2]。これに対してコンテキストエンジニアリングは、システム指示やツール定義、外部データ、メッセージ履歴など、プロンプト以外も含む入力状態全体を対象とします[2]。米Anthropicも、コンテキストエンジニアリングを推論時に渡す情報トークン全体を選別・維持する設計であると説明しています[3]。
外部知識を取り込む手法としては、検索拡張生成(RAG)が広く知られています。RAGは外部知識を検索してモデルの入力に加え、回答を取得データに接地させる方式です[4]。コンテキストエンジニアリングの観点では、RAGは検索・取得領域を構成する代表的な実装形態に位置づけられます[4]。一般的なRAGは、質問に対する検索、関連文脈の追加、モデルによる回答生成という手順を踏み、外部知識によるグラウンディングを主な責務とします[5]。
一方、コンテキストエンジニアリングは単一のアルゴリズムというより、プロンプト設計や検索、ツール、履歴、メモリを束ねる上位の運用概念といえます。そのため、一部ではRAGや処理の連鎖(オーケストレーション)の再命名にすぎないという反論も存在します[6]。ただし公式の実装例では、ツールのオンデマンドな動的探索や、会話履歴を要約して圧縮するコンパクションまで扱っています[7]。そのため、RAG単体の言い換えにとどまらない広いシステム設計領域を指しています[7]。
後輩プロンプトを工夫することと、コンテキストを制御することは何が違うんですか?
先輩プロンプト調整は文章の書き方を磨く作業だね。でもコンテキストエンジニアリングは、ツールや履歴を含めた入力枠全体の交通整理をするシステム設計だよ。
後輩RAGの別名という見方もあるのに、なぜわざわざ新しい言葉を使うんでしょうか。
先輩検索して文章を足すだけでなく、ツールの動的発見や履歴の要約圧縮まで含めて管理する必要が出てきたからだね。
なぜ今か:長文脈化とエージェント化に伴う新たな限界
AIの活用形態は、単発の文章生成から、自律的に判断して行動するエージェントへと進化しました。エージェントは複数ターンの推論や外部ツールの実行、データ取得を繰り返します[8]。その結果、本番AIの入力は固定的なプロンプトではなく、ターンごとに選別と更新を重ねる動的なコンテキスト状態へ変化しました[8]。
しかし、コンテキストウィンドウは有限の計算資源です。情報を過剰に詰め込むと、トークン量の増加に伴って検索精度が落ちる現象や、不要な情報が混ざる情報汚染が生じます[9]。そのため本番品質を保つには、目的達成に寄与する高シグナルな情報を最小限に絞り込む設計が不可欠になります[9]。
モデルが扱える文脈長が拡大しても、入力情報を均等に利用できる保証はありません。関連情報が入力のどこにあるかによって性能は大きく変わります[10]。特に、入力の中央部に置かれた情報を取り出す性能が低下する傾向が確認されています[10]。始端や終端の情報は中央部より利用されやすいため、重要な目的や制約を大量の文書の真ん中に埋め込まない工夫が求められます[11]。オープンドメインQAの実験では、取得文書を20件から50件に増やしても性能向上は限定的であり、単に取得件数を増やすだけでは品質を改善できないことが示されています[12]。
また、指示文を極端に肥大化させると、直前のタスクやコード、関連文書をコンテキストから押し出してしまいます[13]。その結果、重要度の飽和や古い指示のドリフトを引き起こします[13]。長時間の対話ループでは、ツールの呼び出し結果や中間データが有限のコンテキスト枠を埋めてしまいます[14]。エージェントが1ターンで多数のツールを呼び出せば、それだけで枠を使い切る恐れもあります[15]。
長文脈モデルとRAGの比較研究では、十分な計算資源がある場合は長文脈モデルが平均性能でRAGを上回る一方、RAGには大幅に低コストであるという利点があると報告されています[16]。長文脈モデルであっても位置による性能劣化の問題は残るため、モデルの巨大化だけで情報の選別問題が解消するわけではありません[17]。非常に長い対話においては、長文脈モデルやRAGを用いても、時間関係や因果関係の長期的な理解は人間水準に大きく及ばない現状があります[18]。さらに、コンテキストを絞るためにツール呼び出しを細かく連鎖させると、推論回数が増えて遅延やコスト、エラーの新たな要因にもなります[19]。
後輩モデルのコンテキスト枠が広くなれば、関連資料をすべて入れれば解決すると思っていました。
先輩文章の中央にある情報を見落としやすくなるし、情報を増やすほど性能が上がるわけではないんだよ。
後輩では、単純に取得文書の数を増やしたり、枠を広げたりするだけでは不十分なんですね。
先輩その通りだよ。計算コストが跳ね上がる上に、ツールの実行結果で枠が溢れてしまうから、厳密な情報選別が必要になるんだ。
何が変わるか:本番運用を支える動的コンテキスト制御の設計手法
コンテキストの圧迫を防ぐため、本番運用では必要な情報だけを実行時に読み込む「Just-in-time(JIT)」方式が用いられます[20]。JIT方式では、すべてのデータを最初からコンテキストに配置せず、軽量な識別子だけを保持します[20]。そして実行時にツールを経由して必要なデータのみを取得します[20]。この方式は作業記憶を絞り込める利点がありますが、事前取得に比べて実行時の処理が遅くなり、探索方針が不適切だと不要な情報を生む欠点もあります[21]。
長時間のタスクを安定して継続するには、会話履歴を要約して新しいコンテキストへ引き継ぐ「コンパクション」や、外部ストレージに構造化メモリを保存して必要な項目だけ再注入する手法が有効です[22]。Anthropicのツール「Claude Code」の実装例では、コンパクションを実行した後の要約済みコンテキストに対し、直近でアクセスした5件のファイル情報を追加して作業を継続します[23]。ただし、事前の要約やコンパクションは将来必要になる細部を切り捨ててしまう不可逆な圧縮になるリスクや、初期の誤りを後続へ固定化させる危険を孕んでいます[24]。
動的制御の実装では、過去の類似質問への回答をLLM呼び出し前に返す「意味キャッシュ」を併用する設計があります[25]。意味キャッシュは推論コストと遅延を削減する手法ですが、認証や権限、鮮度条件、モデル版などをキーに含めるべきという意見があるものの、確立された標準仕様としては未検証です[26]。
記憶の管理においては、直近の会話を扱う短期記憶と、利用者の持続的な制約などを保持する長期記憶を分離し、関連する項目のみをコンテキストに再注入します[27]。外部ストレージをアプリケーション側で管理するJITメモリを採用すれば、全履歴の投入を避けて情報露出を抑制できます[28]。
RAG自体の高度化もコンテキスト設計に含まれます。文書の分割時に文脈が失われる失敗を防ぐため、埋め込み検索とBM25などの語彙検索を併用し、重複を排除して上位を絞る構成が有効です[29]。さらに、取得候補をモデルへ渡す前にクエリ適合度で並べ替える「再ランキング」を行うことで、回答精度を高められます[30]。また、小型モデルを用いて取得チャンクから質問に直結する原文スパンのみを抽出する「query-aware compression」を挟むことで、後段のモデルに渡すトークン量を大幅に圧縮できます[31]。
同時に、ツール自体の返却形式も重要な設計対象です[32]。ツールの出力は次の推論のコンテキストへ累積されるため、出力上限の設定や構造化、大きなデータの外部退避を組み込み、トークン消費と実行効率を管理する必要があります[33]。
後輩要約してコンテキストを小さくすれば、長時間の作業も安全に続けられるんでしょうか?
先輩要約は不可逆な圧縮だから、後で必要になる重要な詳細を削り落としてしまうリスクと隣り合わせなんだ。
後輩削りすぎても困るし、残しすぎても枠を圧迫するというジレンマがあるわけですね。
先輩だからこそ、識別子を使ったJIT読み込みや、質問に関係する箇所だけを抽出する圧縮技術を組み合わせるんだよ。
セキュリティと信頼性の課題:メモリ汚染・インジェクションと防御設計
外部データを取り込むエージェントシステムでは、取り込む文書やツール結果自体が新たな攻撃経路になります[34]。悪意ある第三者がWebページや外部データに不正な指示を埋め込むプロンプトインジェクションが発生すると、エージェントの行動が意図せず誘導される危険があります[35]。そのため、すべての入力内容を検査し、ガードレールや権限境界をあらかじめ設ける必要があります[36]。
防御の原則として、プロンプト、検索チャンク、ツール結果、メモリ書き込みは、信頼された命令ではなく単なる「データ」として扱う必要があります[37]。モデルに渡す前に検査やラベル付け、正規化、認可を実施し、指示とデータを明確に分離しなければなりません[37]。入力文字列のフィルタリングだけに依存した対策では攻撃を完全に防ぐことは困難です[38]。攻撃が成功した場合でも被害を抑えられるよう、最小権限の徹底やサンドボックス環境での実行、人による確認手順を組み合わせる多層防御が不可欠です[39]。
| 防御手法 | 評価サンプル数 | 攻撃成功率(防御前) | 攻撃成功率(多層防御後) | 偽陽性率 | 中央値レイテンシー |
|---|---|---|---|---|---|
| 三層RAG防御フレームワーク(出典に基づく実証研究) | 5,080 サンプル | 71.4% | 11.3% | 4.8% | 61.2 ms |
arXivで報告された三層RAG防御の実証研究では、5,080件のサンプルにおいて、攻撃成功率を71.4%から11.3%へ低下させ、偽陽性率4.8%、中央値レイテンシー61.2ミリ秒を達成した例が示されています[40]。
ツールの実行権限においても厳格な制限が求められます。モデルが生成する引数を無条件に信頼せず、許可リストや型、パス境界で検証し、データの変更や外部送信などの高リスク操作は人の承認を必須とすべきです[41]。情報漏えいはチャットの出力だけでなく、URLのクエリパラメータやリダイレクトを介しても発生し得ます[42]。そのため、エージェントが自動取得できるURLを公開インデックスで照合し、未検証URLの取得にはユーザーの明示的な操作を要求する設計が推奨されます[43]。さらに、ファイル参照IDなどをユーザー入力から直接受け取るとテナント横断の漏えいにつながるため、サーバー側で厳格に管理する必要があります[43]。
長期メモリの導入は、持続的な攻撃リスクももたらします。研究手法「MemoryGraft」では、通常のデータ取り込み経路を悪用して悪意ある成功体験を長期メモリに埋め込み、類似タスク実行時に再取得させることで、セッションをまたぐ持続的な行動異常を引き起こせることが示されました[44]。また、過去の誤った経験に従うことで判断が悪化する現象も報告されています[45]。これらを抑えるには、メモリの保存期間や信頼度を管理し、定期的な再検証や版管理、差分確認、異常時のロールバック手順を整備する必要があります[46]。
同時に、監査ログそのものの取り扱いにも注意を払う必要があります。開発時の詳細ログを本番環境で有効にすると、個人情報や関数呼び出しの引数が漏えいする恐れがあるため、機密情報のマスキングやアクセス制限を施す必要があります[47]。
後輩入力チェックを厳しくすれば、外部データからの乗っ取りは防げるんじゃないですか?
先輩文字列のフィルタリングだけでは不十分だと分かっているよ。外部の文章は命令ではなくデータとして隔離して扱う必要があるね。
後輩メモリ機能を入れると、過去のセッションに仕込まれた悪意がずっと残り続ける危険もあるわけですね。
先輩その通りだね。だからメモリの版管理やロールバック手順を用意して、汚染された記録を切り離せるようにしておくんだよ。
誰に影響するか:関係者の役割と法規制への対応
コンテキストエンジニアリングの実装は、システム開発や運用に携わる関係者の役割にも影響を及ぼします。ただし、職務責任の具体的な分担は企業の組織構造によって大きく異なり、一概に断定することはできません[48]。
アプリケーション開発においては、単一プロンプトの調整から、ツールや外部データを含む入力状態全体の選別・更新を設計する作業への広がりが指摘されています[49]。データ基盤担当者にとっても、RAGは単なるベクトルデータベースの設置にとどまらず、文書の解析や埋め込み、アクセス権限のメタデータを付与したデータパイプラインの管理が論点となります[50]。セキュリティ担当者には、入力制限だけでなく、ツールの読み書き権限の分離や、高リスク操作を人間が承認するフローの策定が求められます[51]。
また、欧州連合(EU)のAI規制法(EU AI Act)をはじめとする法規制への対応も重要な要件です。同法では、高リスクAIシステムに対して適切なログ記録と人間の監視体制を義務付けています[52]。ここで注意すべき点は、システムの「提供者(Provider)」と、それを導入して運用する「配備者(Deployer)」で法的義務が異なる点です[53]。
| 区分 | ログ機能・保持期間の義務 | 人間監督および通知義務 |
|---|---|---|
| 提供者(Provider) | システムの稼働期間を通じてイベントの自動記録を技術的に可能にし、提供者の管理下にあるログを目的に応じて少なくとも6か月保持する義務を負います[54]。 | 意図した目的を変更して高リスクAIに大幅改変した第三者も、提供者としての義務を負う場合があります[56]。 |
| 配備者(Deployer) | 適用法令に別段の定めがない限り、配備者の管理下にある自動生成ログを少なくとも6か月保持する責任を負います[55]。 | 適切な訓練と権限を持つ人を監督者に任命し、運用の監視を行います。また、職場で導入する際は従業員代表や対象者に事前通知する義務を負います[56]。 |
高リスクAIの人間監督を担当する者には、AIの出力を鵜呑みにしてしまう自動化バイアスを認識し、必要に応じて出力を無視、上書き、あるいはシステムを停止できる権限と能力が求められます[57]。現場の担当業務も、AIの出力をそのまま受け取る形から、業務文脈に合わせて出力をレビューし、高リスクな操作を人の手で引き継ぐ工程へと変化していきます[58]。
本番AIの評価においては、モデル単体の回答精度だけでなく、ツール選択やメモリ取得、遅延、トークン消費、コスト、エラー発生率などを含めたシステム全体の実行軌跡を総合的に測定していく必要があります[59]。
後輩開発者が全部責任を持つのかと思っていましたが、組織や法律によって求められる役割が分かれているんですね。
先輩提供者と配備者でログの保持義務も明確に分かれているし、責任の所在は組織の設計次第で変わるよ。
後輩現場でAIを使う側も、AIの出した答えをただ受け取るだけでは法的に不十分になる場合があるわけですか。
先輩出力を盲信せず、必要なら上書きや停止ができる権限を持った人間が監督することが法律上も求められているんだね。