#LLM
CLM:長い作業でAIが入力文脈を整理する仕組み
CLMはAI自身で作業文脈を編集し、次の入力へ反映する研究手法です。既存の要約・外部メモとの差、著者の精度・演算量評価、公開コードの制約を整理します。
PDFの隠し文字:AIが読む内容と表示を照合する
履歴書PDFの表示と抽出文字を比べるHCD・VDAの仕組みを解説。検出割合と適合率の条件、OCRや代替テキストの用途、誤検知と処理の限界を確認します。
AstaBrief 8B:引用付きレポートの仕組みと限界
AstaBrief 8Bの生成工程とSFT・DPOの評価値を比較。速度の測定範囲、引用の限界、PDF入力と外部通信、成果物ごとのライセンスを整理します。
単一スコア依存から脱却へ、AI評価の実行条件開示が開発と選定を変える
英AI安全研究所とEvalEvalはAI評価の再現性向上に向け共有インフラの利用を発表しました。新基準「EEE」による実行条件の記録と、関係者が直面する課題を整理します。
文章を書かないAI「Jev」登場 型付き判断と並列評価で高速化
米TypeSafe AIが発表した「Jev」は、文章を生成せず型付き判断と確率のみを返す新モデルです。70〜500ミリ秒という高速応答の理由やRLCDの仕組み、問い合わせ分類や承認ゲートなど業務自動化での具体的なユースケースを整理します。
AlibabaがAIレビューCLI公開、低誤検知で一次選別を担う
AlibabaはAI支援コードレビューCLI「OpenCodeReview」をオープンソースとして公開しました。決定論的なルール処理とLLMの推論を組み合わせ、高い適合率とトークン削減を実現します。急増するAI生成コードに対する一次トリアージの仕組みを整理します。
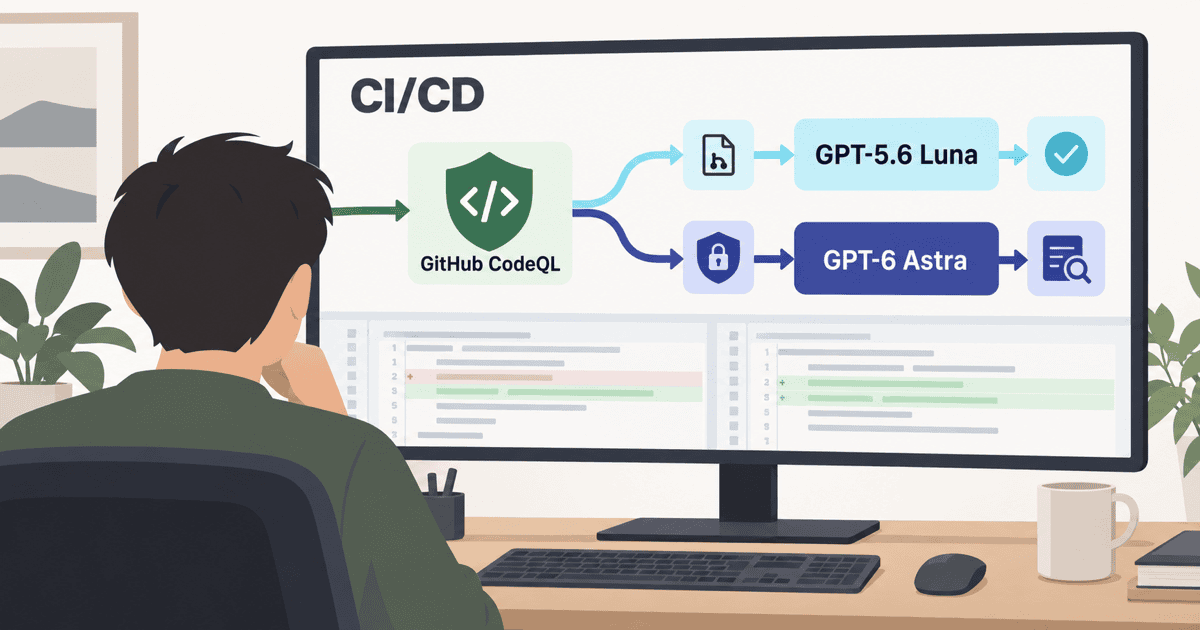
AIコードレビューは二段階運用へ LunaとAstraの比較から導く実務解
GPT-5.6 LunaとGPT-6 Astraのコードレビュー性能比較実験を解説。28倍の費用差と検出精度のトレードオフを検証し、日常的な変更と高リスク領域を切り分ける実践的な二段階運用の指針を示します。
AIの純粋な計算力を測る「LamBench」の仕組みと評価の限界
純粋ラムダ計算でAIの計算能力を測定する新ベンチマーク「LamBench」が登場しました。最小言語Lambを用いた課題構成や正規形一致による判定の仕組み、現行指標の課題を解説します。
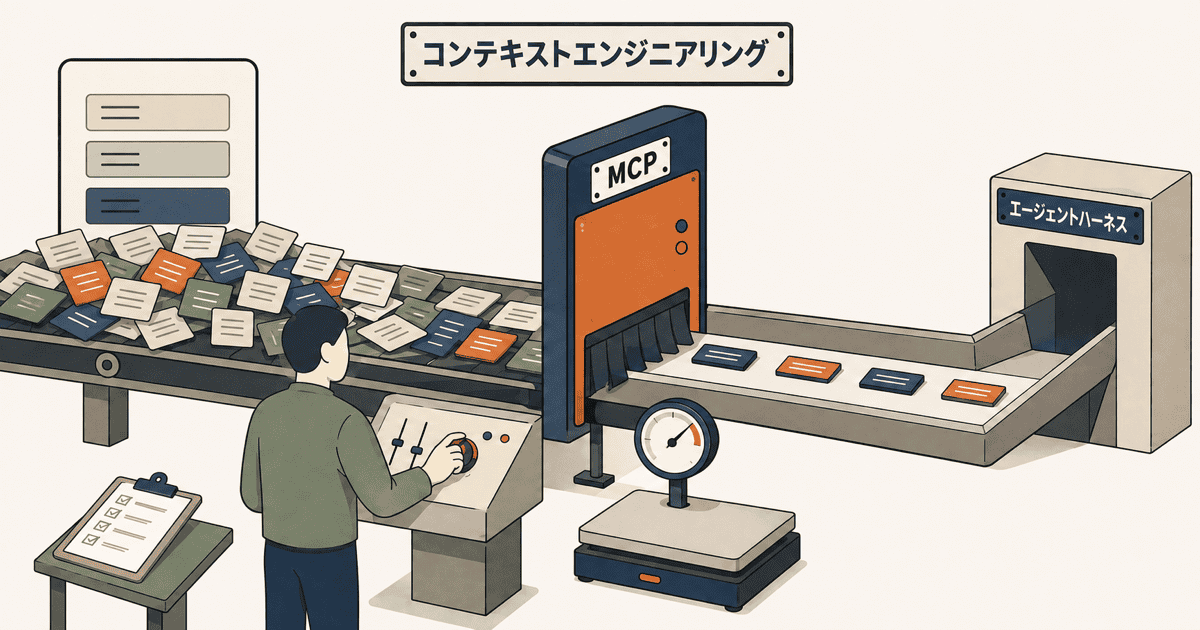
プロンプト調整から推論時の入力全体を動的に制御する設計へ
本番環境でAIを安定稼働させるコンテキストエンジニアリングを解説。プロンプト調整やRAGとの違い、長文脈化に伴う限界、動的な情報制御、メモリ汚染への防御策、EU AI法などの法的要件まで体系的に整理します。
LLMの内部に自発的な記号構造を発見、因果介入でも9割が成功
深層ニューラルネットやLLMの内部表現には古典的記号構造であるTPRが自発的に創発しているのか。構造同定手法「DISCOVER」の実験結果や因果介入の成功率、解釈可能性やモデル設計への影響と注意すべき限界を解説します。
MacかGPUか:動かしたいモデル規模で決めるローカルLLM機材選び
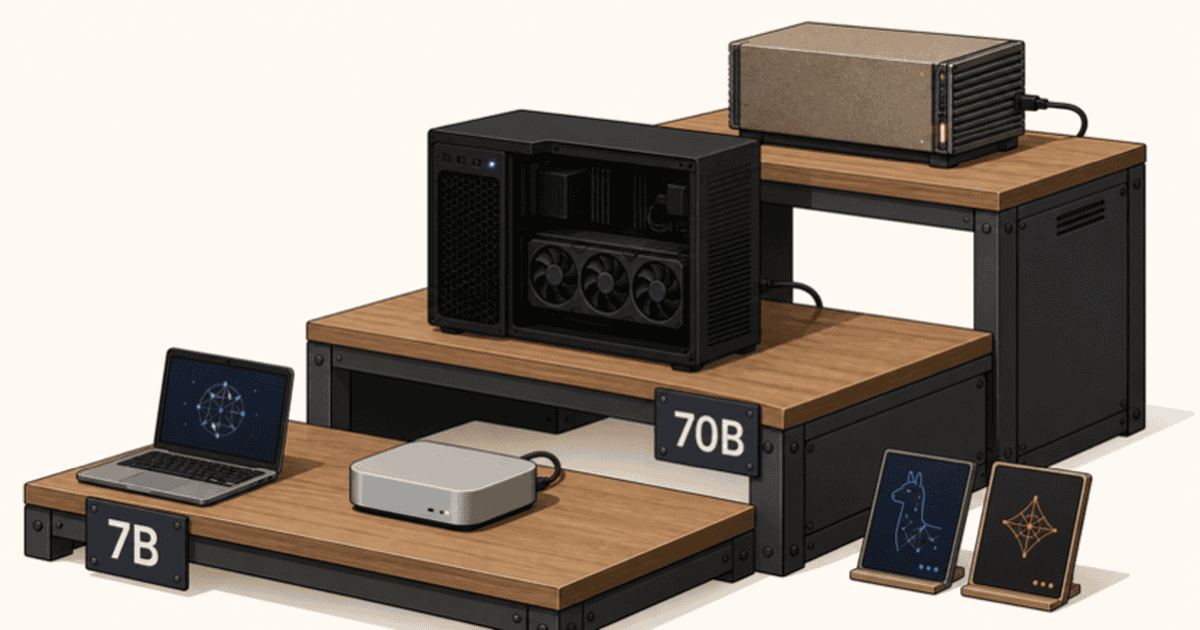
個人向けローカルLLM環境の構築ガイド。メモリ容量と量子化・モデル規模の計算基準から、Mac mini/Studio、RTX 5090、Ryzen AI、DGX Sparkの価格・仕様、推論ランタイムの最適化手法まで体系的に解説します。
PC資源を統合しMoE推論を高速化するFreeTokenの仕組み
コンシューマー機で大規模MoEモデルの推論を効率化する推論エンジン「FreeToken」が登場しました。帯域測定に基づくCPU・GPU協調実行(q*)や状態再利用の仕組み、実測性能と導入要件を解説します。
コード生成から自律実行へ進むエージェント開発と検証の役割
Simon Willison氏が提唱する「Agentic Engineering」を解説。コード生成から自律的な実行・検証ループへの進化、Red/Green TDDやGit連携の実践、セキュリティや組織の課題まで専門的に紐解きます。
DoorDashが挑むリアルタイムAIモデレーションの舞台裏
DoorDashが公開したリアルタイムAIモデレーション基盤「SafeChat」を解説。テキスト、画像、音声に対応する多層アーキテクチャや低遅延処理の仕組み、事案50%減の成果とプライバシー等の課題を整理します。