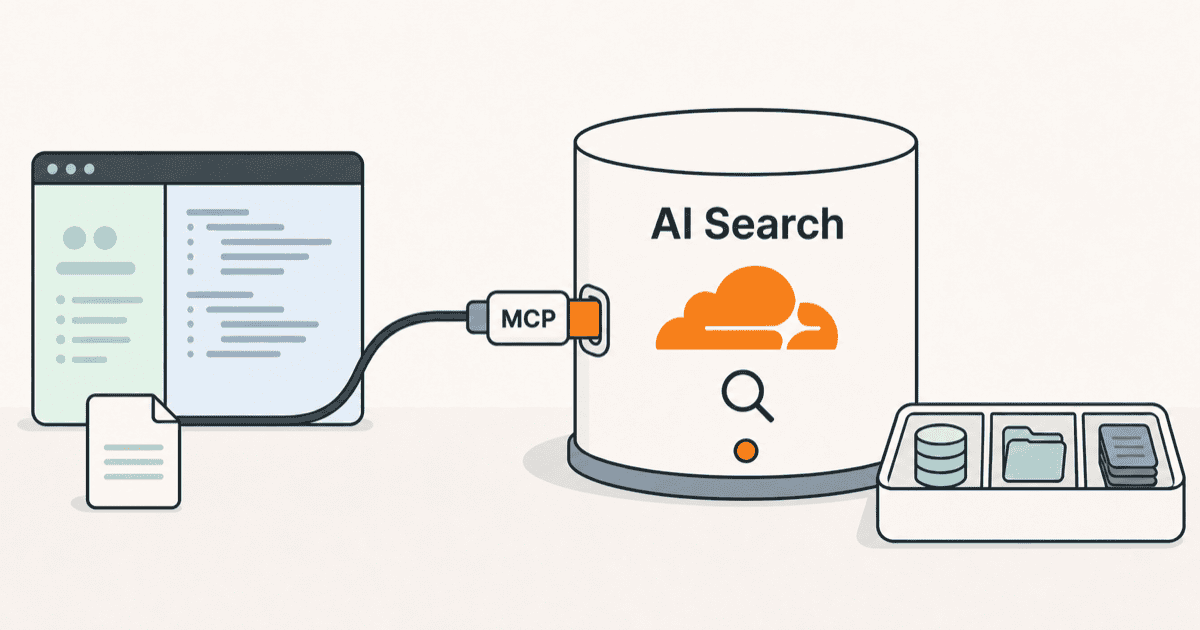
Cloudflareは自社サービスを個別に組み合わせていた検索基盤を刷新し、クロールから検索までを自動処理する「AI Search」の提供を拡大しました[1]。組み込みストレージやModel Context Protocol(MCP)エンドポイントを備え、エージェントやアプリへのデータ連携を簡素化します[2, 7]。本稿では機能の全体像と移行における注意点を解説します。
何が起きたか:AutoRAG改め「AI Search」の提供拡大
Cloudflareは、従来の「AutoRAG」の名称を「AI Search」に改め、提供範囲を拡大しました[9]。AI SearchはAutoRAGとは別系統の新製品ではなく、後継として位置づけられています[9, 28]。従来のAutoRAG向け旧REST APIやWorkersのenv.AI.autorag()バインディングは引き続き動作します[9, 28]。ただし、今後追加される新機能や機能改善は、新しいAI Search APIおよび新バインディングに対してのみ提供されます[9, 65]。
提供形態としては、全プランに向けてオープンベータとして提供されています[10, 54]。ベータ期間中、AI Searchの本体機能は定められた制限の範囲内であれば無料で利用可能です[10, 58]。ただし、推論を担うWorkers AIやAI Gatewayの利用料金は別途課金される仕組みになっています[10, 58]。
この発表の中心は、開発者体験の拡張にあります。従来はWorkers AI、AI Gateway、Vectorize、R2、Browser Runといった複数のプリミティブを開発者が個別に配線していました[1, 38]。AI Searchでは、クロール、取り込み、埋め込み、検索までを一連の管理された体験としてまとめて処理できるようになっています[1, 38]。
後輩AutoRAGから名前が変わっただけなら、わざわざ移行しなくてもいいんでしょうか。
先輩既存のAPIも動き続けるから、急いで移行しなくてもシステムは止まらないよ。
後輩じゃあ、新しい名前空間や新APIに切り替える理由はどこにあるんですか?
先輩新しい機能や改善が新APIにしか追加されないからだね。今後新しいパイプラインの機能を使うなら、設定やレスポンスの形式変更に対応して移行する必要があるよ。
なぜ今か:MCP対応とエージェント連携基盤への需要
背景には、外部ツールやモデルと接続するための標準プロトコルへの需要があります。Anthropicが導入したオープン標準であるModel Context Protocol(MCP)は、AIアシスタントをデータが存在する外部システムと接続する規格です[40]。2025年12月時点で公開MCPサーバーは1万を超え、各種ツールへの採用が報告されています[41]。OpenAIもResponses APIでリモートMCPサーバーに対応し、外部データへの接続を可能にしました[42]。Claudeなどのアシスタントが外部の組織知識を文脈として検索するユースケースも登場しています[43]。
Cloudflareは2026年3月にMCPと公開エンドポイントに対応しました[39]。各AI Searchインスタンスには組み込みMCPエンドポイントが用意されています[7, 53]。外部のAIアシスタントや統合開発環境(IDE)は、個別に検索コードを書くことなくsearchツールを呼び出せます[7, 21, 53]。
さらに、2026年7月にはCloudflare Agents SDKやVercel AI SDK、LangChain向けの連携ガイドが追加されました[48]。AI Searchの提供対象は、検索基盤を構築したい従来のアプリ開発者にとどまりません。社内知識を探索するAIエージェントや、テナントやエージェントごとにファイルを管理・検索するユースケースまで広く想定されています[3, 44]。
後輩MCPエンドポイントが標準で用意されていると、アプリ側の作りはどう変わるんですか?
先輩開発者が検索用のAPIラッパーを自前で実装しなくても、MCP対応のクライアントから直接検索ツールとして呼び出せるようになるよ。
後輩外部から直接呼べるということは、接続の安全性をどう担保するかという別の課題が出てきませんか?
先輩その通りだね。エンドポイントが公開された状態だと誰でも検索できてしまうから、認証やアクセス制御をどう挟むかを開発者自身が考える必要があるよ。
何が変わるか:個別配線から自動索引・検索パイプラインへ
初期のAutoRAGでは、主にCloudflare R2をストレージとして利用していました[2]。ウェブページを取り込む際も、Browser Renderingで取得したコンテンツを一度R2に保存して連携する構成が必要でした[2]。一方、現在のAI Searchインスタンスには、R2とVectorizeを基盤とするストレージとベクトル索引が組み込みで備わっています[12, 46]。
これにより、外部リソースを個別に準備することなく、ファイルを直接アップロードして検索を開始できます[2, 12]。自前のRAG基盤では、埋め込み生成、Vectorizeへの登録、検索後の元データ取得といった連携処理を自前で構築する必要がありました[26]。AI Searchは低レベルのベクトルデータベースであるVectorizeを内包し、取り込みから検索までを自動処理します[27, 47]。
取り込みパイプラインでは、アップロードされた文書をMarkdownへ変換し、チャンク化と埋め込みを自動的に実行します[14, 45]。画像ファイルに対しても、物体検出とキャプション生成を用いてMarkdown化が行われます[32]。検索時は、意味の近さを捉えるベクトル検索と、完全一致に強いBM25によるキーワード検索を並列に実行するハイブリッド検索が標準で利用されます[16, 29]。二つの結果はRRF(Reciprocal Rank Fusion)またはスコアの高い方を採用する方式で融合されます[29]。
検索の精度を高めるため、検索前のクエリ書き換えや、一次検索後の再ランキング処理をパイプラインに追加することも可能です[30, 31]。生成までCloudflareに委ねる場合は、/chat/completionsエンドポイントを呼び出すことで、検索結果をコンテキストに含めた回答を単一の呼び出しで生成できます[17]。
多様なデータソースへの対応と取り込み仕様
AI Searchが対応するデータソースは、インスタンスの組み込みストレージ、所有ドメインのウェブサイト、Cloudflare R2バケットの3種類です[4, 25]。構造化データから非構造化データまで幅広く取り込めます[4]。取り込み可能な形式にはMarkdown、JSON、YAML、PDF、画像、HTML/XML、Office文書(DOCX/XLSX)、CSVなどが含まれます[13, 52]。ただし、1ファイルあたりの最大サイズは4MBに制限されています[13, 33, 59]。
ウェブサイト連携は、同じCloudflareアカウントに登録済みの所有ドメインのみが対象となります[6, 15, 50]。インターネット上の任意のウェブサイトをクロールできるわけではありません[6, 37]。取り込み方式にはサイトマップ方式のほか、新たに「Discover」モードが用意されました[5, 51]。Discoverモードは開始URLからサイトマップとページ内リンクを辿って探索するため、サイトマップを持たないサイトでも索引化できます[5, 51]。
データの更新挙動はデータソースによって異なります[61]。組み込みストレージへのアップロードは即時に索引化が開始されます[14, 61]。一方、ウェブサイトとR2はスケジュールに沿って同期されます[56, 61]。サイトマップ方式は更新日のメタデータを参照して再取得しますが、Discover方式は固定のキャッシュ期間に基づいて巡回します[61]。なお、自社サイトであってもBot ManagementやWAF、Turnstileなどのセキュリティ設定によってクロールが遮断される場合があるため、事前の設定確認が必要です[62]。
後輩Discoverモードを使えば、サイトマップが整備されていない社内ポータルもそのまま取り込めますね。
先輩ただし、同じCloudflareアカウントにある所有ドメイン限定という制約があるよ。
後輩外部の公開ドキュメントを何でも巡回できるわけではないんですね。
先輩そうだね。さらに自社サイトでも、WAFやBot対策のルールに引っかかってAI Searchの巡回が遮断される可能性がある点にも注意が必要だよ。
誰に影響するか:開発者・運用者が直面する設計とセキュリティの責務
AI Searchが取り込みや検索を自動化しても、データやアクセスの設計責任は開発者に残ります[34]。特に留意すべき点はエンドポイントのセキュリティです。名前空間で公開エンドポイントを有効にすると、認証なしで到達可能な/searchおよび/mcpエンドポイントが即座に生成されます[8, 20, 63]。社内ナレッジを扱う場合、独自ドメインを割り当てた上でCloudflare Accessやサービストークンを前段に配置し、非公開化する設計が不可欠です[8, 22, 36, 64]。
マルチテナント環境のデータ分離設計も、開発者側が選択して実装する必要があります[35]。AI Searchでは、テナントごとに独立したインスタンスを作成してストレージと索引を分離する方式と、共有インスタンス内でメタデータフィルターを適用して検索対象を絞る方式の2種類が提供されています[18, 19, 49]。システムがテナント権限を自動で判別するわけではないため、要件に応じた分離設計が求められます[35, 60]。
既存のAutoRAG利用者にとっても対応事項が存在します。旧APIは継続して動作しますが、新しい機能や改善はAI Search APIと新しい名前空間バインディングにのみ追加されます[9, 28, 65]。新機能を取り入れる際には、設定構造やレスポンス形式、フィルター形式の変更に対応する必要があります[65]。
後輩ストレージや索引の構築が自動化されたなら、開発者の作業はほとんどなくなるんでしょうか?
先輩取り込みの配線は楽になるけれど、認証や権限分離の設計責任はそのまま残るよ。
後輩自動的にユーザーごとのアクセス制限がかかるわけではないんですね。
先輩その通り。公開URLの保護や、テナントごとのインスタンス分割かメタデータ絞り込みかの選択は、アプリ側で正しく設計しなければならないよ。
オープンベータの利用条件と一般提供後の予告価格
オープンベータ期間中は、定められたリソース制限の範囲内であればAI Search本体の利用料は無料です[10, 58]。ただし、埋め込みや回答生成に伴うWorkers AIの実行費用、およびAI Gatewayの利用料は別途請求されます[10, 23, 58]。
現在の制限値として、1アカウントあたりのインスタンス数はWorkers Freeで最大100、Workers Paidで最大5,000となっています[59]。1回のリクエストで横断検索できるインスタンス数は最大10、カスタムメタデータの属性数は1インスタンスあたり最大5フィールド、1ファイルのサイズ上限は4MBです[59]。
一般提供(GA)に向けて予告されている単価体系は以下の通りです[11, 24, 55, 57]。なお、選択されたWorkers AIモデルを使用する場合、埋め込みと再ランキングの処理費用は無料とされています[11, 24]。
| 項目 | 予告単価 | 単位 | 備考 |
|---|---|---|---|
| 基本取り込み(Base Ingestion) | 0.75 | 米ドル / 100万トークン | 一般提供後の予定価格 |
| 画像処理追加(Image processing add-on) | 0.50 | 米ドル / 100万トークン | 基本取り込みへの追加 |
| 保存容量(Stored data) | 2.00 | 米ドル / GB-month | ストレージ保持費用 |
| セマンティック検索(ハイブリッド・ベクトル) | 0.75 | 米ドル / 1,000クエリ | 選択モデルの埋め込み・再ランキング無料 |
| 全文検索(Full-text) | 0.10 | 米ドル / 1,000クエリ | BM25キーワード検索 |
自社システムへの導入や移行を検討する際は、これらの制限値と将来の課金体系を把握し、取り込みデータ量や想定される検索頻度に基づいた設計を進める必要があります[59]。
後輩ベータ期間中は無料だから、手軽に検証を進められますね。
先輩そうだね。ただ、Workers AIの推論コストはベータ中も別途発生する点には注意が必要だよ。
後輩本格運用を見据えると、予告されている将来の単価も計算に入れておく必要がありますね。
先輩その通りだね。取り込みトークン数や保存容量、検索回数に応じた試算を今のうちから確認しておくことが大切だよ。