なぜ今検証されたのか:ブラックボックス解明とTPR創発の発見
大規模言語モデル(LLM)をはじめとする深層ニューラルネットワークは、数値を並べた連続ベクトルで内部情報を表現します[1]。言語や数学、プログラミングコードといった構造的な課題で高い性能を示しています[1]。しかし、その内部機構が不透明なままでは、モデルが予期せぬ失敗をした際に原因を診断できません[2]。修正や安全性の認証を体系的に進めることも難しくなります[2]。
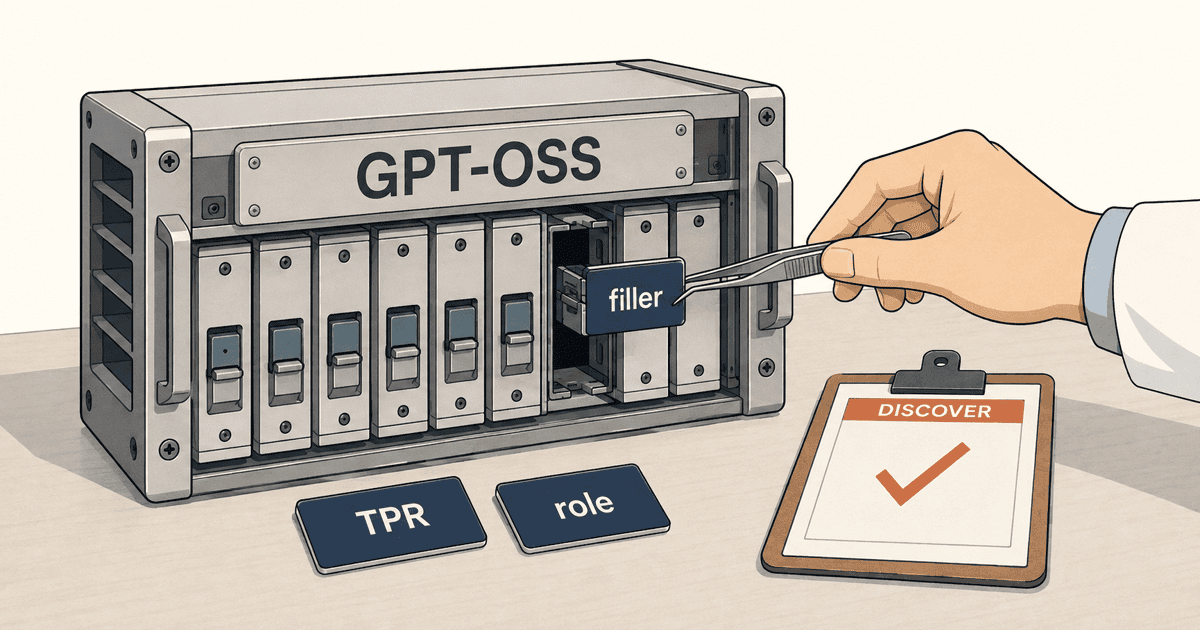
記号処理をベクトルで扱う際、単純なベクトルの加算モデルでは問題が生じます。加算は順序を入れ替えても結果が同じになる可換性を持つため、単語の並び順が失われてしまいます[3, 4]。これに対し、1990年に提案された古典的な手法がテンソル積表現(TPR: Tensor Product Representation)です[5, 6]。TPRは、具体的な値(filler)とそれが果たす役割(role)をテンソル積で掛け合わせて束縛し、それらを加算して表現を組み立てます[5, 7]。値が同じでも役割が異なれば別の表現として区別できます[5]。
従来のニューラル記号統合研究は、ニューラルネットに記号表現や論理推論の仕組みを明示的に組み込むアプローチが主流でした[8]。これに対し今回の研究は、あらかじめ記号ルールを組み込んでいない通常のニューラルネットにおいて、学習を通じてTPR型の構造が自発的に生じているか(創発しているか)を逆向きに検証した点に新規性があります[9, 10]。合成データを用いた過去の研究を、現代の多様なモデル群へ拡張した試みといえます[11]。
研究チームは、構造を同定する手法として「DISCOVER」を用いました。本研究が検証対象とするのは、役割と値の結合を加算した後にアフィン変換(線形変換とバイアスの加算)を行う、linearly-transformed TPRと呼ばれる形式です[12, 13]。式としては $E = W(\sum_i f_i \otimes r_i) + b$ で定義されます[12]。
従来の線形プローブは、モデルの隠れ表現から特定の特徴を読み出せるかを受動的に調べる独立した分類器でした[14]。これに対してDISCOVERは、隠れベクトルそのものをTPRの閉形式で再構成します[15, 16, 17]。再構成した近似表現を元のモデルのデコーダへ戻し、モデルの行動が変わらないかを調べることで、表現生成過程全体がTPRに置き換え可能であるかを検証します[18, 19, 20, 21, 22, 23]。
後輩プローブで値が読み出せることと、今回のDISCOVERは何が決定的に違うんですか?
先輩プローブは単に情報がベクトルの中に残っているかを外側から確認するだけなんだ。DISCOVERは隠れベクトルそのものをTPRの計算式で作り直して元のネットワークに戻す。
後輩表現そのものを丸ごと数式で差し替えても、元のモデルと同じように動くか試しているわけですね。
先輩その通りだね。だから単に情報が含まれているだけでなく、モデルがその構造を使って出力しているかという機能的な同等性まで踏み込めるんだよ。
何が起きたのか:小規模モデルから7つのLLMに及ぶ構造同定実験
研究チームはまず、小規模な4種類のアーキテクチャ(MLP、GRU、標準Transformer、ボトルネックTransformer)を対象に検証を行いました[24, 25, 26]。タスクには、アルファベット26文字を用いた長さ1〜6の文字列に対するコピー、反転、交互配置を設定しました[27]。各タスクで5万7000例のデータを作成してモデルを訓練しています[27]。
4種類のアーキテクチャと3種類のタスクを組み合わせた計12通りの設定すべてにおいて、前後の位置関係を考慮する双方向roleを用いたDISCOVER近似が高い精度を示しました[28, 29, 30, 31, 32, 33]。最も低い反転ボトルネックTransformerでも平均近似精度は0.973であり、他の11設定はすべて0.99を超えました[28, 31, 32, 33]。代表例である反転タスクのGRUは、未知テスト例でタスク精度100%を達成し、その内部表現を双方向TPRで近似した精度も最低99.98%に達しました[34, 35, 36, 37]。一方で、順序を問わないソートタスクでは順序を持たないbag-of-words roleでも近似できたため、モデルはタスクの要求に応じて役割構造を学習していることが示唆されます[38, 39]。
続いて研究チームは、7種類のオープンウェイトLLM(Gemma-3-27b、GPT-2-XL、GPT-OSS-20b、Pythia-12b、Qwen3-14b、OLMo-2-13B、Llama-3.1-8b)の隠れ状態を分析しました[40, 41, 42, 43, 44, 45]。隠れベクトルの次元数は1600から5376次元であり、各モデルの5つの層を対象としています[40, 41, 43]。
最初の検証では、長さ3〜5の名詞リスト、主語・動詞・目的語(SVO)からなる固定文、構文が変化する複雑文の末尾にあるピリオドの表現を調べました[43, 44, 46]。ピリオド表現からの語順の完全再構成精度は、SVO文で全層100%、名詞リストで概ね85%超、複雑文で概ね50%超となりました[47, 48]。DISCOVERによる近似でも、SVO文は3つの役割で完全近似され、リストや複雑文では双方向roleが高い適合度を示しました[49, 50]。
さらに強い検証として、研究チームはGPT-OSS(20b)を対象に、ピリオドだけでなく全25層の全入力トークン表現をDISCOVERで近似しました[51, 52]。算術、三段論法、コード実行など6つの記号タスクで評価した結果、タスク固有の複合role schemeが全タスクで最良の近似を示しました[53, 54, 55, 56, 57, 58]。元のGPT-OSS自身のタスク精度との差は、最も差が開いた算術タスクでも2.36ポイントにとどまりました[53, 54, 57, 58]。なお、実験コードの一部は公開リポジトリで提供されています[59]。
| モデル・設定 | 対象タスク / 入力 | タスク精度(元モデル) | DISCOVER近似精度 | 主な役割設計(role scheme) |
|---|---|---|---|---|
| 反転 GRU [34, 35, 36, 37] | 文字列反転(長さ1〜6) | 100% | 最低 99.98% | 双方向 role |
| 反転 ボトルネックTransformer [28, 31, 32, 33] | 文字列反転(長さ1〜6) | - | 平均 0.973(最低値) | 双方向 role |
| レター列 その他10設定 [28, 31, 32, 33] | コピー、反転、交互配置 | - | 平均 0.99 超 | 双方向 role |
| LLM 7種(ピリオド表現) [47, 48, 49, 50] | SVO文(主語・動詞・目的語) | - | 完全近似(再構成100%) | 主語・動詞・目的語の3役割 |
| GPT-OSS(全25層・全トークン) [53, 54, 57, 58, 60] | 算術、三段論法、コード等6タスク | 基準値 | 元モデルとの差は最大2.36pt | タスク固有複合 role |
後輩小規模なモデルだけでなく、200億パラメータ規模のLLMでも全層・全トークンで近似が成り立ったのはなぜですか?
先輩算術やコード実行のように厳密な規則性が求められるタスクでは、モデル内部が自ずと役割と値を整然と組み合わせる構造をとらざるを得ないからだと考えられるね。
後輩役割の語彙を増やせばパラメータ数が増えるので、単に表現力が高くなって無理やり近似できただけという可能性はありませんか?
先輩その疑問は重要だね。論文でも検討されていて、役割数が同じでも設計によって精度が大きく変わったり、役割数が少なくても適合する例が確認されているよ。
何が変わるのか:受動的読み出しから「因果的な内部介入」への転換
DISCOVERが単なる統計的なフィッティングではないことを証明するため、研究チームは同定された内部表現に対する因果介入実験を行いました[61, 62, 63, 64, 65, 66]。内部表現を書き換えたとき、モデルの最終出力が意図通りに変化するかどうかを検証する手続きです[62, 66]。
GPT-OSSの6タスクにおいて31種類の因果介入を実施したところ、全体の平均成功率は0.903(約90.3%)を記録しました[62, 63, 64, 65, 66, 67, 68]。変数に入る具体的な値を差し替えるfiller変更介入では、成功率は0.95〜1.00となりました[62, 64, 65, 66, 67]。また、文構造や位置関係を入れ替えるrole変更介入でも、0.892〜0.980という高い成功率を示しました[62, 64, 65, 66, 67, 68]。
このrole変更介入の成功は、アーキテクチャの観点からも重要な事実を示しています。GPT-OSSは残差ストリームに位置ベクトルを直接加算する方式ではなく、回転位置埋め込み(RoPE)を採用しています[69, 70, 71]。そのため、残差ストリーム上でroleの編集が成功したという事実は、位置や構造に関する情報がモデルの内部表現に自発的に創発している証拠であると解釈されています[69, 70, 71]。対照実験においても、構文構造を保った編集は成功する一方、単なる線形順序だけを保って構文を壊した編集では精度が低下しました[70, 72]。
| 介入カテゴリ | 対象とする操作 [62, 66, 68] | 成功率の範囲 [62, 64, 65, 66, 67, 68] | 因果的な含意 [62, 69, 70, 71] |
|---|---|---|---|
| 全体平均 | 31種類の介入全体の平均値 | 0.903(平均値) | TPR構造がモデルの行動に因果的に関与していることを支持 |
| filler変更 | トークンが担う値の差し替え(コード実行等) | 0.95 〜 1.00 | 値の表現が局所的かつ正確に出力へ反映される |
| role変更 | 構文上の役割や構造的配置の入れ替え | 0.892 〜 0.980 | RoPE採用モデルでも構造表現が内部創発していることを示唆 |
さらに研究チームは、学習時に見たことのない役割と値の組み合わせに対する分布外(OOD: Out-Of-Distribution)一般化を検証しました[73, 74, 75, 76]。対象モデル自体は全データで学習させ、DISCOVERの訓練時のみ特定のrole-fillerペアを除外します[76, 77, 78, 79, 80, 81]。もしモデルが特定の組み合わせを丸暗記しているだけであれば、未知の組み合わせに対する近似は失敗します[74, 75, 82]。
実験の結果、レター列タスクの交互配置TransformerやGPT-OSSの算術タスクを除き、多くの設定で強い偶然ベースライン(非体系的な結合を仮定した基準)を大きく上回る一般化精度を示しました[73, 76, 78, 79, 81]。なお、この一般化には適切な正則化(L2,1正則化)が重要であり、交互配置ボトルネックTransformerでは精度が0.54から0.97へと改善しました[83]。
後輩内部の数値を書き換えてモデルの答えが変わるなら、LLMは本当に記号のルール通りに動いていると言えませんか?
先輩因果介入の成功率が平均9割あるから、同定した構造が出力に強く影響しているのは確かだね。でも成功率は100%ではないんだ。
後輩残りの1割は思い通りに動かなかったということですね。完全な記号システムとは何が違うんでしょう?
先輩ニューラルネットの表現はどこまでいっても連続ベクトルによる近似だからね。純粋な論理演算回路そのものになっているわけではないんだよ。
どこまで言えて、どこからが未解明か:結果の解釈と限界
本研究の成果を評価する上では、いくつかの境界線を明確に区別する必要があります。著者らは、ニューラルネットが厳密な記号体系を実装しているのではなく、記号構造に近づく「近似的な実装」を学習しているという立場をとっています[84, 85]。実際に、複雑文を処理するGPT-OSSの中間層では、元のLLM表現からの再構成精度が0.71であったのに対し、DISCOVER近似からの再構成精度は0.96でした[84, 85]。近似モデルの方がかえって規則的になりすぎている側面がみられます[84, 85]。
最も混同してはならない点は、「モデルが文字どおりテンソル積を計算しているわけではない」という点です[86, 87, 88, 89, 90, 91]。TPRは、値と役割を乗法的に結合し、それらを加法的に集約する枠組みです[87, 88, 89, 90, 91]。ベクトル記号アーキテクチャ(VSA)に属する他の手法(HRR、MAP、BSCなど)も、数学的に同等の表現形式に変換できます[92]。DISCOVERの成功が保証するのは、これらVSA系統に共通する高レベルな表現構造の存在までであり、モデルが実際に外積(テンソル積)を演算していることや、特定の形式を使っていることまでは特定できません[86, 87, 88, 89, 90, 91, 92, 93, 94]。
また、ピリオド表現の実験では、複雑文において構文木に基づく役割よりも線形順序に基づく役割の方が高い適合度を示しました[95, 96, 97]。この結果から、ピリオド位置の表現が主に捉えているのは抽象的な文法構造というよりも、トークンの出現順序であると解釈されています[95, 96, 97]。
検証対象となったタスクの性質にも注意が求められます。実験で扱われたのは、算術、論理、コード実行、限定的な文法変換など、規則が完全に定義された「体系的タスク」に偏っています[98, 99, 100, 101, 102, 103]。GPT-OSSによる全トークン検証も単一のモデルに限られています[103]。自然言語のように、規則性と曖昧な統計的例外が混ざり合う領域で同様の構造がどこまで成立するかは未解明のままです[98, 99, 100, 101, 102]。
さらに手法上の制約として、DISCOVERは研究者が事前に仮説として役割(role scheme)を与える教師ありのアプローチです[104, 105, 106, 107]。役割構造そのものを自律的に発見しているわけではありません[105, 106, 107]。また、GPT-OSSの全トークン実験ではタスク固有の役割語彙数が大きく、表現力の高さが見かけの適合度を押し上げている可能性も完全には排除できません[108]。加えて、未見ペアの一般化実験はDISCOVER側の外挿能力を測る設計であり、対象モデル自体の構成的汎化能力を直接証明した試験ではない点にも留意が必要です[109, 110, 111, 112, 113]。
なお、内部表現への直接アクセスが必要となるため、実験対象はオープンウェイトモデルに限られています[114]。公開されているコードベースも一部であり、完全な再現検証には前提条件の慎重な管理が求められます[115, 116]。
後輩モデルがテンソル積を計算しているわけではないのに、テンソル積で近似できるというのは不思議ですね。
先輩物理現象を微分方程式でモデル化しても、自然界が数式を解いているわけではないのと同じだよ。役割と値を掛け合わせて足すという数学的構造が、ベクトルの振る舞いをうまく記述しているんだ。
後輩人間があらかじめ役割の候補を設計して与えている点も、解釈の幅を狭めていませんか?
先輩鋭い指摘だね。研究者が用意した仮説の枠組みの中でよく当てはまったという結果だから、未知の文章から勝手に役割構造が浮き彫りになるわけではないんだ。
誰に影響するのか:AI開発現場・解釈性研究への波及
本研究がもたらす知見は、AIの内部構造を解明しようとする解釈可能性研究や、モデルの安全性評価の実務に影響を与えます[117, 118]。
機械論的解釈可能性(Mechanistic Interpretability)の分野では、これまで単一のニューロンや疎自己符号化器(SAE)が抽出する特徴、あるいは特定のアテンションヘッドを最小単位として解析が進められてきました[117, 119]。今回の成果は、それらの局所的な要素に加えて、「値ベクトルと役割ベクトルの乗法的結合」という分散的な記号構造を因果的な分析単位として導入する道筋を示しています[117, 119]。ベクトル全体の再構成と因果介入を組み合わせる実務的な枠組みが提示された意義は小さくありません[117, 119]。
モデルの安全性評価や運用の現場においては、内部状態の監視やレッドチーム評価への応用が期待されます[120]。特定の役割に望ましくない値が束縛されていないかを検知したり、構造を保持したまま入力を改変して脆弱性を再現したりする用途が考えられます[120]。ただし現段階では、この手法単体で安全性を数学的に認証したり、出力の無害性を完全に保証したりできるわけではありません[120]。
モデル編集の研究分野に対しても示唆があります。DISCOVERで行われた因果介入は、推論時の隠れ状態を一時的に書き換えるアクティベーション編集です[121]。モデルの重みを恒久的に書き換える手法(ROMEやMEMITなど)とは異なります[121]。編集の影響が他の無関係な知識へ漏出しないか、言い換え表現に対しても効果が維持されるかなど、実用化に向けた検証課題が残されています[121]。
さらにモデル設計や認知科学の観点では、記号構造を無理にハードコードするのではなく、DISCOVERを構造の診断指標や補助損失として活用するアプローチが考えられます[23, 122]。今後は、通常のモデル計算がどのようにこの構造を形成し利用しているのかを詳細に追跡するとともに、完全に体系的なタスクから自然言語全般へと検証範囲を広げていく必要があります[123, 124]。
後輩現場の開発者としては、この成果をすぐにモデルのハルシネーション対策やバグ修正に使えたりしますか?
先輩すぐに万能な修正ツールになるわけではないよ。今回の介入は推論時の状態を一時的にいじるものだから、モデル自体の恒久的な修正とは別物なんだ。
後輩なるほど。まずは内部で何が起きているかを正しく診断するための、高精度な聴診器を手に入れた段階と捉えるのが良さそうですね。
先輩その捉え方が適切だね。ブラックボックスの中身を役割と値という構造で捉えられるようになったことが、次の安全性診断や制御技術の足がかりになるんだよ。


