AI検索エンジンが回答の根拠として提示する引用元に、AIに読ませる目的で機械生成された大量の比較ページが紛れ込んでいる実態が報告されました。従来の検索流入ではなくAIの要約・引用候補を狙う手法が台頭し、利用者が客観的な比較結果と誤認する懸念が高まっています。AI検索の仕組み、量産型サイトの特徴、利用者が持つべき視点と各ステークホルダーへの影響を整理して解説します。
何が起きたか:21万件の機械生成ページとAI回答への混入実態
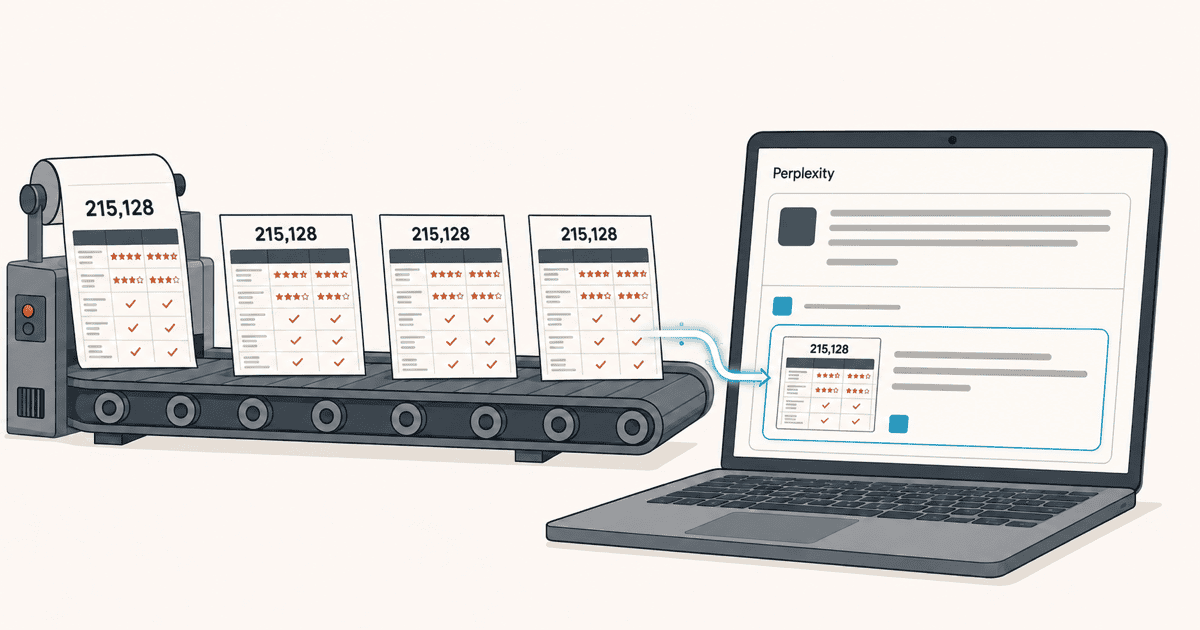
AI検索エンジンの回答根拠として、機械的に作られたウェブページが大量に引用されている実態が調査で明らかになりました。調査機関のTrellner Researchは、2026年9月2日付の報告において、3つのブランドが合計215,128件もの機械生成による比較購入ガイド(best category形式)を公開していたと報告しています[1]。これらのページは、特定のカテゴリでおすすめのソフトウェアを紹介する構成を取っています。
AI検索サービス「Perplexity」を対象に行われた同調査の分析では、回答に含まれた7,534件の引用のうち、59.8%がウェブサイト人気度ランキング「Tranco」で10万位より下のドメインを指していました[2]。さらに、全体の23.4%はトップ100万位にも入っていないドメインでした[2]。一般的な知名度やトラフィックが極めて低いサイト群が、AIの回答を支える情報源として選ばれています。
具体例として、レビュー媒体ではないGuideflowのマーケティングブログが挙げられています。このブログは、調査対象となった380カテゴリのうち96カテゴリにおいて、計194回も引用されていました[3]。本来は製品の一次検証を行わないブログ記事であっても、AI検索によってソフトウェア購入判断の根拠(grounding)として採用されていた実態が示されています。
後輩一般的にはあまり知られていないサイトが、AI回答の出典の半数以上を占めているのは驚きですね。
先輩トラフィックの多さと情報の正確さは必ずしも一致しないけれど、検証体制が不透明なサイトが大量に入り込んでいる点は見過ごせないよ。
後輩人間があまり見ないような深い階層のページでも、AIは機械的に拾い上げてしまうわけですね。
先輩その通りだね。利用者は出典リンクがあるだけで安心してしまいがちだから、引用の質そのものを疑う視点が必要になるよ。
なぜ今か:AI検索の仕組みと「読者獲得コスト」の変容
AI検索が急速に普及する中、検索トラフィックの構造自体が大きく変化しています。Googleは、要約を表示する「AI Overviews」が出る種類の検索において、Google Searchの利用が10%超増加したと発表しました[4]。またChatGPT Searchでも、AIの回答本文に直接リンクが埋め込まれ、流入経路を追跡する仕組みが用意されています[5]。これに伴い、情報を届ける対象が人間の読者だけでなく、AIモデルそのものへと広がりつつあります。
現代のAI検索は、単純なキーワード照合ではなく、質問を分解して検索する仕組みを採用しています。Googleの生成AI検索は、元の質問を複数のクエリに分解して検索するquery fan-out(クエリ・ファンアウト)と、従来の検索順位付けを組み合わせたRAG(検索拡張生成)で動作します[6, 7]。ChatGPT Searchも利用者の質問を1件以上の対象化された検索クエリに書き換え、必要に応じて追加検索を実行します[8]。AnthropicのWeb Searchツールでは複数回の検索を行い、最大150文字の引用テキストを取得する仕様です[9]。Microsoft Copilot Studioも質問から焦点化したキーワード検索を生成し、要約回答を作成します[10]。
この検索・生成の多段階プロセスに対応して、生成エンジン最適化(GEO)という手法が注目を集めています。GEOの研究論文によると、10,000件のクエリを用いた実験において、AI回答内でのソース可視性を最大40%高められることが示されました[11]。ただし、その効果は分野に依存し、継続的な適応が求められるとされています[11]。
従来のSEOやアフィリエイトは、検索結果から人間を呼び込んで購入へ誘導する経路が中心でした[12]。しかしAI検索の時代では、同じテンプレートを使い機械的に量産したページを「AIモデルの引用候補」として展開する手法が、従来よりも低い読者獲得コストで成立し得ると考えられています[13]。クリックを待つ前に、まずAIの知識ベースや引用枠に入り込むことが狙われています。なお、GoogleのAI検索に表示されるための前提条件は通常のインデックス登録とスニペット表示対象であることであり、専用のllms.txtなどは不要とされています[14]。
後輩人間に読ませるための工夫と、AIに拾わせるための工夫は根本的に違うということですか?
先輩人間の目を引くデザインよりも、AIのクエリ分解や情報抽出に合致した論理構造を大量に用意するほうが、低コストで拾われやすい側面があるんだ。
後輩クリックされなくても、AIの要約文に自社に都合の良い情報が採用されれば目的が達成されてしまいますね。
先輩その通りだね。だからこそ、モデルが参照する前段階でのフィルタリングが問われているよ。
何が違うのか:外形を整えた量産サイトと一次検証メディアの境界
問題となっている機械生成ページは、一見すると信頼できそうな外形を備え始めています。調査で確認されたサイトの中には、有料掲載の開示、著者や編集者、ファクトチェック担当者の表示、さらには4段階の採点手順といった編集プロセスを掲げる例もありました[15]。しかし、DNS情報やテンプレートの一致から、複数ブランドが共通の運営基盤で動いている可能性が指摘されています[16]。
形式的な表記が整っていても、一次検証メディアとの間には決定的な違いが存在します。実機検証を行うメディアは、多大な費用と時間をかけて客観的な証拠を収集しています。たとえばConsumer Reportsは、テスト対象の車両を販売店から自ら購入し、1台あたり50以上のテストを実施して長期追跡を行っています[17]。
また、利益相反の排除と開示の基準も大きく異なります。The VergeやWIREDは、編集部による有料レビューを禁止し、アフィリエイト事業を取材・編集から完全に独立させています[18, 19]。記事内にアフィリエイトリンクを含む場合も、その存在を明確に開示します[20]。米連邦取引委員会(FTC)や日本の消費者庁も、単にリンク名を置くだけや冒頭の一括表示だけでは不十分であり、報酬関係を消費者に分かりやすく明示することを求めています[21, 22]。
| 項目 | 一次検証メディア(Consumer Reports・The Verge等) | 外形を整えた機械生成比較サイト |
|---|---|---|
| 検証手法 | 実機の自費購入、50以上の個別テスト実施 [17] | テンプレートへの情報流し込み [16] |
| 利益相反の管理 | 有料レビューの禁止、編集部門と広告・提携の完全分離 [18, 19] | 有料掲載の注記はあるが同一基盤で複数展開 [15, 16] |
| 訂正と追跡性 | 訂正時刻と変更内容を明記し長期利用を追跡 [23] | 外形的な編集方針表示にとどまる [15] |
| 本質的な信頼性 | 第三者が追跡・検証可能な実測記録が存在 [24] | 客観的なテスト記録の実体確認が困難 [24] |
Googleの検索スパムポリシーでは、ユーザーへの付加価値を持たずに検索順位や生成AI回答の操作を目的としてページを大量生成する行為を「scaled content abuse(大規模なコンテンツ乱用)」と規定しています[25, 26]。評価において重視されるのは、薄い要約ではなく、一次体験や定量的測定に基づく独自調査です[27, 28]。外形的なクレジットの有無以上に、第三者が検証可能な実測データが存在するかどうかが本質的な境界線となります[24]。
後輩著者名やテスト手順がページに書いてあっても、それが実在する検証に基づいているかは分からないんですね。
先輩表記を真似るだけならLLMを使えば一瞬でできてしまうからね。形式ではなく、再現可能なデータがあるかが決定的に違うよ。
後輩手間をかけて実際にテストしているメディアほど、コスト面で不利になってしまいませんか?
先輩まさにそこが業界の大きな課題なんだ。良質な検証を続ける媒体が報われる仕組みを守らなければならないね。
何が変わるか:観測データの限界とAI検索の信頼性リスク
今回の調査結果を解釈するにあたっては、データの性質と限界を正しく理解する必要があります。Trellner Researchによる調査は、Perplexityのみを対象とした単日スナップショットです[29]。また、対象となった380カテゴリは調査者が独自に選定したものであり、実際のユーザーの購買ログを代表した標本ではありません[30]。
さらに、Perplexityの2つのモデル(sonarとsonar-pro)の実行結果では、289カテゴリで引用リストが完全一致し、URL集合のJaccard重複率も0.898と極めて高い値を示しました[31]。これは独立した2回の検証ではなく、共通の検索基盤を2度観測した結果に近いと解釈されます[31]。加えて、この調査は量産ページを除去した場合に推薦結果がどう変わるかという因果関係までは検証していません[29, 32]。人気度を測るTranco順位が低いこと自体も、直ちにコンテンツの低品質を意味するわけではありません[33]。
しかし、AI検索の仕組みそのものに起因する構造的リスクは厳然として存在します。Perplexityのソース評価ラベルは、個別ページではなくドメイン全体に対して付与されます[34]。そのため、サイト全体にラベルが付いていても、個々の記事や主張の正確性までは保証されません[34]。またOpenAIも、ChatGPT検索の結果や引用が不完全、古い、または誤っている可能性があると認めています[35]。
AIが提示する「もっともらしい引用元」を信用し、利用者が客観的な検証を経ないままソフトウェアの選定を行ってしまうリスクが懸念されます[36]。AI事業者にとっても、クエリ書き換えから引用選択までの各段階で品質管理コストが増大し、正規の一次メディアにとっても適正な評価やトラフィックが奪われるという悪影響が生じかねません[37, 38]。
後輩ドメイン単位で評価されているなら、信頼できると判定されたドメイン内で低品質なページが作られたら防げないですね。
先輩そうなんだ。ページ単位での正確性をAIが瞬時に見抜くのは、技術的にもまだ発展途上の段階だよ。
後輩調査自体も限定的なスナップショットだから、すべてのAI検索が同じ状態とは言い切れない点も注意が必要ですね。
先輩その通りだね。特定の事象を過大評価せず、アーキテクチャ全体の課題として捉えることが大切だよ。
誰に影響するか:事業者・プラットフォーム・規制の対応策
作られた比較サイトの台頭は、ソフトウェア企業、AIプラットフォーム、規制当局の三者に具体的な対応を迫っています。
ソフトウェア提供企業にとって、第三者の量産ページに自社製品の情報を歪められないための自衛策が求められます。公式ページやドキュメントを「正本」として位置付け、価格、プラン、機能、制限事項、更新日などのメタデータを構造化して発信し続けることが有効な防御策になります[39]。OpenAIのショッピング機能では価格や在庫、主要販売者かどうかが考慮され、Google Merchant CenterでもAI向けに会話型属性を登録する仕組みが用意されています[40, 41]。公式の構造化データを直接提供することで、AIが誤った情報を取り込むリスクを抑えられます。
AI検索事業者には、引用の透明性を高める仕組み作りが求められます。各主張に対応する出典URLだけでなく、抽出した抜粋テキストや取得日時、発行した検索クエリなどを記録・追跡できる「引用台帳」の標準化が必要です[42]。また、ChatGPTが広告表示を回答から分離しているように、推薦と商業的利害の境界を明確にし、利用者が検索過程を確認できるインターフェースの提供が望まれます[43, 44]。
規制の面でも、ルールの具体化が進んでいます。EUのデジタルサービス法(DSA)は、広告の明示や推薦システムの主要パラメータを平易な言葉で説明することを義務付けています[45]。さらにEU AI法や日本のAI事業者ガイドラインの理念を踏まえ、AI生成コンテンツの識別だけでなく、比較ページの評価根拠やアフィリエイト関係を機械可読な形で開示させる制度整備が今後の焦点となります[46]。AI検索が健全な情報流通インフラとして機能するためには、エコシステム全体での多層的な防御が不可欠です。
後輩企業側としては、黙っていると勝手に作られた比較サイトに自社製品のスペックを書き換えられてしまうわけですね。
先輩そういうリスクがあるよ。だからこそ、機械が正確に読み取れる構造化データを公式から積極的に出す必要があるんだ。
後輩単に怪しいサイトを排除するだけでなく、公式情報の発信やプラットフォームの引用開示など、多方面でのルール作りが進めば安心できますね。
先輩技術の進化と対策は常にいたちごっこだから、仕組みの透明性を保ち続ける取り組みが重要になるよ。


