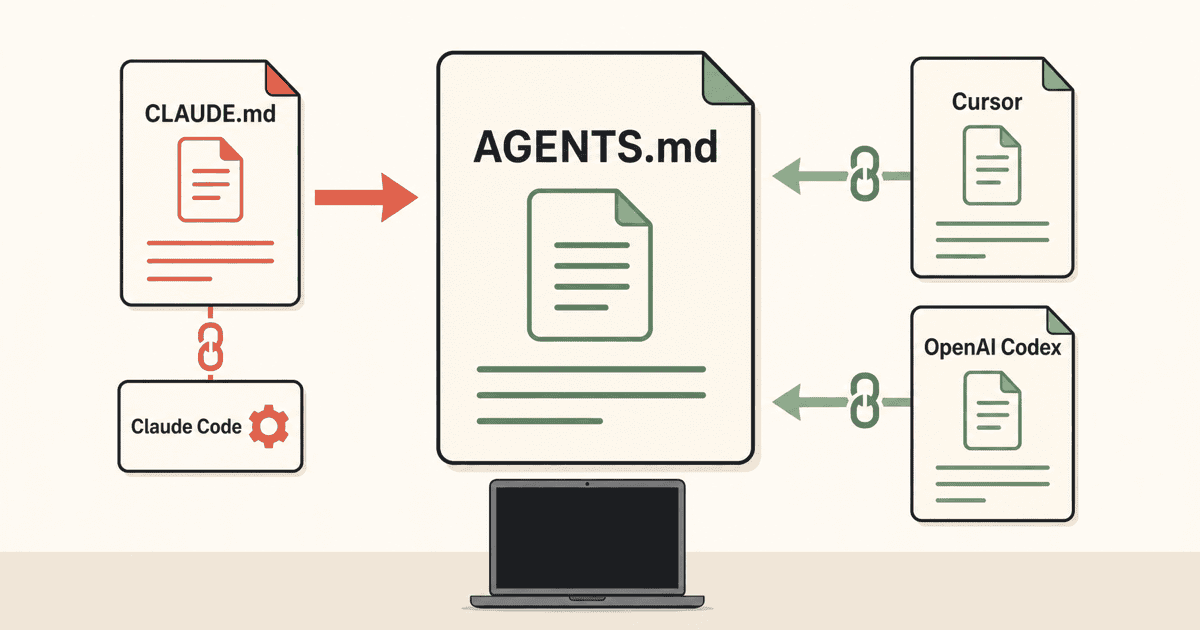
何が起きたか:Claude CodeのIssueとAGENTS.mdの現在地
AIコーディングツールの設定ファイル標準化を巡り、開発者コミュニティで議論が交わされています。発端となったのは、2025年8月21日にGitHubのClaude Codeリポジトリへ投稿されたIssue #6235「Feature Request: Support AGENTS.md」です[1]。提案者は、OpenAI Codex、Amp、Cursorなどが「AGENTS.md」へ集約し始めている現状を挙げ、CLAUDE.mdのツール固有性を指摘しました[1, 35, 45]。
このIssueは現在クローズされています[1]。2026年8月17日のクローズコメントでは、直接のネイティブ対応ではなく、CLAUDE.md内からAGENTS.mdをインポートする記述(@AGENTS.md)やシンボリックリンクの作成が案内されました[2, 22, 42]。Anthropicの現行公式ドキュメントでも、Claude CodeはAGENTS.mdを直接読まず、CLAUDE.mdを読み込む仕様と説明されています[2, 31, 42]。
同様の相互運用性に関する議論は、2026年3月14日のIssue #34235でも再提起されました[23]。別ファイルを維持することは重複を招き、指示内容の乖離(instruction drift)を生むという指摘がなされています[23]。
一方、AGENTS.mdの公式サイトによると、同形式は6万を超えるオープンソースプロジェクトで採用されています[24, 41]。OpenAI Codex、Amp、GoogleのJules、Cursor、Factoryなどの協調から生まれた形式と位置づけられています[24]。またOpenAIは、AGENTS.mdをLinux Foundation配下のAgentic AI Foundation(AAIF)へ寄贈しました[57]。単一企業が方向性を支配しない共同ガバナンスの体制が整えられつつあります[57]。
後輩設定ファイルの名前が1つになるだけで、ツール間の乗り換えは完全に自由になるんでしょうか?
先輩ファイル名が揃っても、各ツールが中身の指示をどう解釈して実行するかまでは一致しないんだ。
後輩ファイルの名前を合わせる話と、ツールの動き方を揃える話は別問題なんですね。
先輩そうだね。名前の統一は入り口に過ぎなくて、実際の読み込み方や優先順位の違いに目を向ける必要があるよ。
なぜ今問題になるのか:エージェントの自律化と指示ファイルの役割拡大
指示ファイルの扱いに注目が集まる背景には、コーディングエージェントの自律的な動作範囲の拡大があります。Anthropicは2025年2月24日時点で、Claude Codeをコード検索や編集、テスト実行、Gitのコミット・プッシュ、CLI操作を行うツールとして提供しました[25]。また2025年9月29日にはサブエージェントやフック、バックグラウンドタスクを追加し、並列開発や長時間タスクへの対応を進めました[27]。
OpenAIのCodexも、2025年5月16日時点でクラウドコンテナ内でファイル編集やテスト、リント、型チェックを実行し、GitHubのプルリクエストを出力する環境を提供しています[26]。CI/CD連携も進んでおり、OpenAIはCodex向けのGitHub Actionを公開し、AnthropicはClaude CodeをIssueやプルリクエストからの自動実装に接続させています[29]。CursorもヘッドレスCLIをスクリプトやCIパイプラインへ接続する構成を提供しています[29]。
こうした非対話環境での実行機会が増えたことで、設定ファイルの記述内容が実行結果に直接関わる場面が見られます[28, 29]。しかし、設定の品質には課題も指摘されています。2025年の予備研究では466のオープンソースプロジェクトを調査し、エージェント設定ファイルに確立した構造がなく、記述形式にばらつきがあると報告されました[43]。
さらに2026年の研究では、AGENTS.mdまたはCLAUDE.mdを含む100の人気リポジトリを調査した結果が示されています[56]。リント指示の重複や漏れを示すLint Leakageが62%、コンテキストの肥大化(Context Bloat)が42%、スキルの重複(Skill Leakage)が35%のリポジトリで確認されました[56]。
何が違うのか:ツール間で異なる読み込み規則と競合解決
各ツールの仕様を比較すると、ファイルの探索範囲や競合時の優先順位に明確な違いが存在します。AGENTS.md公式サイトは、必須フィールドのない標準Markdown形式とし、編集対象に近いファイルを優先し、明示的なユーザー指示を最上位とする方針を示しています[8, 44]。
OpenAI Codexは、グローバルの設定を読んだ後、プロジェクトルートから作業ディレクトリまで各階層のファイルをルートから下へ向かって連結します[6]。現在の作業ディレクトリに近いファイルほど後に結合されるため、広い指示を上書きする扱いになります[7, 38, 48]。直接の指示はAGENTS.mdより優先されます[7]。
これに対し、Claude CodeのCLAUDE.mdは管理ポリシー、ユーザー、プロジェクト、ローカルの順に読み込まれます[3]。作業ディレクトリの祖先は起動時に、配下のサブディレクトリは対象ファイルを読む時に読み込まれます[3]。複数のファイルは置き換えではなく連結されますが、指示が矛盾した場合は任意に選ぶ可能性があると説明されています[4, 21, 32, 38, 48]。
Cursor CLIはプロジェクトルートのAGENTS.mdとCLAUDE.mdを読み込み、.cursor/rulesと並列に適用します[9, 30]。CursorのAGENTS.mdは親ディレクトリの指示と結合され、より具体的な指示が優先されます[10]。また.cursor/rulesのMDC形式ではメタデータによる適用制御が可能です[47]。
Gemini CLIはGEMINI.mdを既定名とし、グローバル、ワークスペース、ツールがアクセスした場所の順に読み込んで連結します[11]。設定によってAGENTS.mdへの変更も可能です[11, 30, 45]。Issue #406では、GEMINI.md固有の@import機能などを共通仕様に束ねることによる拡張性の制約が議論されました[33, 36, 46]。
その他のツールでも仕様は分かれています。GitHub Copilot CLIはAGENTS.md、CLAUDE.md、GEMINI.mdなどを結合しますが、一般的なファイル間の優先順位は定義せず競合回避を推奨しています[12, 39, 49]。GitHub.com上のCopilotでは個人指示やリポジトリ指示などに階層的な優先度が定められています[13]。
WindsurfはルートのAGENTS.mdを常時有効とし、サブディレクトリではauto-globとして適用します[14]。Enterpriseシステムルールはユーザー定義ルールを上書きしません[15]。Clineは.clinerulesを主形式としつつAGENTS.mdなども認識し、ワークスペース側をグローバルより優先します[16]。
OpenCode V2は現在地からルートまでのAGENTS.mdを結合しますが、ファイル間の競合は解決しません[17, 38]。現在のV2はCLAUDE.mdフォールバックを認識しない仕様です[17]。Ampは作業ディレクトリや親のAGENTS.mdを含め、AGENTS.mdがない場合にAGENT.mdまたはCLAUDE.mdを代替として読み込みます[18]。
Junie CLIは.junie/AGENTS.mdやルートのAGENTS.mdなどを扱い、競合時はプロジェクト側を優先します[19]。AiderはCONVENTIONS.mdなどを/readや設定で明示的に読み込むワークフローを案内しており、設定ファイル自体はホーム、Gitルート、現在地の順に読み込んで後の設定を優先します[20]。
このように、Markdown形式の採用や階層探索では共通点が見られるものの、矛盾した指示の解決方法については各ツールで設計が分かれています[21]。
後輩ツールごとに優先順位のルールが違うと、同じリポジトリで別のエージェントを使ったときに混乱しませんか?
先輩上書きされる前提で書いた指示が、別のツールでは単に連結されて予期しない挙動になる可能性があるね。
後輩指示の書き方自体を工夫して、どのツールでも矛盾が起きないように整理しておく必要がありそうですね。
先輩現状では共通のルールに頼り切るのではなく、リポジトリ側で競合を避ける設計が求められているよ。
安全性はどう担保されるか:設定ファイルと実行制御の分離
設定ファイルに記述された内容は、モデルの行動を誘導するためのコンテキストであり、ツールの実行を物理的に遮断するセキュリティ境界ではありません[5, 33, 52]。したがって、指示ファイルのみに依存して安全性を担保することはできません[40, 59]。
Claude Codeのドキュメントでは、CLAUDE.mdを強制設定ではなくコンテキストと位置づけています[33, 37]。決定的な制御を行う仕組みとして、許可・拒否ルールやPreToolUseフックといった別のレイヤーを設けています[33, 37, 52]。
悪意ある指示が外部から混入するプロンプトインジェクションへの対策も重要です。GitHubの公式資料では、Issueやコメントに含まれる隠しメッセージをインジェクションのリスクとして挙げています[38, 53]。対策として入力フィルタ、ツールの制限、インターネット接続制限、人間によるレビューなどの緩和策を組み合わせています[38, 53]。
また、OpenAIとAnthropicは、指示への準拠とは別にファイルシステムやネットワークのサンドボックス環境を設けています[54]。これにより、秘密情報の読み出しや外部送信を制限する設計をとっています[54]。設定ファイルによるプロンプト誘導と、ランタイム側の決定的なアクセス制御を切り離す設計が採られています[40, 59]。
誰にどう影響するか:複数ツール併用時の実務と検証手法
複数のコーディングエージェントを併用する現場では、指示ファイルの重複管理が課題となります。単一の標準ファイルにすべての要件を集約すると、コンテキストが肥大化し重要な指示が埋没するリスクも指摘されています[40]。短い共通設定と、パス別・ツール別の個別設定を組み合わせる運用が現実的なアプローチと評価されています[40]。
ツールがどのように設定を読み込んでいるかを確認する手段も、各社で個別に提供されています。Gemini CLIは、階層的に読み込まれ連結されたメモリの完全な内容を表示する機能を備えています[55]。
GitHub Copilot cloud agentでは、実行された分析やアクションの詳細をセッションログで確認できます[55]。OpenAI Codexでは、ターミナルログやテスト結果の出力が提供されています[55]。開発者は利用するツールごとに、指示が意図通りに解釈されているかをログや出力結果から確認する必要があります。
後輩1つのファイルに全部のルールを書けば管理が楽になりそうですが、それだと問題があるんですか?
先輩指示を詰め込みすぎると、モデルが処理する情報量が増えて重要な指示を見落とす要因にもなるんだ。
後輩共通の前提だけを短くまとめて、ツール固有の細かい設定は分けた方が安全ということですね。
先輩その通りだね。共通化の利便性と、指示の確実性のバランスを見極める必要があるよ。
今後の標準化に向けて:薄い共通契約と拡張メタデータの展望
AGENTS.mdの仕様策定に向けては、新たな提案も進められています。AGENTS.mdリポジトリで公開されたv1.1ドラフトでは、自由なMarkdown記述との後方互換性を維持しつつ、メタデータを追加する方針が示されました[50, 51]。
ドラフトでは、適用範囲やタグを記述するための任意のYAMLフロントマターの導入や、プログレッシブ開示に向けたインデックス化が提案されています[50, 51]。ただし、仕様への準拠をプロンプトによる確率的な誘導で実現するか、ハーネス側の決定的な機構で担保するかは実装側に委ねられています[50]。
標準化の現実的な範囲としては、ファイルの発見規則、適用スコープ、読み込み順、競合解決の優先順位などを共通化し、権限管理やサンドボックス、フックなどの実行制御は別レイヤーとして分離する形が議論されています[44, 57, 58, 59]。
ガバナンス面では、OpenAIがAGENTS.mdをAAIFへ寄贈したことにより、Linux Foundationのもとで中立的な議論が進められる環境が整いつつあります[57, 60]。ファイル名の統一にとどまらず、エージェントが指示を解釈する意味論の明確化と、安全な実行環境の確立に向けた標準化の進展が注視されます[34, 60]。
後輩今後の標準化では、具体的に何が決まれば開発者は使いやすくなるんでしょうか?
先輩どの順番でファイルを読み、指示がぶつかった時にどう解決するかという解釈のルールが明文化されることだね。
後輩単にファイル名を揃える段階から、実行の振る舞いを予測可能にする段階へ進むわけですね。
先輩そうだね。中立な場で仕様が整理されれば、複数ツールの併用もより扱いやすくなるはずだよ。


