【何が起きたか】キオクシアが発表したCXLメモリ「KIOXIA XL1」とメモリ拡張構想の実像
XL-FLASH搭載のCXL対応モジュール「XL1」発表と階層化メモリとしての設計方針
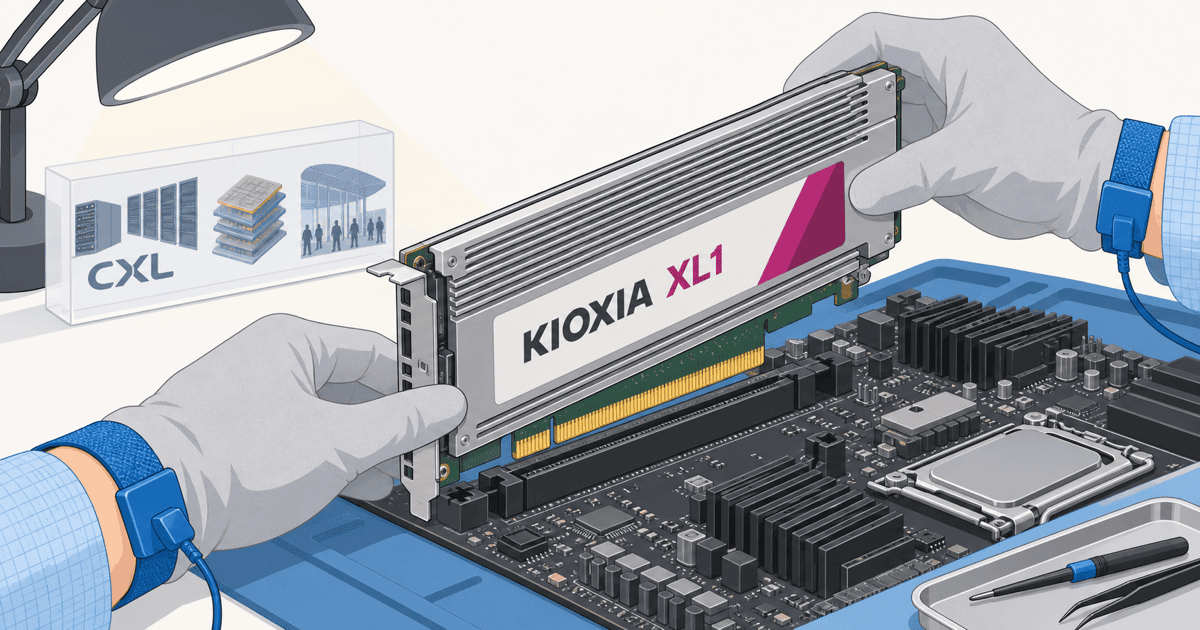
キオクシアは、AI(人工知能)処理やハイパースケール環境に向けたメモリ拡張モジュール「KIOXIA XL1シリーズ」を発表しました[1]。本製品は、高速な独自フラッシュメモリ「XL-FLASH」を搭載しています[1]。接続インターフェースには、オープン規格の次世代インターコネクトであるCXL(Compute Express Link)を採用しました[1, 4]。フラッシュメモリを主記憶の拡張手段として活用する具体的な製品構想です[1]。
XL1は、主記憶であるDRAM(揮発性メモリ)を全面的に置き換える製品ではありません[2]。本モジュールは、アクセス頻度の低いデータを退避させる第2階層のメモリとして機能します[2, 3]。頻繁に参照されるデータは高速なDRAMに残し、利用頻度の落ちたデータをXL1側へ配置します[2]。キオクシアはこの階層化により、高価なDRAMの利用効率を大幅に高める方針を掲げています[2]。
評価サンプル出荷の現状と量産・一般販売に関する未確定事項
キオクシアは2026年8月、業界パートナー(エコシステム協力者)に向けて評価用サンプルの出荷を開始する計画を公表しました[5]。展示会「FMS 2026」では参考出展として実機を披露しています[5]。ただし公式注記において、一部の機能は未評価であり仕様が変更される可能性があると説明しています[5]。本製品は現時点で開発・検証の途上にあります[5]。
キオクシアの2025年IRロードマップでは、XL-FLASH媒体自体は量産中と位置づけられています[6]。一方で、CXL接続のXL-FLASHは「2026年下期サンプル」と別区分で記載されています[6]。つまり、フラッシュ媒体自体の量産と、CXLモジュール製品の量産は同一ではありません[6]。
公開された一次資料の範囲では、量産の開始時期や一般向け販売の確定計画は確認できません[7]。採用企業や設計採用先の詳細も公表されておらず、業界協力者向け評価の段階にとどまります[8]。また、対応するCXLの世代(CXL 2.0、3.x、4.0のいずれか)も正式発表されていません[9]。実測帯域や消費電力、耐久性などの確定仕様も未公表であるため、製品の量産計画や詳細な仕様を現時点で断定することはできません[10]。
後輩DRAM代替と聞くと全部置き換わる印象ですが、主記憶そのものになるわけではないんですか?
先輩そうだね。あくまで主記憶のDRAMを補佐する第2階層のメモリだよ。
後輩あふれたデータの受け皿になるわけですね。
先輩その通りだよ。よく使うデータはDRAMに残し、たまに使うデータを預ける設計だね。
後輩主記憶を奪うのではなく、高価なDRAMを節約する相棒と捉えるべきですね。
先輩うん。その役割分担を押さえることが、この技術を見る第一歩だよ。
【なぜ今か】生成AIの拡大に伴うメモリ容量不足・コスト高騰とDIMMの物理的制約
LLMの学習・推論で爆発するメモリ消費量とHBM/DRAMの容量枯渇
AIワークロードの爆発的な拡大により、データセンターではメモリ需要が急増しています[11]。この需要増に伴い、深刻なメモリ容量不足と調達コストの高騰が顕在化してきました[11]。特にLLM(大規模言語モデル)の学習や推論では、従来の計算機構成では支えきれないほどのメモリ容量が要求されます[11]。
LLMの学習では、モデルパラメータ、勾配、オプティマイザ状態、活性値を複数デバイスへ分散させる並列化が不可欠です[12]。混合精度の学習では、パラメータと勾配、オプティマイザ状態だけで1パラメータ当たり16バイトを消費します[13]。ここへさらに計算中の中間データである活性値が加わるため、GPUメモリ単体では容易に枯渇してしまいます[13]。
推論処理においても、過去のトークン情報を保持するKVキャッシュ(Key-Valueキャッシュ)が系列長やバッチサイズに応じて増大します[14]。長文の生成では、KVキャッシュの容量がモデル自体の重み(パラメータ)を上回る場合があります[14]。このKVキャッシュをGPU外のCPUメモリへ退避させると、データ取り出しの遅延が新たな処理のボトルネックとなります[15]。
現在、AIアクセラレータには超高速な積層メモリであるHBM3Eが用いられています[16]。HBM3Eは12段製品で最大1,280GB/sという高い帯域幅を実現します[16]。しかし単体容量は36GBにとどまり、容量の拡張性には厳しい制約があります[16]。キオクシアもAI処理の主要な課題として、HBMおよびDRAMの容量不足を挙げています[17]。
DIMMスロットの物理的拡張限界とPCIe接続CXLへの移行圧力
サーバーのメモリ容量を増やす従来の手法は、CPU直結のメモリスロットにDIMM基板を増設することでした[18]。しかし、マザーボード上の配線スペースや高周波信号の品質維持の観点から、スロット増設は限界を迎えています[18]。CPUのメモリチャネルをこれ以上増やすことは、物理的にも基板設計的にも困難です[18]。
この物理的な壁を突破する技術として、CXLインターコネクトが注目されています[18]。CXLはPCIe(PCI Express)の物理層配線を利用し、プロセッサと外部メモリを低遅延かつコヒーレント(整合性を保った状態)に接続します[18, 19]。ホストプロセッサは「CXL.mem」プロトコルを通じ、外部モジュール上のメモリへ通常のロード/ストア命令で直接アクセスできます[19]。
さらにCXLは、複数のサーバー間でメモリを柔軟に割り当てる「メモリプーリング」を可能にします[20]。必要なサーバーへオンデマンドでメモリ容量を配分できるため、データセンター全体のメモリ利用率を底上げできます[20]。キオクシアは、低密度で電力を多く消費するDRAMに対し、高密度で低コストなフラッシュを用いたCXLメモリが有効な対抗策になると位置づけています[21]。
後輩メモリ不足なら、マザーボードのスロットを増やしてDRAMを挿せば解決しませんか?
先輩基板の配線スペースや信号品質には物理的な限界があるんだよ。
後輩基板上の配線密度そのものが壁になっていたんですね。
先輩そうなんだ。だからPCIeの配線を使ってメモリを外付けできるCXLが必要とされたんだよ。
後輩容量を増やすために、メモリの繋ぎ方自体を根本から変える過渡期なんですね。
先輩まさにその通りだね。物理的な配線の壁を迂回するための新しい道だよ。
【何が変わるか】DRAMとSSDのギャップを埋めるXL-FLASHとCXL階層化アーキテクチャ
ナノ秒とミリ秒の間を埋める低遅延SCM「XL-FLASH」のハードウェア特性
サーバーの記憶階層には、主記憶とストレージの間に大きな速度差が存在します[22]。GPUメモリのHBMは読み出しレイテンシーが10ナノ秒未満、CPUのDRAMは40ナノ秒未満で動作します[22]。一方で、高速なTLC SSDは40マイクロ秒未満、QLC SSDは100マイクロ秒、ハードディスク(HDD)は1ミリ秒を要します[22]。ナノ秒単位の主記憶と、マイクロ秒からミリ秒単位の外部ストレージの間には、性能の断絶がありました[22]。
キオクシアのXL-FLASHは、この空白地帯を埋めるSCM(ストレージクラスメモリ)です[24]。通常のNANDフラッシュよりも配線を短縮し、16プレーンの並列構成を採用しています[23]。さらにOSの読み書き効率を高める4KBのページサイズを備え、読み出しレイテンシーを3〜5マイクロ秒(5マイクロ秒未満)に抑えています[22, 23]。電源遮断後もデータを保持できる不揮発性を備えつつ、DRAMの直下に位置するメモリ階層を担います[24]。
一方、DRAMを用いたCXLメモリ拡張では、CXL 2.0仕様において80ナノ秒以内の読み出し応答が推奨されています[25]。マイクロ秒級の遅延を持つフラッシュをCXLで扱う場合、DRAMとは異なる階層制御やQoS(サービス品質)設計が不可欠となります[25]。各階層の公称性能を比較すると、XL-FLASHの位置づけが明確になります[22, 23, 25]。
| 記憶階層・媒体 | 主な役割 | 公称読み出しレイテンシー | データの揮発性 |
|---|---|---|---|
| GPUメモリ(HBM3E) | GPU直結の超広帯域演算メモリ | 10ns未満 | 揮発性 |
| CPUメモリ(DRAM) | システム主記憶 | 40ns未満 | 揮発性 |
| CXL接続DRAM(参考仕様) | CXL経由のメモリ拡張(DDR/HBM基準) | 80ns以内(推奨応答) | 揮発性 |
| XL-FLASH SCM(XL1搭載) | CXL階層化メモリ(低頻度データ用) | 3〜5μs(SLC <5μs / MLC <10μs) | 不揮発性(永続保持) |
| TLC SSD(NVMe) | 高速ブロックストレージ | 40μs未満 | 不揮発性 |
| QLC SSD(NVMe) | 大容量ブロックストレージ | 100μs | 不揮発性 |
| ニアラインHDD | アーカイブ・二次保管ストレージ | 1ms | 不揮発性 |
各記憶階層の公称読み出しレイテンシーの比較。XL-FLASHは主記憶DRAMとSSDの間に位置するSCMとして設計されています[22, 23, 25]。
CXL.memロード/ストア接続とLinux DAMON・CHMUによる自動階層制御
XL1モジュールは、NANDセルをCPUに直結するわけではありません[28]。モジュール内に専用のCXLメモリコントローラーを内蔵し、コントローラーがフラッシュの読み書きを仲介します[28]。ホスト側は「CXL.mem」プロトコルを用い、コヒーレントなロード/ストア操作でデバイス内メモリを直接操作します[26]。設定や管理には「CXL.io」を用い、キャッシュコヒーレンシ要求を出す「CXL.cache」は搭載していません[26, 27]。
フラッシュを主記憶の拡張として成立させるには、アクセス頻度に応じた自動的なページ配置が鍵となります[29]。キオクシアの構想では、アクセス頻度の低いコールドページをDRAMからフラッシュへ降格し、頻度の高まったホットページをDRAMへ昇格させます[29]。この階層制御を支えるため、ハードウェアとOSが協調して動作します[29, 33]。
ハードウェア側では、CXL規格で策定された「CHMU(CXL Hotness Monitoring Unit)」が機能します[30, 31]。CHMUはCXL.memのメモリアクセス要求をカウントし、256バイトから2ギガバイトの範囲で設定された単位ごとにアクセスの集中度を監視します[30]。最新のCXL 3.2仕様にもCHMUやオンラインファームウェア更新などの機能が盛り込まれています[31]。
OS側では、Linuxカーネルのメモリアクセス監視機構である「DAMON(Data Access Monitor)」が連動します[32]。DAMONはアクセス頻度を分析し、領域ごとに「migrate_cold(降格)」や「migrate_hot(昇格)」の操作を実行します[32]。キオクシアはFMS 2026などでCXLフラッシュ向けのDAMON拡張を紹介しており、ソフトウェア面からも階層化制御の実装を進めています[33]。
ホストとXL1モジュールの接続経路および階層化制御の連携図。CXL.mem経由でアクセスし、CHMUとLinux DAMONが協調してページの昇格・降格を自動制御します[26, 27, 28, 29, 30, 32, 33]。
大容量BiCS FLASHとの2系統展開とGPU外部メモリ評価の示唆
キオクシアはCXL接続フラッシュについて、特性の異なる2系統の展開構想を示しています[34]。小粒度ランダムアクセスと低遅延を重視する「XL-FLASH」系は、容量目標を256GB超から512GB以上に設定し、AI推論やインメモリデータベース、グラフ処理を対象とします[34, 35, 36]。一方、高帯域と大容量を重視する「BiCS FLASH(3D NAND)」系は、容量目標を1TB超とし、AI学習やビッグデータ分析を対象にしています[34]。
先行するDRAMベースのCXL拡張モジュール(Micron CZ120など)は、128GBや256GBの容量で最大36GB/sの帯域を提供しています[37]。これに対しキオクシアの構想は、フラッシュの密度を活かしてテラバイト級の大容量化を狙う点に特徴があります[34]。通常のNVMe SSDであるKIOXIA LC9が122.88TBという大容量を実現しているように、フラッシュ技術は大容量化において極めて高い潜在力を持っています[38]。
公表資料に基づく主要メモリ技術・モジュールの単体容量比較。HBM3Eの36GBやCXL DRAMの256GBに対し、CXL接続XL-FLASHは512GB以上を目標としています[16, 34, 35, 37]。
キオクシアはGPU環境における性能評価も公開しています[39]。Intel Agilex 7 FPGAを用いてCXL通信の遅延をエミュレートした実験では、GPUから外部CXLメモリへの遅延が約2マイクロ秒以下であれば、グラフ処理の実行時間がホストDRAMとほぼ同等になる結果を示しました[39]。キオクシアのインフォグラフィックでも、階層化構成の平均読み出し遅延10マイクロ秒未満、GPUグラフ処理で2.5マイクロ秒未満なら競合可能と主張されています[40]。
ただし、この実験はFPGAを用いた初期評価であり、NAND搭載製品の実機による量産実証ではありません[39]。また、XL1がGPUから直接アクセスを受けるDirect P2P.mem等の機能に対応するかは公表されていません[41]。したがって、現時点でXL1をGPUのHBMを直接拡張する製品と断定することはできません[41]。なお、規格面では最新のCXL 4.0仕様においてリンク帯域が128GT/sへと倍増しています[42]。
後輩ナノ秒の主記憶に比べると、マイクロ秒の遅延はかなり遅い気がします。実用になるんですか?
先輩CPUが待たされると厳しいけれど、GPUの大規模な並列処理なら遅延を隠しやすいんだよ。
後輩待ち時間に別の計算を進められる処理なら、遅延の大きさをカバーできるわけですか。
先輩うん。万能ではないけれど、適した計算パターンに絞れば十分に効果を引き出せるよ。
後輩何にでも使えるわけではなく、用途を慎重に選ぶアーキテクチャなんですね。
先輩そこを見誤らないことが大切だね。適材適所で使うべき拡張手段だよ。
【残された課題】DRAMの完全代替が困難な技術的要因と量産導入に向けた検証項目
ガベージコレクション・書き込み増幅・耐久性などNAND特有の制約
NANDフラッシュは物理的な特性上、既存データを直接上書き(インプレース更新)できません[43]。データを書き換える前に、多数のページで構成されるブロック全体を消去する必要があります[43]。そのため、残すべき有効データを別のブロックへコピーし、消去可能な空きブロックを生み出す「ガベージコレクション(GC)」が定期的に発生します[43]。
ガベージコレクションは、ホストからの要求以上の書き込みを内部で発生させる「書き込み増幅(WAF)」を引き起こします[44]。書き込み増幅はフラッシュ素子の摩耗を早め、寿命を縮める要因となります[44]。さらに、内部処理がユーザーのI/O要求とリソースを取り合うため、応答性能やQoS(サービス品質)の著しい悪化を招く恐れがあります[44]。
XL-FLASHは高耐久を謳い、同媒体を用いたFL6 SSDでは60 DWPD(1日当たりのドライブ全域書き換え回数)という高い数値を公称しています[45, 46]。しかし、これはSSD製品の仕様であり、XL1モジュール固有の耐久性仕様は未公表です[46]。そのため、XL1の書き込み耐久性を60 DWPDと推定することはできません[46]。
また、4KBページ単位のフラッシュに対し、CXL.memの細粒度なロード/ストア要求をどう処理するかという課題もあります[47]。部分書き込みの統合やFTL(フラッシュ変換層)のメタデータ更新、書き込みバッファの設計が必要ですが、XL1のコントローラー実装は非公開です[47]。そのため、書き込みレイテンシーを媒体の読み出し値から推定することはできません[47]。
さらに、NAND素子の電荷抜けに伴う保持誤りや、読み出しディスターブによるエラー訂正(ECC)の処理遅延も存在します[48]。キオクシアによるDRAM代替実証もリードアクセス主体の環境で行われたものであり、書き込みが頻発するAI環境で全面的なDRAM代替が成立するとは断定できません[49]。
重負荷時の帯域低下・QoS・クラッシュ整合性とセキュリティの壁
CXL 2.0仕様では、DDRやHBMなどの高速メモリ向けにCXL.memの読み出し応答を80ナノ秒以内と定めています[25]。フラッシュのような遅延の大きい媒体を接続する場合、ホスト側を待たせない特別なQoS設計が求められます[25]。学術研究では、CXL側の並列性不足やキュー処理の偏りにより、重負荷時にローカルDRAMの帯域が最大81%低下する現象も報告されています[50]。
CXL規格にはデバイス負荷を通知する「QoS Telemetry」が用意されていますが、これは要求レートを調整する仕組みにすぎません[51]。フラッシュ内部のガベージコレクションやECC処理に起因するテールレイテンシー(突発的な遅延スパイク)を一定範囲に抑え込む保証ではない点に注意が必要です[51]。
システムの高可用性を保つ信頼性機構(RAS)の実装も重要です[52, 53]。CXL 2.0では、異常データを64バイト粒度で追跡・通知する「poison機構」への対応が義務づけられています[52]。また電源断時には、バッファ内のデータを永続媒体へ強制退避させる「Global Persistent Flush(GPF)」が動作し、退避失敗は「Dirty Shutdown Count(DSC)」に記録されます[53]。ただし媒体がデータを保持しても、CPUキャッシュやメモリ順序を含むアプリケーション層での整合性が自動的に保証されるわけではありません[54]。
セキュリティ面では、通信経路を暗号化・保護する「CXL IDE(Integrity and Data Encryption)」が存在します[55]。しかしCXL IDEはオプション機能であり、ホストとデバイスの双方が対応して有効化しなければ機能しません[56]。また、フラッシュ媒体上のデータ暗号化(Data at Rest)はCXL IDEとは別に設計する必要があります[55]。電力面でも、大容量QLC SSD(LC9)の消費電力がアクティブ時25W、レディー時5Wと規定されているように、モジュール単体の熱設計や電力消費の検証が不可欠です[57]。
後輩安くて大容量でも、フラッシュ特有の書き込み寿命や消去待ちの遅延はリスクになりませんか?
先輩そこが最大の懸念だね。ガベージコレクションが走った瞬間に全体の応答が跳ねる恐れがあるよ。
後輩突然の遅延スパイクが起きると、推論サービス全体の応答速度に響きそうですね。
先輩そうだね。ハードだけでなく、OSやコントローラーがどう連携して揺らぎを抑えるかが重要だよ。
後輩単に挿せば解決する話ではなく、ソフトウェアを含めた制御技術の勝負ですね。
先輩その通りだね。実運用の品質を保てるかどうかが、導入の成否を分けるよ。
【誰に影響するか】AIインフラ開発者・クラウド事業者・半導体エコシステムへの波及効果
AI推論開発者とクラウド事業者におけるKVキャッシュ配置とTCO削減
AIモデルや推論基盤を開発するエンジニアにとって、XL1のようなCXLフラッシュは新たなメモリ階層の選択肢となります[58]。毎トークン参照される高頻度なKVキャッシュや実行中のテンソルは、依然としてHBMやDRAMに保持する必要があります[58]。一方で、休眠状態のKVブロックや参照頻度の低いモデルパラメータ、検索インデックスの配置先として、CXLフラッシュへの降格が有力視されます[58]。
クラウド事業者やデータセンター運営者にとっては、高価なDRAMの過剰搭載を抑える手段として期待されます[59]。メモリ不足に起因するサーバー台数の無秩序な増設を回避できれば、インフラの総保有コスト(TCO)削減に寄与する可能性があります[59]。ただし実際の経済効果は、キャッシュのヒット率、末尾レイテンシー、消費電力、素子の耐久性、モジュールの導入コストに左右されます[59]。
またデータセンター運営の現場では、DRAMとフラッシュを同一のメモリ空間として単純に扱うことはできません[60]。NUMA(非一様メモリアクセス)ノードとしての配置設計や、アクセス先読み、障害発生時のデータ再配置など、新たな運用ポリシーの策定が不可欠になると考えられます[60]。
サーバーOEMの統合検証負担とDRAM・NAND業界の競争ダイナミクス
サーバーを製造するOEM企業にとっては、システム統合に伴う検証の負担が増大します[61, 62]。CXLメモリには、通常の物理メモリ空間に統合するモードと、OS側で区別して管理する特別用途メモリとしてマッピングするモードがあります[61]。後者を採用する場合、マザーボードのBIOS設定やSRAT(静的リソース割り当て表)、OS側の対応が必須となります[61]。
さらにCXL製品の商用導入にあたっては、CPUプロバイダー、サーバーOEM、OS、ハイパーバイザーの間で網羅的な相互接続性・信頼性の検証を完了させる必要があります[62]。モジュール単体の性能を示すだけでは、実環境への採用には至りません[62]。エコシステム全体での動作保証を確立することが、量産化への前提条件となります[62]。
半導体メモリ業界の構造にも影響が及ぶとみられます[63, 64]。キオクシアなどのNANDメーカーにとっては、従来のSSD市場にとどまらず、コントローラーや階層化ソフトウェアと統合した高付加価値なメモリ拡張製品を開拓する契機となります[63, 64]。一方、大容量・低頻度アクセスのメモリ領域において、既存のDRAM専業メーカーに対して新たな競争圧力が生じる可能性があります[64]。
後輩この構想が普及したら、メモリ市場の勢力図も大きく変わっていきそうですね。
先輩DRAM専業の企業にとっては、大容量領域をフラッシュに侵食される競争の始まりになるかもしれないね。
後輩サーバーを作る側としても、検証する組み合わせが増えて現場の負担が重くなりませんか?
先輩鋭いね。BIOSからOSまで多層のテストが必要だから、普及にはエコシステムの成熟が欠かせないよ。
後輩使う側も作る側も、単なる新製品の追加以上の構造変化を受け止める準備が要るわけですね。
先輩そうだね。業界全体がどう足並みを揃えていくかを冷静に見守る必要があるよ。