何が起きたか:AMD GAIAが会議録の完全ローカル文字起こしと要約に対応しました
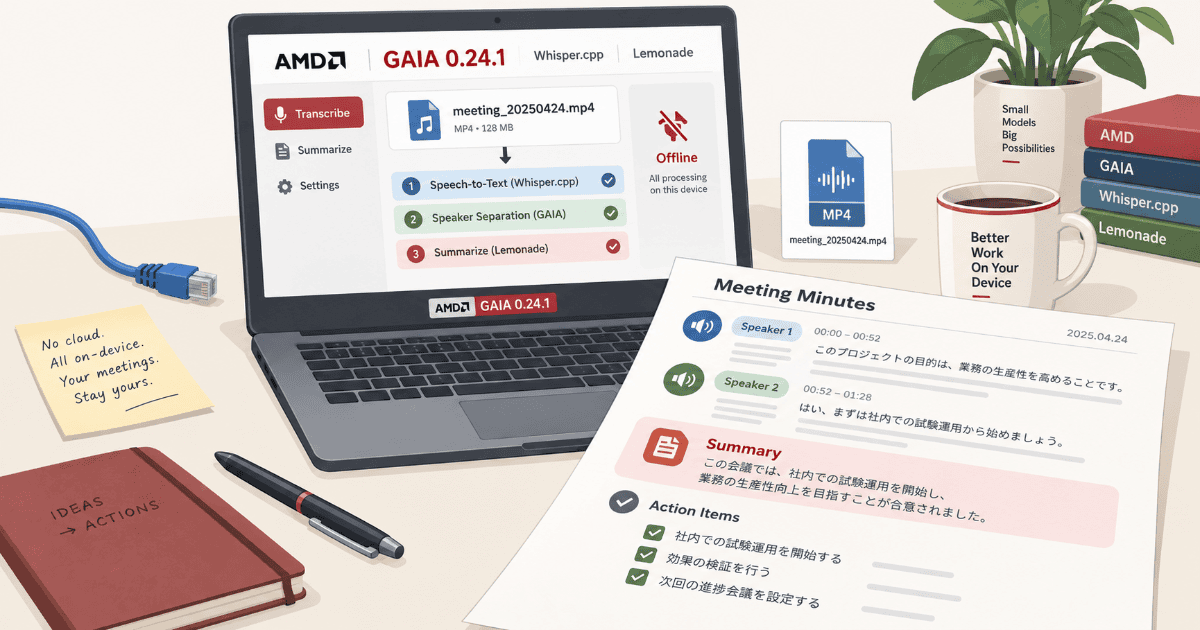
米AMDはローカルAIフレームワーク「GAIA」のバージョン0.24.1を公開し、録音ファイルから会議の文字起こしと要約を行う機能を追加しました[1]。従来のGAIAは録音ファイルを処理できず、既存の仕組みも巨大なモデルの取得や機械学習基盤PyTorchの読み込みで停止する課題を抱えていました[2]。今回の更新により、利用者は録音ファイルを指定することで、話者分離(発話者ごとに音声を区別する処理)付きの文字起こしと会議の要約を取得できるようになりました[3]。
GAIAは録音データを、Lemonadeの音声API(ソフトウェア間の接続窓口)に渡します。Lemonadeは、端末内で推論(AIモデルを実行する処理)を行うサーバです[3]。音声認識にはC/C++実装のWhisper.cppが用いられており、PyTorchやアクセス制限付きモデルのダウンロードは必要ありません[3]。また話者分離は音響特徴を解析するpyannote由来のネットワークとWeSpeakerをsherpa-onnx経由で実行します[4]。実名は会話文脈から推定され、特定できない話者はSpeaker 1などの識別子で記録されます[7]。
この処理基盤はすべての推論を端末内で実行するため、処理中に音声データが外部へ送信される心配はありません[5]。ただし「完全ローカル」という表現は推論処理を指しており、ネットワーク通信が一切発生しないという意味ではありません[6]。話者分離に用いる約33MBのモデルファイルは、初回利用時にインターネットから取得する必要があります[4]。
なぜ今か:PCハードウェアの進化と推論ランタイムの統合が進みました
ローカル環境での会議録処理が現実的になった背景には、PCプロセッサの処理分担が進んだ点があります[7]。AMDのRyzen AI搭載プロセッサは、CPUに加えて内蔵グラフィックス(iGPU)やAI専用プロセッサ(NPU)を備えています[7]。AMDはNPUを省電力な処理に割り当て、iGPUを並列計算に活用する構成を提唱しています[8]。
ソフトウェア面では、推論ランタイムのLemonadeが複数のエンジンを単一APIの背後へ統合しました[9]。GAIAはこの基盤を通じて、音声認識と要約を連携させます。GAIAは、要約に大規模言語モデル(大量の文章で学習した言語モデル)を用い、Lemonade経由で処理します[9]。さらにモデルの数値を少ないビット数で表現する8ビット量子化技術の普及により、モデルのメモリ使用量はおおむね半減しました[10]。Phi-3 miniやLlama 3.2といった小型モデルの実用化も、端末内での要約処理を後押ししています[11]。
クラウドサービスの利用コストや機密保持への懸念も、ローカル処理への需要を高めています[12]。クラウドの音声認識は、音声の処理時間など利用量に応じて料金が決まる従量課金制が多く、利用の蓄積に伴い費用が増加します[12]。たとえばAmazon Transcribeの標準バッチ処理では、月間200万分の音声処理で1万2,000ドルの費用が発生します[12]。GAIAは端末内で処理を完結させることで、追加のサービス利用料を発生させずに機密を保護します[13]。
ただしGAIAを動作させるには一定水準のハードウェア環境が必要です[14]。開発者ガイドによると、Ryzen AI 300シリーズ以上のプロセッサ、16GBのメモリ、20GBの空き容量が最低要件とされています[14]。NPU処理を利用する場合はXDNA2世代が必要であり、旧世代のXDNA1搭載機ではGPUの利用が案内されています[15]。なお各ハードウェアごとの消費電力や処理時間の詳細データは公開されていません[16]。
精度検証の真実:公式数値94.1%の意味とクラウド比較の落とし穴を整理します
AMDが公表した公式評価では、46分間で4人の話者が参加した実会議録を用いて性能が測定されました[17]。システムは約10分で文字起こしから要約までを完了し、GPUでの文字起こし速度は実時間の約9倍を記録しました[17]。WhisperXの参照結果に対する単語レベルの類似度は94.1%を示し、主要な内容語60語はすべて検出されました[17]。
| 評価項目 | 測定値 | 備考 |
|---|---|---|
| 対象会議録の長さ | 46分 | 4話者の実会議録 |
| 端到端の処理時間 | 約10分 | 文字起こしから要約完了まで |
| GPU文字起こし処理速度 | 約9倍速 | 実時間比(ウォーム時) |
| 単語レベル類似度 | 94.1% | WhisperX large-v3参照 |
| 主要内容語の保持数 | 60語 / 60語 | 参照された主要語の検出 |
公表された測定結果は上記の通りです[17]。しかし、この94.1%という数値をクラウド音声認識サービスの精度と同列に比較することはできません[18]。この数値は人手で作成した正解テキストに対する単語誤り率(WER)ではなく、WhisperXを参照値とした類似度です[18]。Googleやマイクロソフトのクラウドサービスは正解テキストを用いたWERで評価を行っています[18]。同一の音声データによる統一試験が行われていないため、現時点でクラウドとの優劣は断定できません[19]。
実務環境で文字起こし精度を正しく評価するには、単一の全体指標だけでは不十分です[20]。全体の誤り率に加えて、社名や製品名といった専門用語の完全一致率や、必要な語を漏れなく検出できた割合である再現率を測定する必要があります[35]。また日本語では表記ゆれが発生するため、正当な表記差を許容する正規化ルールの設定が求められます[21]。さらに数字の正規化や句読点の挿入精度、誰が発話したかを測る話者帰属評価も重要な判断材料となります[37]。
後輩公式の検証スコアが高いなら、もうクラウドの音声認識を使わなくても十分なんじゃないですか?
先輩そう判断するのはまだ早いよ。今回の検証は人手で作った正解データとの比較ではなくて、別の認識モデルを基準にした一致度を見ているだけなんだ。
後輩基準そのものが正解とは限らないから、実務での正答率とは意味が違うわけですね。
先輩その通りだね。実際の会議では専門用語や話者の重なりもあるから、用途に合わせた多角的な評価が必要になるよ。
後輩単純な数値の比較だけで飛びつかず、自社の業務条件で見極める必要がありますね。
何が変わるか:ローカル実行の利点と運用で見える技術的限界を対比します
GAIAによるローカル実行は、音声データを外部に送信しない情報管理の安全性をもたらします[13]。クラウドと異なり通信環境に依存せず、処理時間に応じた従量課金も発生しません[13]。社外秘の会議音声やプライバシーに関わる記録を扱う現場において、端末内で完結する処理は実用的な選択肢となります[13]。
その一方で、ローカル運用の現場では技術的な限界も確認されています[22]。GAIAの話者分離は短い割り込み発話に弱く、90秒の録音で数言発話した2人目の話者を見落とした事例が報告されています[22]。また話者数を指定しないクラスタリング(音声を話者ごとの集まりに分類する処理)は、判定基準となる閾値に敏感です。設定値によって、話者の過度な分割や統合が発生します[43]。閾値0.50では10個に過剰分割され、0.75では2個に統合されるなど、適切な調整が求められます[43]。
さらに実会議で想定される多様な音響環境への耐性も、慎重に見極める必要があります[23]。基盤となるWhisperモデルは、雑音があっても性能が低下しにくい性質を備えますが、言語や条件によって性能差が存在します[24]。確認した公式資料の範囲では、騒音下や日英混在に関する条件別データを確認できませんでした[25]。そのため、複雑な環境で安定して文字起こしできるかは、現時点の情報から断定できません[25]。
誰に影響するか:適する利用環境とクラウド併用が推奨される境界線を示します
GAIAの活用が適しているのは、対応するRyzen AI搭載PCを所有し、機密保護を最優先する個人や小規模チームです[26]。数分程度の待ち時間を許容でき、録音ファイルの要約を社内LANやオフラインで完結させたい用途に向いています[26]。必要なモデルをあらかじめ取得しておけば、外部ネットワークから物理的に隔離された環境でも、音声を外部送信せずに議事録を作成できますが、端末や運用全体の安全性は別途確保する必要があります[13]。
反対に、即時性が求められるリアルタイム文字起こしや多数端末の集中管理ではクラウドサービスが優位です[52]。クラウドは専門用語の辞書登録機能や標準化された精度評価手順が整備されており、品質管理が容易です[27]。法務や財務のように誤認識が重大な判断ミスにつながる業務では、人手による確認やクラウド適応機能の併用が妥当といえます[28]。自社の機密要件と運用体制に応じて、両者を適切に使い分ける判断が求められます[28]。