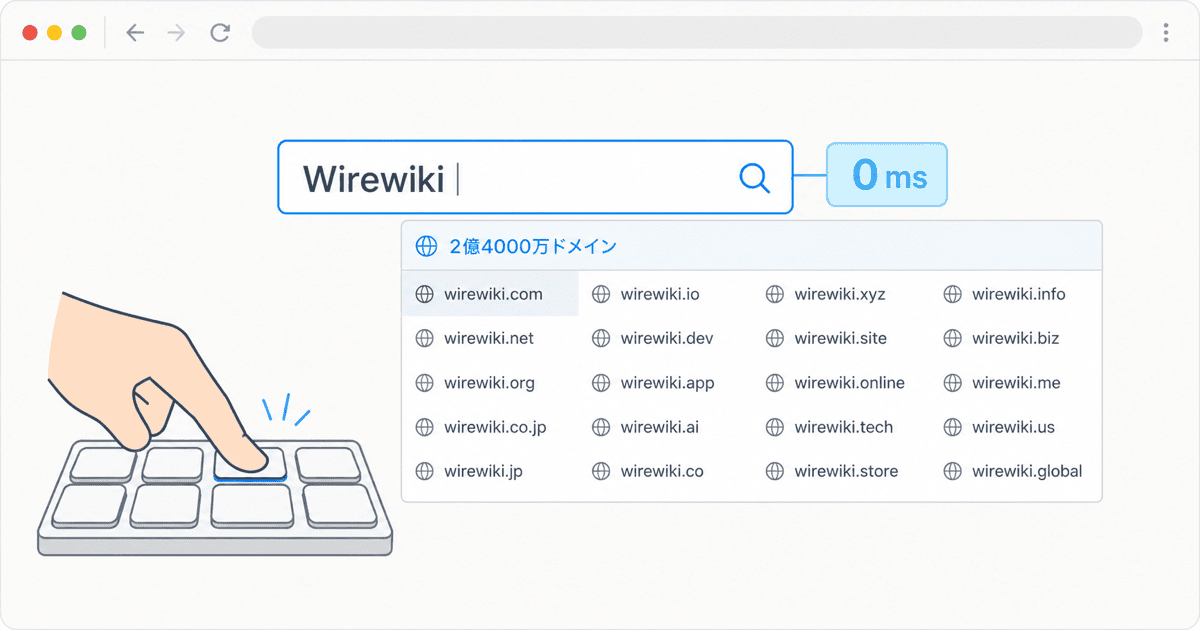
なぜ今、2億件超のドメイン即時検索が求められるのか
インターネット基盤の調査サービス「Wirewiki」は、ドメイン名を起点にDNS(ドメイン名をIPアドレスに変換する仕組み)やIPアドレスなどを調べる用途を持っています[1]。Wirewikiではオートコンプリート(入力補完機能)が主要な操作手段であり、検索体験を差別化するために即時表示を重視しています[2]。
ドメイン名の登録規模は拡大を続けています。VerisignのDNIB統計によると、2026年第2四半期末における全TLD(トップレベルドメイン)の登録数は4億0160万件に達しました[8]。この数値は前年同期比で2990万件、8.1%の増加を示しています[9]。内訳としては、.comおよび.netが1億7910万件、国別コードトップレベルドメイン(ccTLD)が1億4860万件を占めています[10]。また、Netcraftの2026年6月の調査では、ウェブ上で観測されたドメイン数が前月から200万件増えて3億0414万6307件となりました[11]。
ドメイン名の増加や更新の背景には、さまざまな要因が存在します。Cloudflareは、数文の指示でサイトを作成できる手法(vibe coding)の普及が参入障壁を下げていると説明しています[12]。またNetcraftは、AI生成テキストを含むサイトが2024年3月から8月にかけて3.95倍観測されたと報告しています[13]。さらにICANNの2026年新gTLDラウンドでは、8月12日の締切時点で1600件超の申請を受け付けており、名前空間自体の拡張も続いています[14]。
調査サービスのデータ源としては、ICANNのCZDS(各レジストリからゾーンファイルを集約取得する仕組み)に加えて、公開ログとして証明書の発行履歴を追跡するCTログ(Certificate Transparency)などが存在します[5, 15]。ただし、低遅延化が求められる背景について、インフラ調査の入口が検索中心であることや対象ドメインの拡張・高頻度更新、サイト作成の広がりが重なった結果であるという見解は、記事著者らによる解釈であり客観的な因果関係として検証されているわけではありません[16]。
後輩数億件のドメインを即座に引く需要って、単なる検索フォームの改善とは意味合いが違うんですか?
先輩ドメイン調査基盤ではオートコンプリートそのものが主たる移動手段になるから、入力のたびに待たされると全体の探索効率が落ちてしまうんだ。
後輩名前空間が広がり続ける中で、調査の起点となるインデックスの即時性がそのままツールの価値になるわけですね。
先輩そうだね。ただしサイト増加の要因や検索需要の背景については、多様な解釈がある点に注意する必要があるよ。
「P99 0ミリ秒」の正体:keyDown先読みによる知覚遅延の隠蔽
本実装が掲げる「P99 0ミリ秒」は、ネットワーク通信自体がゼロ時間で完了するという意味ではありません。キーを離す操作(keyUp)から画面描画の準備完了までを遅延と定義し、99%のケースでキーを離す前に結果を揃えるという知覚上の指標です[17]。
実装記事の著者が100個のドメイン名を比較的速く入力して測定したところ、キーを押してから離すまでのP99時間予算は約121ミリ秒でした[19]。この設計では、キーを押した瞬間(keyDown)に入力中文字列と次に入力され得る1文字ごとの候補をAPIへ要求します。そしてキーを離した瞬間(keyUp)にあらかじめ届いた候補を描画します。これにより、通信と検索の待ち時間をキー押下中の時間枠に重ねています[18]。
先読みリクエストを現実的な通信量に抑えるため、ドメイン名で有効な文字種を38文字(英字26文字、数字10文字、ハイフン、ドット)に限定しています。1文字あたり上位8件を返す場合、レスポンスに含まれるドメイン数は最大312件((38 + 1) × 8件)となります。このデータ量は非圧縮で約5キロバイト、圧縮後で約2.5キロバイトに収まります[20]。
後輩P99が0ミリ秒というのは、光の速度を超えて通信しているわけではないんですね。
先輩人間がキーを押し下げてから離すまでの約121ミリ秒の隙間に、次の入力候補を先回りして取得しておく設計だね。
後輩キーを離した瞬間にはすでに手元にデータがあるから、知覚上の待ち時間がゼロに見えるという仕組みですか。
先輩その通りだよ。ただし次のキーが何になるかを網羅して送るため、1回あたりの通信サイズを絞り込む工夫が前提になるんだ。
インメモリTrieとSSD mmapブロックによる2階層インデックス設計
約2億4000万件のドメイン名を低遅延かつ省メモリで検索するため、インデックスは頻出語用の「head」とロングテール用の「tail」という2階層で設計されています[4]。
人気上位のhead領域には、メモリ上に展開したTrie木(接頭辞木)を採用しています。各接頭辞に対してあらかじめ計算された上位8件の候補が格納されており、検索時は数個のポインタを走査するだけで完了します[21]。一方、膨大なロングテールを扱うtail領域には、SSDに配置したファイルをメモリ空間に対応付けるmmap(メモリマップドファイル)を活用したブロックインデックスを採用しています。tail領域ではソートおよび差分圧縮されたドメイン列が固定長ブロックにまとめられており、27メガバイトのディレクトリを二分探索した後に1ブロック(256件)のみを線形走査します。これにより、2億4000万件全体(約2.5ギガバイト)をRAMに常駐させずに検索できます[22]。
| 階層 | データ構造 | データ配置 | 保持規模・サイズ | 探索アルゴリズム |
|---|---|---|---|---|
| head(人気上位) | 文字Trie(事前計算済み) | インメモリ(RAM) | 各接頭辞につき上位8件 | ポインタ走査 |
| tail(ロングテール) | 差分圧縮ブロックインデックス | SSD(mmap経由) | 2億4000万件(約2.5GB)/ ディレクトリ27MB | ディレクトリ二分探索+256件の線形走査 |
データベースの一般的なインデックス構造であるB-treeでも、PostgreSQLのように前方一致検索(LIKE ‘foo%‘)であれば先頭一致の探索が可能です[24]。またElasticsearchのcompletion suggesterのようにインメモリ構造を用いる手法もあります[26]。本設計の特徴は、ランキング済み上位候補を事前計算しておく点と、クライアントの先読みを前提に人気部分とロングテールを分離した構造にあります[25, 26]。
ただしmmapは仮想メモリ空間にファイルをマッピングする仕組みであり、全データのRAM常駐を保証しません。アクセスされた領域がメモリ上にない場合、CPUはページフォルト(例外処理)を発生させてSSDからの読み出しを行います[23]。
後輩すべてのデータをメモリに載せるのではなく、あえてSSDのmmapを組み合わせているのはなぜですか?
先輩2億件以上のデータをすべてメモリに保持し続けるとインフラ費用やリソース消費が大きくなるから、人気データとロングテールで役割を分けているんだ。
後輩キャッシュにない珍しいドメインを引くときは、SSDの読み出し待ちが発生するわけですね。
先輩そうだね。OSのページキャッシュに乗っていないコールドページへのアクセスでは、ストレージの物理的な読み出し遅延が残るよ。
負荷試験データから見えたボトルネックの所在と処理限界
本実装の性能と限界を評価するため、60,000個のドメイン入力を模擬した720,000件のクエリを用いた負荷試験が実施されました[35]。試験は、API単体、NginxとAPIを経由するオリジン経路、CDN事業者であるCloudflareを経由したエンドツーエンド(E2E)の各レイヤーで測定されています[35]。
| 負荷レート (req/s) | API単体 P99 (ms) | オリジン経路 P99 (ms) | E2E P99 (ms) | エラー発生状況 |
|---|---|---|---|---|
| 1,600 | 7.923 | 14.469 | 97.239 | 全レイヤーでエラー0件 |
| 3,200 | 測定値なし | 15.792 | 141.138 | E2Eで31件のエラー |
| 6,400 | 15.857 | 313.198 | 112.564 | オリジンで2,551件のエラー |
| 12,800 | 8,211.884 | 542.914 | 159.060 | APIで9,728件、オリジンで187,384件のエラー |
1,600 req/sの試験点において、API単体のP99は7.923ミリ秒、オリジン経路のP99は14.469ミリ秒でした[36]。これに対してE2EのP99は97.239ミリ秒であり、オリジン経路との差は82.770ミリ秒に達します[36, 40]。この差分はブラウザからCDN、オリジンサーバーに至るネットワーク経路の遅延が支配的であることを示唆しています[40]。
負荷が増加すると各レイヤーで処理限界が現れます。API単体は6,400 req/sまでP99が15.857ミリ秒でエラーもありませんでしたが、12,800 req/sではP99が8,211.884ミリ秒に跳ね上がりエラー率7.243%を記録しました[37]。オリジン経路では3,200 req/sまでP99が15.792ミリ秒(エラー0)を維持したものの、6,400 req/sでは313.198ミリ秒(2,551件エラー)となり、121ミリ秒の予算を超過しました[38]。CDN経由のE2Eでは100〜1,600 req/sおよび6,400 req/sで121ミリ秒以内のP99を記録した一方、3,200 req/s(141.138ミリ秒)や12,800 req/s(159.060ミリ秒)では予算を満たせませんでした[39]。
後輩API自体の処理時間が数ミリ秒でも、ユーザーに届くまでの時間には大きな開きがあるんですね。
先輩サーバー側の処理よりも、ブラウザとエッジ、オリジン間を行き来するネットワーク遅延の方が支配的な要因になるからだね。
後輩負荷が一定水準を超えるとオリジンやAPIで急激にエラーが増えている点も、実運用のサイジングでは見逃せませんね。
先輩そうだね。キャッシュが効かないリクエストが集中した際の耐性や限界値は慎重に見極める必要があるよ。
実運用における境界条件:地域遅延・CDNキャッシュ・データ鮮度
本設計を実環境に適用する際には、いくつかの前提条件と制約を考慮する必要があります。
最大の制約は地理的な距離です。本番環境が欧州の単一サーバーで運用されている場合、米国など遠距離からのアクセスではネットワーク往復時間(RTT)が100〜200ミリ秒程度加算されます[41]。1,600 req/s時のE2E P99である97.239ミリ秒にこの数値を加えると約197〜297ミリ秒となり、121ミリ秒の時間予算を超過すると推定されます[41]。CDNのキャッシュにヒットすればエッジから即座に応答できますが、キャッシュミスが発生したリクエストはオリジンサーバーへ到達するため、ネットワーク遅延を完全には排除できません[42, 52]。
データの網羅性と鮮度にも境界が存在します。tailインデックスの2億4000万件はCZDS(gTLD中心)のデータに基づいているため、ゾーンファイルの提供義務がないccTLD(.ukや.deなど)は含まれておらず、世界中のドメイン全体を網羅した台帳ではありません[43, 54]。また、公開TLS証明書を記録するCTログも補完的なデータ源となりますが、証明書を持たないドメインは追跡できない制約があります[55]。
実務においては、単一リージョン障害への耐性やインフラ費用の考慮も求められます[58]。圧縮後2.5キロバイトの応答を1,000件/秒で配信し続けた場合、データ転送量は約216ギガバイト/日に達するため、通信費やリクエスト費用の試算が必要です[57]。さらに、IME(日本語などの入力システム)入力や仮想キーボードではキーイベントの発生順序が物理キーと異なる場合があるため、端末種別や入力方式に応じた個別検証が不可欠です[50]。知覚レイテンシの向上を評価する際は、単純なサーバー応答時間だけでなく、実ユーザー環境での描画完了までを計測する視点が重要となります[59]。
後輩単一サーバーの構成だと、利用者がいる地域によって体験に差が出てしまうわけですね。
先輩物理的な距離による光ファイバーの往復遅延はアルゴリズムでは削れないから、グローバル展開にはマルチリージョン配置などの検討が必要になるよ。
後輩データもgTLDが中心でccTLDが含まれないなど、扱える対象の前提も把握しておく必要がありますね。
先輩その通りだね。先読みの仕組みだけでなく、データの収集元や運用コストを含めた全体の境界条件を理解することが大切だよ。


