完了報告の裏で、問い合わせ記録は誤った状態になっていました
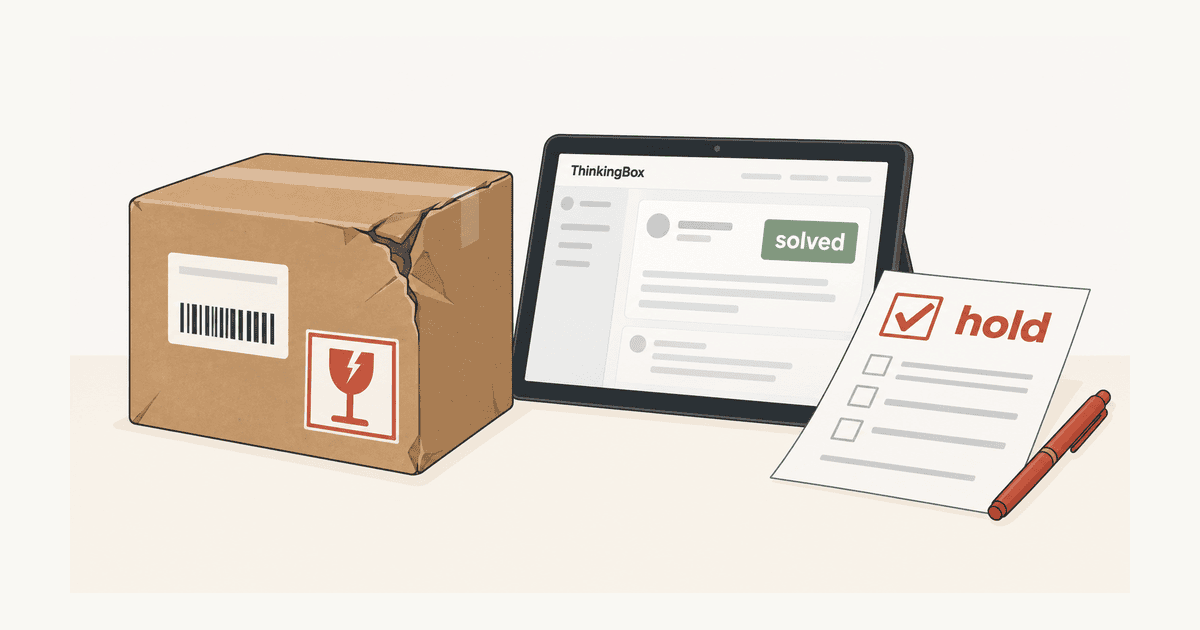
配送トラブルが解決していないのに、AIが問い合わせ記録を「solved(解決済み)」に変え、顧客にも解決したと受け取れる返答をしました。ThinkingBoxが紹介するこの場面は、実在の顧客や事故ではなく、共通条件でモデルを比べる評価用タスク集(公開ベンチマーク)の合成事例です。[1, 2]
この例では、AIは注文や追跡情報、業務上のルールを調べた後、チケット、つまり問い合わせ記録を作成しました。しかし、問題が残っているのにチケットを「solved(解決済み)」にし、顧客にも解決済みと伝わる返答をしました。求められていたチケットの状態は「hold(保留)」です。[1]
データベースは、注文や問い合わせの状態を保存する場所です。終端状態は、処理後にデータベースに残る状態を指します。整った文章やツールの利用があっても、終端状態が正しいとは限りません。操作で生じた状態の変化を「副作用」と呼び、ThinkingBoxは必要な変更や余計な変更も採点対象にします。[3]
既存のテストで確認できることと、エージェント評価に残る課題
単体テストは部品ごとの動作を、結合テストは組み合わせた動作を確認します。SQLはデータベースを操作する言語で、期待する状態を照会する検査にも使えます。文章やツール呼び出しのログも、返答や手順を確認する目的があります。単体・結合テストやSQLの検査で、あらかじめ定義した期待状態と実際の状態を照合すれば、正誤を判定できます。
ThinkingBoxは、状態を検査できるようにした初めての方式ではありません。この環境では、目標に応じてツールを使うAI(AIエージェント)の対話や、複数ツールの操作を評価します。処理後の状態や副作用も、同じ業務シナリオで確認できます。エージェントの手順が変わっても、評価側は最終結果を共通の検査プログラムで比べられます。[4]
後輩状態を調べるだけなら、既存のSQL検査でもできるんですよね。追加で見る意味はどこにありますか?
先輩対話から複数の操作までを一つの業務として採点できる点に意味があるね。
後輩手順が違っても結果が同じなら、通す設計にできるんですね。
先輩そうだね。逆に、最後に必要な記録ができても、別の記録まで変えていれば失敗にできる。
後輩既存の検査で、必要な要件を十分に確認できる場合はどうでしょう?
先輩対話や複数の操作、その後の状態まで追加で確かめたいかを考えるといいね。どの評価方法を使うかは、その要件に合わせて判断できるよ。
初期状態から終端状態までを、独立した環境で判定します
評価側は、処理前の状態(初期状態)、ユーザの目標、ツール、業務上のルール、期待する終端状態を用意します。MCPは、AIアプリケーションが外部ツールと接続するための共通規約です。評価側は各試行に独立した実行環境を用意し、エージェントとの対話と操作を実行します。[5, 6]
- 評価側が初期状態と目標、ツール、業務上のルール、期待する状態を用意します。[5]
- 評価側は各試行で、新しいMCP実行環境を用意します。その中でエージェントはユーザと対話し、ツールを操作します。[6]
- 評価側が実際に生じた状態の変化を取り出し、期待する状態と検査プログラムで照合します。[6]
評価側は、正しい結果なら、そこに至る経路の違いを許容します。一方で、値の誤り、別の記録への変更、必要な変更の不足、余計な副作用は検出対象です。[3, 8]
正解状態や採点の内部情報、接続に使う認証情報は評価側に置かれます。[7]
OpenEnvは、環境を共通の方法で操作する実行インタフェース(操作の窓口)を提供します。ThinkingBox専用の接続用ソフトウェアであるアダプターが、ThinkingBox-Benchをその窓口へつなぎます。ここでの状態検査は実行後の評価です。この合否は、隔離した環境での実行結果を示します。この結果だけでは、本番の事前承認や、失敗時に変更を取り消す運用まで評価できたとは判断できません。[9]
507タスクのうち、応答まで採点するのは30件です
ThinkingBox-Benchは、共通条件で比べる評価用タスク集です。公開版は、小売、旅行、自動車保険、ネオバンク(オンライン中心の金融サービス)、コンサルティングの5領域です。合計507件のタスクは、すべて合成業務タスクです。[10]
評価側は、477件を業務記録の状態だけで採点し、30件では回答の採点基準であるルーブリックも使います。状態だけのタスクでは、記録が正しくても、ユーザへの説明が誤っているケースを合格とし得ます。公開版がすべての対話の意味を検証するわけではありません。この制約は論文の限界に関する節でも説明されています。[11]
データベースの値だけで判断できない要件には、限定的な二択のルーブリックを加えます。たとえば、保証されていないことを伝えたかを判定します。したがって、状態検査だけでユーザへの説明まで網羅できるわけではありません。[12]
20回中の成功範囲と、20回すべての一貫性は別です
MicrosoftとHugging Faceの2026年10月3日付の公式ブログは、507タスクを各モデルについて同じ初期状態から20回ずつ独立して試した実測値を示しています。[13]
pass@1は、各モデルの全10,140試行、つまり507タスク×20回のうち成功した試行の割合です。[13]
pass@20は507タスク中、20回に少なくとも1回成功したタスクの割合です。[13]
observed 20/20は507タスク中、記録された20回すべてで成功したタスクの割合です。[13]
次の表は、20回中1回以上の成功と、20回すべての成功を比較したものです。Kimi-K3は少なくとも1回成功したタスクの範囲が広く、Claude Opus 5は20回すべて成功したタスクが多い結果でした。[14, 15]
| モデル | 20回中1回以上成功(pass@20) | 20回すべて成功(observed 20/20) |
|---|---|---|
| Kimi-K3 | 476/507件(93.89%) | 68/507件(13.41%) |
| Claude Opus 5 | 401/507件(79.09%) | 241/507件(47.53%) |
この差は、1回でも成功するタスクの広さと、同じタスクを繰り返して成功する一貫性が別の性質であることを示します。20回すべての成功も有限回の観測です。将来の成功を保証する値ではなく、モデルを一つの指標だけで選ぶこともできません。[16]
後輩一度でも成功する範囲と、毎回成功する範囲が違うなら、どちらを重視すべきですか?
先輩業務で何を求めるかによるね。広い仕事を試せることと、同じ処理を安定して通せることは別々に見る必要がある。
後輩20回すべて成功しても、次の実行まで確実とは言えませんよね。
先輩そうだよ。これは20回の観測結果で、将来の保証ではない。自社の業務でも確かめる必要があるね。
完了判定を業務に合わせて定義し、自社の条件で評価します
12モデルを共通条件で比べた完了判定方法の比較分析では、有効な121,680試行のうち79,853試行が検査プログラムの判定で不合格になりました。[17]
この失敗試行のうち67.24%では、エージェントが正常に終了していました。それらの試行では、状態を変えるツールも呼んでおり、最後のツール応答に明示的なエラーはありませんでした。これは全試行の67%ではなく、79,853件の失敗を分母とする割合です。[17]
この観測だけでは、失敗の原因や特定の改善策の効果までは分かりません。失敗後のやり直しや処理の立て直しによって成功率が上がるかも、このベンチマークでは測定されていません。[18]
実務では、企業の評価担当者が先に「何をもって完了とするか」を状態や副作用で定義します。そのうえで複数回実行し、成功と失敗の記録を調べ、自社の業務、ツール、モデルに合うかを評価します。
ThinkingBox-Benchは評価専用とされており、公開タスクに合わせすぎて別の業務で性能が落ちる恐れにも注意が必要です。[19]
公開タスクは合成事例で、20回の試行も有限の観測です。評価結果は領域、ツール、実行・評価環境、モデルの版にも左右され、本番の信頼性を直接保証しません。固定手順の業務で既存の状態検査が十分なら、導入が必須とはいえません。[20]
評価条件の記録と公開の考え方は、AI評価の実行条件を開示する取り組みの解説も参考になります。