小さなパケットの処理でCPUの負荷が高まる理由
KNODは、オペレーティングシステム(OS)の中核であるLinuxカーネルの管理下で、ネットワークパケットをGPUに処理させる開発中の仕組みです。GPUは、多数の処理を並列に実行する計算装置です。2026年10月7日のLinux Plumbers Conference(LPC)で、開発の進展が報告されました。[9, 1]
対象となる課題は、大量の小さなパケットを振り分ける処理です。通常のLinux受信経路では、ドライバが受信処理や送信完了の回収を行います。パケットごとの処理が増えると、CPU(中央処理装置)の負荷も高まります。[4]
例えばL4負荷分散では、接続情報からハッシュ値を求め、同じ接続を同じ振り分け先のサーバ(バックエンド)へ送ります。ハッシュ値は、入力情報を一定の長さに変換した値です。L4は、アプリ間のデータ配送を担うトランスポート層を指します。この振り分け判断も、パケット処理の一部です。[5]
XDPは、受信の早い段階で小さなプログラムを動かす仕組みです。通常の上位ネットワーク処理の一部を省けますが、CPU上のXDPでは、プログラムをCPUが実行します。単位時間あたりのパケット数を示すパケットレートが高い場合は、CPUコア数も処理能力の上限を左右します。[6]
本稿では、まず既存のCPU上のXDPで要件を満たせるか確かめることを提案します。既存構成に余力がある場合は、現在の方式を維持する選択肢もあります。
既存のGPU処理と何が違うのか
GPUによるパケット処理は、KNOD以前から存在します。
DPDKは、ユーザ空間でパケット処理を行う開発キットです。PMD(Poll Mode Driver)は、ネットワークインタフェースカード(NIC)の受信・送信キューを、割り込みに頼らず繰り返し確認するドライバです。このドライバは、カーネルのネットワークスタックを迂回して送受信します。gpudevライブラリは、GPUメモリ上のパケットプール(パケット用に確保したバッファ群)などを支援します。GPU側の処理を起動する機能は、別途組み合わせます。[10]
NVIDIAのDOCA GPUNetIOには、CUDA(NVIDIA GPU向けの開発基盤)プログラムからNICへ送受信を指示する構成もあります。DOCA GPUNetIOでは、CPUによる初期設定後、データ経路をGPU上で動かします。[11]
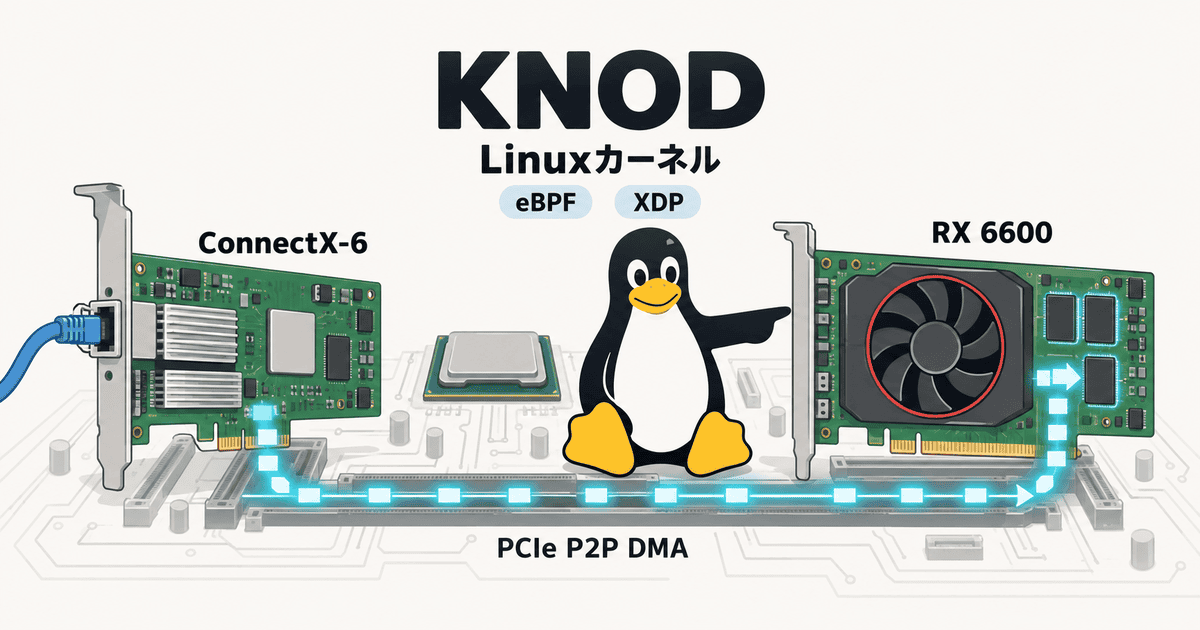
KNODの特徴は、Linuxカーネルの管理下でGPUをパケット処理に使う点です。eBPFは、検証済みの小さなプログラムをカーネルなどで動かす仕組みで、XDPでも使われます。KNODは、XDPプログラムをJIT(実行時に機械語へ変換する処理)でGPU用の機械語へ変換します。GPUは、パケット単位で処理を並列実行します。[9]
| 方式 | 処理を動かす側 | GPUとの関係 |
|---|---|---|
| CPU上のXDP | Linuxカーネル | XDPプログラムはCPUが実行 |
| DPDK+GPU処理 | ユーザ空間のアプリ | GPUメモリ管理と処理起動を組み合わせる |
| KNOD | Linuxカーネル | XDPをGPU機械語へ変換して実行 |
この比較は、実行経路の違いを示しています。[6, 10, 9]
KNODのパケット処理経路は、CUDAやROCm(AMD GPU向けの開発基盤)に含まれるユーザ空間ランタイムを介さずに動作します。機器の設定や管理は、引き続きホスト側が担います。[9, 8]
NICからGPUへ直接渡し、I/OもGPU側へ移す
KNODでは、GPUのVRAMを受信バッファとして使います。VRAMはGPU用のメモリです。NICは、PCIe P2P DMA(CPUのコピー処理を介さない装置間の直接メモリ転送)によって、パケットをVRAMへ書き込みます。経路は公式講演資料18頁で確認できます。
PCIeは周辺機器を接続するバスです。DMAは、CPUのコピー処理を使わずに装置がメモリへ転送する仕組みです。ここでのP2Pは、装置間の直接転送を指します。NICは受信データをGPUメモリへ書き込みます。ホストCPUは設定や管理に加え、ホストOSが通信を処理するソフトウェア群(ネットワークスタック)へ渡すXDP_PASSの処理を担います。[8]
2026年7月19日のRFC(実装案を公開して意見を求める提案)では、パケットをまとめてGPUへ指示するバッチ方式が示されました。CPU側の処理担当スレッド(worker)がパケットをまとめ、GPUシェーダー(GPU上の処理プログラム)をバッチごとに起動していました。GPUから戻った判定は、ドライバがNAPIでパケットに適用します。NAPIは、割り込みとポーリングを組み合わせるLinuxの受信処理機構です。[2]
次の段階では、GPU上で起動したまま処理要求を待つ常駐シェーダーを使い、バッチごとの起動・完了サイクルをなくしました。ただし、この段階では、CPUがパケット付随情報(メタデータ)を配信し、判定を処理する作業が残っていました。[7]
10月資料で示された現行のGDA(GPU主導のパケット入出力方式)では、GPUがNICの受信処理の完了を記録するキューを監視します。GPU側が送信要求と受信バッファの返却を扱い、受信・送信ループをGPUへ移す構成です。[8]
CPUには初期設定と管理の作業が残ります。XDP_PASSで通常のホストネットワークスタックへ渡すパケットも、CPU側が処理します。削減する対象は、受信・送信ループに伴うCPUの作業です。[8]
後輩GPUで判定するだけでなく、受信完了の監視や送信も移したんですね。
先輩そうだね。CPUが毎回バッチを用意する仕事を減らす設計になっているよ。
後輩それでも通常の通信スタックへ渡すパケットはCPUの仕事なんですね。
先輩初期設定や管理も含めて、CPUに残る処理を分けて考える必要があるね。
開発者測定の条件と電力値の読み方
講演資料の比較は、開発者がRX 6600搭載機でKatran(L4負荷分散ソフトウェア)を測定した結果です。CPUの同時マルチスレッド機能は、1つのコアで複数のスレッドを扱う機能です。開発者はトラフィック生成ツールT-Rexから64バイトのパケットを送り、この機能を有効にして測定しました。[13]
被測定機は、Threadripper 5945WX(12コア・24スレッド)、RX 6600、ConnectX-6です。送信側は、Ryzen 9 3900XとConnectX-6 Dxでした。[12]
Mppsは、毎秒100万パケットを表します。
| 構成 | スループット |
|---|---|
| CPU-only | 64 Mpps |
| 7月RFC構成 | 32 Mpps |
| Persistent+Stagger | 51.1 Mpps |
| GDA構成 | 64 Mpps |
CPU-onlyとGDAは、どちらも毎秒6400万パケットです。[14]
Persistent+Staggerは、講演の比較図に記載された中間段階の構成名です。この段階の51.1 Mppsと、GDAの64 Mppsは分けて読みます。[14]
資料の電力比較では、CPU-onlyが170 W、GDAが113 Wです。GDAの内訳は、CPUが49 W、GPUが64 Wでした。[15]
電力値は、図に示されたCPUとGPUの比較として読みます。NICを含むサーバ全体の電力は、別途計測が必要です。
本稿では、開発者の講演資料を確認して解説しています。導入を評価する際は、実際のGPUやパケットサイズを使って独立した測定を行うことを提案します。遅延についても、別途実測して判断します。
対応範囲と、試験前に確認すること
講演資料の時点では、別の送信先へ振り向けるXDP_REDIRECTに対応していません。常駐シェーダーを動かしたままの待機時にも、約24〜26 Wの消費電力が報告されています。[17, 16]
資料では、PCIe x8(8レーン接続)で64 Mpps、x16(16レーン接続)で約90 Mppsという上限を挙げています。原因としてPCIe経路やNIC機能を疑っていますが、確定していません。測定ごとにGPUも異なるため、機器と接続の組み合わせごとの測定例として読みます。[18]
KNODはRDNA2世代のGPUを中心に開発され、10月資料にはRDNA3の測定例もあります。RDNA2とRDNA3は、AMD GPUの設計世代です。Intel Arcと内蔵GPUは、講演で今後の作業(TODO)に挙げられています。[19]
講演資料44頁のNICに関するTODOには、Broadcom bnxtとIntel iceもあります。7月RFCへのパッチ掲載と、現在の動作保証は分けて評価します。
RFCのNIC統合には、受信サイズや送信設定の制約もあります。NICごとのMTUに応じた受信制約や送信設定、PCIe P2P経路を含め、実際のGPUとNICの組み合わせを確認する必要があります。MTUは、ネットワーク区間で一度に転送できるデータの最大サイズです。IPパケットなどのサイズは、この値に収まる必要があります。[21]
IPsecは、IP通信を保護する仕組みです。受信側のRX IPsecも、7月RFCでは、本番向けの堅牢化が残る機能実証と位置付けられています。[20]
本稿では、公開RFCとLPCの開発報告の範囲で説明しています。標準カーネルへの採用や一般提供を判断する際は、それぞれの状況を確認する必要があります。カーネル内の各機能の責務分担にも、設計課題が残っています。[3]
以上を踏まえ、本稿では検証計画を立てるため、次の確認を提案します。
- 既存のCPU上のXDPで、実際の通信量と処理内容をさばけるか。
- GPU・NIC・MTU・PCIe経路が対象の実装に合い、XDP_REDIRECTが必須ではないか。
- XDP_PASSの割合を含む実負荷で、CPUの余力と処理性能がどう変わるか。
- 遅延の分布と、GPUやNICの停止時の損失・復旧を確認できるか。
- NICを含むホスト全体の電力を、待機時と実負荷時にCPU-only構成と比較できるか。
GPU停止時には、代替経路へ切り替えるか、明示的に処理を止めるかも含め、復旧方針を確認します。KNODの試験では、パケット処理を別の計算資源へ移す設計が、自分のCPU制約と運用条件に合うかを評価します。