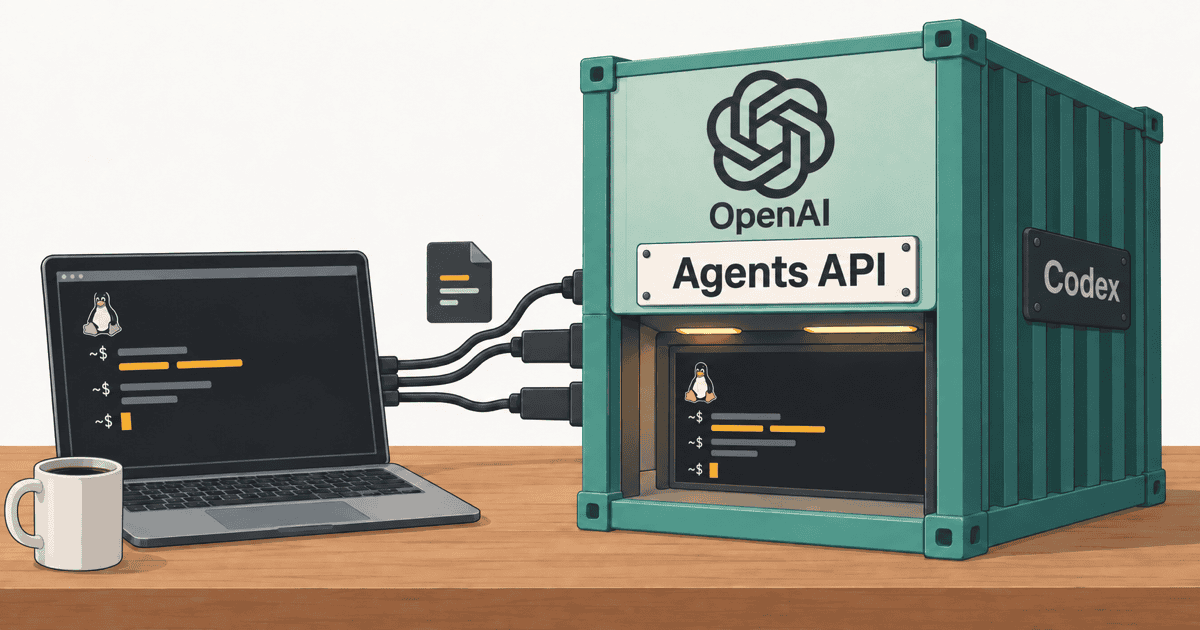
OpenAIが「Agents API」を公開しエージェント実行基盤を提供します
OpenAIは2026年9月10日、長時間タスクの実行を支える「Agents API」をパブリックベータとして全開発者向けに公開しました[1]。本記事では、Agents APIとは何か、何ができるのか、料金体系や導入時の制約を主軸として解説します。また補足として、他社基盤との比較やプロトコル標準化の動向も取り上げます。本APIは、OpenAIが管理するAPI上でCodex(コーディング特化AI)のエージェント・ハーネス(実行制御基盤)を動かすクラウドサービスです[2, 3]。API利用者は、必要なモデル、指示、ツール、入力データ、実行環境を指定して実行を開始できます[2]。ただしセルフホスト環境を利用する場合は、環境の起動や接続、ライフサイクル管理などの利用者側の責任も伴います。モデルAPIや低レベルのResponses APIとは異なり、Codexのハーネスをマネージドなクラウドランタイムとして提供する上位層に位置付けられます[4]。
Agents APIでは、OpenAIがセッション管理やエージェントのオーケストレーション(統合制御)、コンテキスト自動圧縮、障害後のリカバリー(復旧処理)を担います[5]。利用者は主にツールを用意し、実行環境を選択します[5]。本機能はコード実行やファイル編集、MCP(外部ツール接続規格)接続、成果物生成をエージェントの能力として抽象化します[6]。これにより、コード実行や成果物生成を伴う長時間のタスクを同一セッション内で継続できます[6, 7]。OpenAIホスト型を選べば、エージェントハーネスやセッション基盤の自前実装・運用を減らせる点が本基盤の強みとされています[8]。
エージェントが動作する環境は、OpenAIホスト型サンドボックス(隔離された実行環境)、自社管理のセルフホスト環境、対応するパートナー環境から選べます[9]。OpenAIホスト型では、PythonやNode.js、CLIツールを備えたLinuxワークスペースが自動で準備されます[10]。セルフホスト環境では、利用者のアプリケーションが環境を起動し、エグゼキューター(実行プログラム)をセッションへ接続してライフサイクルを管理します[11]。
外部ツールとの接続では、MCP接続に対応しています[12, 13]。OpenAIサービス側からのHTTP接続、実行環境からのHTTP接続、環境内プロセスとして起動するstdio(標準入出力)接続の3方式をサポートします[12, 13]。環境起点のHTTPおよびstdioを利用する際は、セッションに紐づく実行環境が必要です[13]。認証情報はセッション単位の暗号化設定やVault(機密情報管理基盤)で管理できます[12]。ネットワーク制御は有効、無効、許可ホスト限定の3種類から選択可能です[14]。ただしOpenAIホスト型のstdio MCPでは無効や限定設定が利用できず、ネットワークを有効にする必要があります[14]。
ツール呼び出しの制御もハーネス側で集約されます。ツールの検索やプログラムからの呼び出し、並列実行や結果の絞り込みをエージェントハーネス側で扱います[15, 16]。さらに、複雑な作業を独立したサブエージェントへ分割・委譲するマルチエージェント機能も組み込まれています[17]。各サブエージェントは固有のコンテキストを持って並列に実行され、メインエージェントがそれらの結果を統合します[17, 18]。
エージェントとの対話はセッション単位で保持されます。セッションはエージェントの設定や会話、保存済みの作業を保持し、同一セッションへ追加メッセージを送ることで作業を継続できます[19]。長時間セッションでコンテキスト上限に近づくと、APIが過去のコンテキストを自動で圧縮します[20]。この圧縮処理では、過去の状態や推論を少ないトークンで引き継ぐ暗号化された圧縮項目を含む新しいコンテキストウィンドウが生成されます[21]。開発者は独自の圧縮ロジックを実装することなく、複数のコンテキストウィンドウをまたいで作業を進められます[20]。
セッションの進行状況は、非同期のイベントストリームを通じてリアルタイムに受信できます[22]。ただしストリーム切断時に欠落したイベントは再送されません[23]。そのため利用者は新しいストリームを開きつつ、セッション取得APIで保存済みアイテムを取得してローカル状態を復元する必要があります[23]。また、状態変化を通知するWebhookも提供されています[24]。Webhookは署名検証に対応していますが、詳細な関数呼び出しの引数や環境IDはセッション取得APIで確認する仕様です[24]。
OpenAIが提供する他の開発手段との差別化も整理されています。Responses APIはモデル呼び出しと組み込みツールを組み合わせる低レベル寄りのAPIプリミティブです[25]。またAgents SDKは、利用者のアプリケーション側でエージェントループを実行し、サーバが状態保存や承認を所有します[26]。これらに対しAgents APIは、ハーネス運用とセッション基盤をクラウド上のマネージドサービスとして提供します[26]。Agents API自体の追加利用料はなく、選択したモデルやツール、OpenAIホスト型サンドボックスのコンテナ料金がそれぞれ標準レートで課金されます[27, 28]。
公式料金表における各主要モデルの標準利用料金は以下の通りです[29]。
| モデル名 | 入力料金(USD / 100万トークン) | 出力料金(USD / 100万トークン) |
|---|---|---|
| GPT-6 Astra | 10.00 | 50.00 |
| GPT-5.6 Sol | 4.00 | 20.00 |
| GPT-5.6 Terra | 2.00 | 12.00 |
| GPT-5.6 Luna | 0.20 | 1.20 |
後輩実行基盤をクラウドに任せられるなら、開発者はプロンプトとツールを用意するだけで済みますね。
先輩サーバ側の運用負担は大幅に減るね。ただし、実行ループの細かな制御権を手放すトレードオフがあるよ。
後輩途中で処理に介入したり、独自の復旧手順を入れたりしたい場合は難しくなりますか?
先輩その通りだね。細かく制御したいなら従来のSDK、運用の自動化を優先するならAPIという使い分けになるよ。
なぜ今エージェント実行基盤が必要とされているのかを整理します
OpenAIがマネージドなエージェント基盤へと領域を広げる背景には、企業におけるAIの利用実態の変化があります。実運用におけるタスクは単発の質疑応答ではなく、過去の操作結果や承認履歴、ツール状態を引き継ぐ多段ワークフローへの移行が進んでいるとの見方があります[30]。
多段ワークフローへの移行に伴い、開発現場では大きな課題が顕在化しました。状態の保存やツールの呼び出し、エラー処理、長時間タスクの安全な再開を、各社が自前で設計・実装しなければならなかった点です[31]。長時間のタスクを安全に再開させる基盤の構築は、多くの開発チームで負担となっていました[31]。
さらに、長時間のタスク実行ではコンテキストウィンドウの消費が問題となります。ツールの実行結果や中間推論がコンテキストを急速に圧迫するため、上限到達や品質劣化を防ぐ圧縮・選別ロジックが不可欠となります[32]。
また、エージェントを複数のサービスやサブエージェントに分散させると、古典的な分散システムの課題が生じます。ノード障害やネットワーク分断、メッセージ損失、カスケード障害、再試行やチェックポイントからの復旧への対応が求められます[33]。連携するツール数が増加するほど適切なツールの選択や引数の生成が難しくなり、不要な呼び出しによる計算資源の浪費も発生します[34]。最終回答の成否だけでは失敗箇所の特定が困難なため、実行トレースからツールの不安定性やループを診断する観測基盤も必要です[35]。
OpenAIはAgents APIにおいて、コンテキスト自動圧縮やツール検索、並列呼び出し、サブエージェント委譲をハーネス側に集約して対応しています[36]。こうした実行基盤の一体化はOpenAI固有の動きではありません。Googleも長時間のエージェント処理向けに状態保持とバックグラウンド実行を兼ね備えたAPIを提供しています[37]。OpenAI以外にもGoogleなどで同様の動きが見られます[37]。
後輩単にモデルの賢さを上げるだけでは、実用的なエージェントは作れないということですか?
先輩長時間動かすと、途中の通信障害やコンテキストのあふれといったインフラの課題が生じる可能性があるんだよ。
後輩まるで従来のマイクロサービスや分散システムを運用するような難しさですね。
先輩その通りだね。だからこそOpenAIやGoogleなど一部の主要各社では、推論APIの提供から実行状態を管理する基盤の提供が進んでいるんだよ。
他社が提供する主要なエージェント基盤との違いを比較します
Agents APIの立ち位置を理解するための補足として、他社が提供する主要なエージェント基盤との違いを比較します。エージェント実行基盤の市場では、OpenAI以外の主要各社も独自の強みを持ったソリューションを展開しています。各社のアプローチは、SDKによるきめ細かな自前制御を重視するものから、クラウドインフラや企業ガバナンスと一体化したものまで多岐にわたります。
Anthropicは、PythonおよびTypeScriptから利用可能なClaude Agent SDKを提供しています[38, 39]。これはClaude Codeを支えるツールやエージェントループ、権限管理、フック、チェックポイントなどの枠組みを直接扱える環境です[38, 39]。Agents APIと比較した場合、Claude Agent SDKは利用者のアプリケーション内でエージェントループを実行できます[38, 39]。
Googleは、包括的な統合基盤としてGemini Enterprise Agent PlatformおよびVertex AI Agent Engineを展開しています。Vertex AI Agent Engineは、マネージドランタイムやセッション管理に加え、IAMやVPC-SCによるアクセス境界、Cloud TraceやCloud Monitoringといった監視機能を統合しています[40]。さらにAgent Platformは、ADK(エージェント開発キット)によるマルチエージェント構築や、セッションを越えて記憶を保持するMemory Bank、Agent Registry、評価機能を備えています[41]。Agents APIがCodexの実行環境に特化した垂直統合型であるのに対し、Googleはライフサイクル全体を支える基盤として設計されていると評されています[42]。
Microsoftは、Azure環境でMicrosoft Foundry Agent Serviceを提供しています。設定のみでマネージド実行を行うPrompt agentsと、任意のコードをコンテナとして持ち込むHosted agentsを併設しています[43]。Hosted agentsでは、自動スケーリングやMicrosoft Entra IDによる専用ID付与、Azure RBAC、セッション状態保存、エンドツーエンドの可観測性が提供されます[43, 44]。企業のID管理やネットワーク分離、モデル選択を含めた包括的なガバナンス機能の広さにおいて、Foundryは強みを持つと指摘されています[45]。
AWSは、Amazon Bedrock AgentCoreを展開しています。モデルやフレームワークに依存しないランタイムを中心に、分離されたmicroVM環境でシェルやファイルアクセスを提供するManaged Harnessを備えています[46, 47]。メモリーやMCPゲートウェイ、ブラウザー操作、可観測性を個別に組み合わせて利用できるモジュール構造が特徴です[46, 47]。モデル中立で柔軟な構成が可能な反面、構成要素が多く設計や運用の難易度は高くなりやすいとされています[48]。
| 提供企業・サービス | 主な提供形態・アプローチ | 特徴と主な機能 | ガバナンス・連携 |
|---|---|---|---|
| OpenAI Agents API | マネージドランタイム型 | Codexハーネス運用、自動コンテキスト圧縮、サブエージェント調整 | 米国データレジデンシー限定、ZDR未対応 |
| Anthropic Claude Agent SDK | SDK制御型(+Managed Agents) | Python/TypeScriptでループ制御、Claude Code同等のツール・権限枠組み | 自社プロセス内でのきめ細かな権限管理やフック |
| Google Gemini Enterprise Agent Platform / Vertex AI Agent Engine | フルライフサイクルプラットフォーム型 | ADKマルチエージェント、長期Memory Bank、マネージドランタイム | IAM、VPC-SC、Cloud Monitoring/Trace連携 |
| Microsoft Foundry Agent Service | マネージド&コンテナ持ち込み型 | Prompt agentsとHosted agentsの併設、自動スケール | Entra ID、Azure RBAC、仮想ネットワーク分離 |
| AWS Bedrock AgentCore | モジュール型プラットフォーム | モデル中立Managed Harness、独立マイクロVM、MCPゲートウェイ | 各種フレームワーク対応、モジュール個別利用 |
各社の特徴を総括すると、Agents APIは最小限の指定でコード実行を伴う長時間タスクを素早く動かす用途に適していると考えられます[49]。一方で、基盤モデルの自由な選択や既存クラウドとの統合、企業ガバナンス、長期メモリーを重視する場合は、Google、Microsoft、AWSの基盤が適しているとみられます[49]。
後輩他社もエージェント基盤を出していますが、選び方の基準はどこにあるんでしょうか。
先輩単一の優れた実行環境を素早く使うか、既存の社内基盤や複数モデルと深く統合するかで分かれるね。
後輩すでに特定のクラウドで認証やネットワークを固めている企業だと、判断が分かれそうですね。
先輩既存のクラウドガバナンスに合わせるか、コード実行に特化した環境を優先するかを比較して選ぶ必要があるよ。
プロトコル標準化により開発手法と運用の何が変わるかを展望します
Agents APIを取り巻く環境を俯瞰する補足として、プロトコル標準化の動向を展望します。従来の自前実装では、モデル呼び出しやツール連携を開発者側で実装する必要がありました[50]。これに対しAgents APIのようなマネージド基盤では、セッション永続化や実行ループ、コンテキスト圧縮、イベント通知、障害復旧、サブエージェント調整までを実行基盤へ委譲できます[50]。OpenAI管理のハーネスにこれらを集約したAgents APIは、実行ランタイムにおける事実上の標準候補になり得ると指摘されています[51]。
実行基盤の進化と並行して、接続インタフェースの標準化も進んでいます。MCPは、LLMアプリケーションと外部データやツールを接続するJSON-RPCベースのオープン規格です[52]。ツール接続の標準化により、個別接続ロジックの実装負担を減らせる可能性があり、ツール層でのベンダーロックインが緩和されると期待されています[53]。ただしMCPの仕様自体はアクセス制御や承認を単独で強制できないため、実装側での厳密な監視や認可フローが不可欠です[54]。
さらに、エージェント間の協調やモデル推論層の標準化も進められています。Googleが提唱するA2Aは、異なるフレームワークやベンダーで構築されたエージェント同士の協調を標準化するプロトコルです[55]。またOpenAI互換APIは、vLLMなどの自前推論サーバから同一クライアントを利用可能にし、モデル基盤の切り替えコストを低減します[56]。これらにより、ツール接続をMCP、エージェント間通信をA2A、モデル呼び出しを互換APIが担う、相互運用可能な部品構成への移行が展望されています[57]。
しかしながら、プロトコルの標準化だけでエージェント運用のすべての課題が解消されるわけではありません。Agents APIのセッション管理やコンテキスト自動圧縮、障害復旧ロジックはCodexハーネスに依存するため、MCPを採用してもランタイム層への依存は残ると考えられます[58]。またOpenAI互換APIを用いても、ツールの並列実行可否などの挙動はモデル依存となるため、API互換だけではエージェント全体の挙動互換性は保証されず、追加検証や抽象化が必要になる可能性があります[59, 60]。
信頼性の確保においても、標準化の枠組みだけでは不十分な側面が存在します。マルチエージェントによる並列実行は作業速度を高め得る一方、サブエージェント間での前提不一致や重複作業、失敗の伝播、結果統合の誤りなどが起こり得るリスクとして挙げられます[61]。加えて、プロンプトインジェクション耐性や不確実性の表明能力を横断的に比較する厳密な標準手法は未確立です[62]。そのため、最終回答だけでなくツール呼び出しや思考過程を可視化する実行トレースと、多角的な評価基盤の運用が不可欠となります[63]。
後輩共通の規格が普及すれば、エージェントを別のサービスへ簡単に乗り換えられるようになりますか?
先輩ツールの接続部分は共通化できるけれど、セッション保持や実行手順の解釈は各基盤に依存したままだよ。
後輩インタフェースが揃っても、動かしたときの振る舞いまで同じになるとは限らないんですね。
先輩その通りだね。モデルによる判断の差やエラーの出方も違うから、基盤を移行する際の検証は不可欠だよ。
開発者やSaaS事業者に与える影響と導入時の注意点を検証します
OpenAIホスト型を利用する場合、開発者やスタートアップは状態保存や実行ループ、障害復旧、コンテキスト圧縮、サンドボックス運用の負担を減らせます[64]。少ないバックエンドコードで長時間タスクを担うエージェントを製品化できる点が、実務上のメリットとされています[64]。
公式ドキュメントでは、インシデント対応、Slack業務、読み取り専用SQLによるデータ分析、GitHubの課題調査、社内文書レビューなどが用途例として示されています[65]。これによりSaaS事業者は、高度な分析機能や開発支援機能の実装期間を短縮できる可能性があります[66]。ただし、顧客ごとのセッション分離やデータ保持期間、監査、費用上限の設定、人間による承認フローの設計などは、自社側で要件を確認・設計する必要があります[66]。
一方で、エンタープライズ領域への導入においてはデータ管理上の制約に注意が必要です。Agents APIのデータレジデンシーは現時点で米国のみに限定されており、Zero Data Retention(ZDR)には対応していません[67, 68, 69]。セルフホストサンドボックスを選択した場合であっても、Agents API自体はZDRの対象外となります[67, 69]。したがって、データ所在地に規制がある案件や、顧客契約でデータの即時破棄が義務付けられている用途への導入には慎重な検討が必要です[68]。
サンドボックスの権限分離設計も、利用者側の責任領域として残ります。エージェントが生成したコードは、環境に割り当てられたファイルや資格情報、ネットワークへアクセス可能です[70]。情報漏洩を防ぐため、ユーザやワークロードごとに環境を明確に分離する構成が求められます[70]。
運用監視と評価の面でも留意すべき点があります。現在のPlatformダッシュボードではセッションログやトレースの確認が可能ですが、公開ベータ版APIにはトレース取得APIや外部エクスポーターが含まれていません[71]。また、公開ベータAPIで独立した評価APIがどこまで提供されるかは、評価機能の公式仕様を確認する必要があります[72]。
これらの制約を踏まえると、自社の要件に応じた使い分けが重要になります。実行ループや承認、状態保存、ネットワーク境界、監査ログを厳密に制御したい場合や、既存基盤からの移行コストが大きい場合は、従来のAgents SDKや自社環境の継続利用が適していると考えられます[73]。
後輩自社のサービスに組み込む場合、どこまでをAPIに任せて、どこを自前で実装すべきですか?
先輩実行状態の復旧やサンドボックスは任せられるけれど、顧客データの保護や実行権限の分離は自社の責任だよ。
後輩クラウドに投げて終わりではなく、誰に何を許可するかという安全設計は自分たちで担保しないといけないわけですね。
先輩そうだね。特に機密性の高いデータを扱う場合は、データ保持ポリシーや監査の要件を事前によく見極める必要があるよ。


