なぜ今「コーディング専門性の崩壊」が議論されるのか
AIによるソフトウェア開発支援は、大きな転換点を迎えています。従来のツールは、エディタ上でリアルタイムに候補を提示する「AIペアプログラマ」としての役割が中心でした[1]。
しかし、最新のエージェント型ツールは役割を大きく広げています。コードベースの探索から複数ファイルの編集、コマンドやテストの実行、コミットやプルリクエストの作成までを自律的にこなします[2, 3, 4]。
こうしたツールの進化に伴い、開発者のスキル形成に関する議論が活発化しています。ここで論点となる「専門性の崩壊」とは、キーボードで構文を入力する速度が落ちることではありません。問題を分解し、適切な抽象化を選び、コードを理解してバグの原因を仮説化・検証・修正するという一連の判断力を、自力で発揮できなくなる状態を指すという見解が示されています[5]。
後輩AIがテストの実行やファイル編集までやってくれるなら、開発者は手作業から解放されて設計に集中できるんじゃないですか?
先輩確かに作業の効率化は進むね。ただ、設計の前提になるコード理解や問題分解の経験を積まないまま道具に頼ると、自力で正しさを判断する力が育ちにくくなる点が議論されているんだ。
後輩構文を覚えることではなく、正しく動いているかを見極める土台そのものが問題になっているわけですね。
誰にどのような影響が出ているのか:初心者と熟練者の格差
AIによる支援の影響は、開発者の経験レベルによって大きく異なります。一律にすべての開発者でスキルが低下するわけではありません[6]。
5年以上の経験を持つ開発者202人を対象としたGitHubの無作為化比較試験では、Copilot利用群は10個すべての単体テストに合格する確率が53.2%高くなりました。さらに、コードの可読性や信頼性、保守性などの評価も改善しています[7, 8]。
一方、経験の浅い初心者では異なる結果が報告されています。単一のプロンプトでプログラム全体を生成させる手法を用いた初心者33人の実験では、新規の作成課題での正答率は96%と高水準でした。しかし、その後にAIなしで行ったコード変更課題の正答率は62%まで低下しました[9, 10, 11]。
別の研究でも、初心者21人中20人がAIを用いて課題を完成させたものの、苦戦した学習者ほど自身の問題解決能力を過大評価する傾向が見られました。この現象は、理解していないのにできたと感じてしまう「能力の錯覚」と呼ばれています[12, 13, 14]。
さらに、Python実務経験者52人を対象にした実験では、新しい非同期ライブラリの学習直後に行ったクイズの平均点が、AI利用群で50%、手書き群で67%となりました。得点差は特にデバッグ問題で顕著に現れました[15, 16]。
なお、初心者69人を対象にした別の管理実験では、Codex利用によって作成課題の得点が向上し、AIなしの手動コード変更課題の成績も低下しなかった事例があります[17, 18]。このように、学習環境やタスク設計によって結果には幅が存在します。
後輩作成課題で96%も正解できたのに、コードを変更する課題になると62%まで落ちてしまうのはなぜですか?
先輩初心者が単一のプロンプトで全体を一気に生成すると、途中の処理や構造を理解する機会が省かれてしまうからだと分析されているよ。
後輩動くものが完成したことで「自分は理解できた」と思い込んでしまうのが、能力の錯覚なんですね。
何が起きているのか:自動化バイアスと認知的関与の低下
開発者がAIに依存する過程では、どのような認知的変化が生じているのでしょうか。約40万件のClaude Codeセッションを分析した調査では、人間が計画上の意思決定の約70%を担う一方、実行上の意思決定はエージェントが約80%を担っていることが確認されました[19, 20]。
この分業構造において課題となるのが、コード検証の形骸化です。眼球追跡を用いた視線調査によると、AIが生成したコードの複雑度や可読性が人間と同等であっても、開発者がAI生成コードに向ける視覚的注意は有意に少ないことが示されています[21, 22, 23]。この背景には、システムの出力を過度に信頼して確認を省いてしまう「自動化バイアス」が存在します。
また、エージェント利用者を対象とした調査では、タスクの進行に伴って開発者の認知的関与が低下する傾向が報告されています。現在のツール設計には、振り返りや意味づけを促す仕組みが不足していると指摘されています[24, 25]。
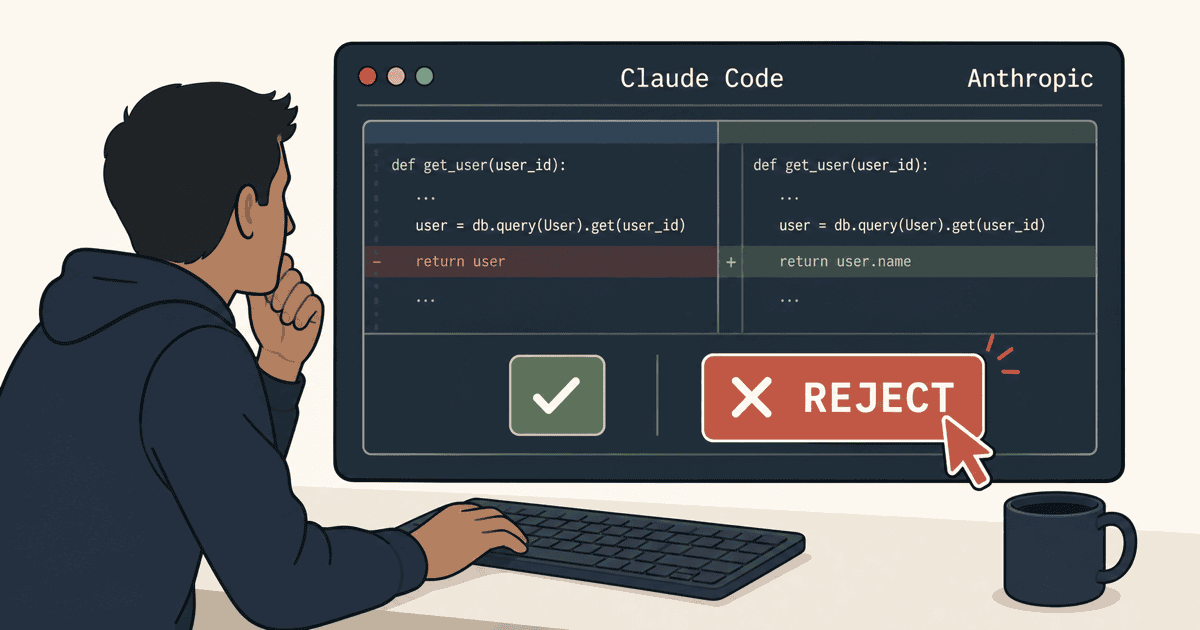
さらに、人間による承認操作も形骸化するリスクを抱えています。Anthropicのテレメトリーデータによれば、Claude Codeの権限確認プロンプトは93%の割合で承認されています。確認回数が重なることで「承認疲れ」が生じ、1回ごとの確認に対する注意力が低下する可能性が説明されています[26, 27]。
つまり、問題の本質は構文入力が自動化されることではありません。問題の分解、コード読解、バグ原因の仮説化、検証、不適切な提案の棄却といった認知プロセスを人間が反復する前に、AIが実行を完了してしまう点にあります[28, 29]。
後輩毎回手動で承認ボタンを押していれば、人間が監督していると言えるんじゃないですか?
先輩確認が何度も続くと、承認疲れによって注意力が落ちてしまうことが報告されているんだ。承認率が93%に達している背景にも、そうした要因が指摘されているよ。
後輩承認という手続きがあっても、内容を厳密に精査できているとは限らないわけですね。
品質とセキュリティの現実:生成コードが抱える潜在リスク
AIツールの導入は組織全体のデリバリー指標にも影響を与えています。Google Cloudによる2024年のDORA調査では、AI導入率が25%増加すると、文書品質が7.5%、コード品質が3.4%、レビュー速度が3.1%改善しました。一方で、配信スループットが1.5%低下し、配信安定性が7.2%低下するという関連も報告されています[30, 31]。
生成されるコード自体にも注意が必要です。AI生成コードは一見正しそうに見えても、意味的な誤りやセキュリティ上の脆弱性を含む場合があります[32]。
GitHub Copilotを対象にした89シナリオ・計1,689件のプログラム検証では、約40%に脆弱性が含まれていたと報告されています[33]。さらに、AI支援を利用した開発者は、利用しなかった開発者に比べて安全性の低いコードを書きやすく、同時に「自分は安全なコードを書いた」と誤信しやすい傾向も観察されています[34]。
また、著作権やライセンスへの配慮も求められます。GitHubのコード参照フィルターは、公開コードとの65語素以上の一致を検出します。ただし、一致が検出されたからといって直ちに著作権侵害に該当するわけではありません。ライセンスへの適合性や帰属表示の要否については、最終的に利用者が判断する必要があります[35]。
後輩コード品質が向上しているのに、配信の安定性が7.2%低下しているのはどうしてですか?
先輩AIで生成したコードを十分に検証しないまま反映すると、潜在的な不具合や脆弱性が残ってしまうリスクがあるんだ。
後輩出力されたコードを過信せず、開発者がテストや検証を徹底しなければならない理由がそこにありますね。
何が変わるのか:求められる新たな中核スキルと「Negative Expertise」
AIの活用が進むにつれて、開発者に求められる専門性の比重は変化しています。構文の暗記といった低レベルな記述スキルの相対的重要性は低下し、デバッグ能力、コード読解力、概念の理解、高レベルのシステム設計が重要視されるようになっています[36, 37]。専門性が不要になるのではなく、仕様化やアーキテクチャ設計、生成コードの検証へと再配分されるという指摘もなされています[38]。
中でも注目されているのが「Negative Expertise(ネガティブ・エキスパティーズ)」と呼ばれる能力です。これは、AIの有用な提案を受け入れるだけでなく、誤った提案や不適切な提案を即座に見抜いて棄却する力を指します[39]。初心者ほどこの選別力が未成熟であり、不適切な出力に引きずられやすいとされています。
教育現場では、このNegative Expertiseを育成する試みが始まっています。正しい提案ともっともらしい誤提案を比較させて選別させるクイズ形式の学習法が開発され、学習者の批判的思考や振り返りを促す効果が報告されています[40, 41]。
また、デバッグの学習においても、修正コードをそのまま受け取るのではなく、エラー原因の仮説を立ててテストで切り分けるプロセスを人間に残す設計(HypoCompass)により、デバッグ成績が12%向上した事例があります[42, 43]。
Anthropicの研究でも、AI利用を一律に有害とするのではなく、人間側の認知的関与を維持する対話パターンを取ることで、学習成果を損なわずにスキルを獲得できることが示されています[44, 45]。
後輩「Negative Expertise」って、要するにAIの間違いを疑う力のことですか?
先輩その通りだよ。もっともらしい誤りを見抜いて却下する力は、コードを正しく理解していないと発揮できない重要な専門性なんだ。
後輩AIの提案を鵜呑みにせず、なぜそのコードが駄目なのかを言語化できるかどうかが問われているんですね。
実務と教育における今後の向き合い方:多層的な検証と責任の保持
AIツールと健全に向き合うためには、開発プロセス全体での役割分担と検証体制の再構築が必要です。監督業務は単なる事後レビューにとどまらず、事前制御、共同計画、リアルタイム監視、事後レビューからなる多層的なアプローチが求められます[46]。
OpenAIの社内事例でも、開発者の役割は手動コーディングから、受け入れ条件の定義やエージェントの動作環境設計、結果の検証へと移行しています[47, 48]。AIへの委譲は低リスクで境界が明確な作業に限定し、受け入れ条件やテスト要件を事前に定義した上で、サンドボックス環境で実行することが望ましいとされています[49]。
品質と安全性を確保するための検証フローは、以下のような多層防御として設計することが推奨されています[50]。
- 仕様・受け入れ条件の確認
- 単体テストおよび統合テストの実行
- リンターや静的解析ツールによる検証
- 脆弱性・シークレット情報・依存関係・ライセンスの検査
- 隔離環境での再現確認と人間による最終レビュー
- マージ後の再検証
教育や未知の技術の学習においては、AIに実装を丸ごと委ねるのではなく、概念の質問や説明要求を交えながら段階的に進めることが推奨されます。そして最終的には、AIなしで自力で説明・変更・デバッグできるかを確認することが重要です[51]。
人間が保持すべき中核能力は、問題定義、設計、コード読解、デバッグ仮説の構築、そしてライブラリの概念理解やセキュリティ判断にあります[52]。AIは責任主体ではないため、コードの生成からデプロイに至るすべての工程において、人間や組織が意図と結果を説明できる状態を維持することが重要であると提起されています[53]。


