LinkedInの大規模AIコードレビュー基盤とは:週7.9万件を処理するマルチエージェント構成
LinkedInは2026年8月13日、公式Engineering Blogで自社の大規模AIコードレビュー基盤を公表しました[1]。この基盤の構築と運用は、同社のDeveloper Productivity Automationチームが担当しています[2]。
対象の開発環境は、10,000を超えるアクティブリポジトリと週数万件のプルリクエスト(PR)を抱える規模です[3]。AIコードレビュー基盤は、典型的な週において40,000件超のPRと7,500件超のリポジトリに対し、79,000件超のレビューを処理しています[10]。この運用におけるタスク完了率は99.1%と報告されています[10]。
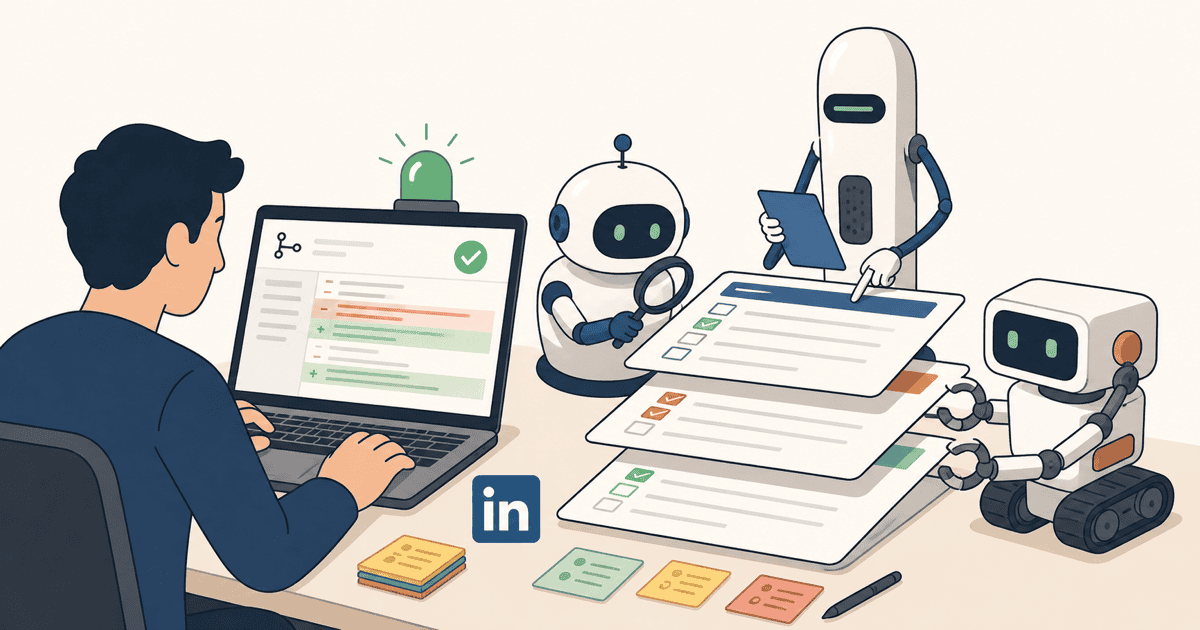
本基盤の中核は、異なるモデルとハーネス(実行環境)を組み合わせた複数のサブエージェントを並列実行するオーケストレーターです[5]。各サブエージェントは他の出力を参照せずにPR差分を検査し、オーケストレーターが重複排除や相互検証、ルール適用を行って最終的なコメントを投稿します[6]。
また、多くのレビューは最初の人間レビュアーがPRを開く前に投稿されていると説明されています[4]。
後輩週7.9万件のレビューって、かなりの規模ですね。単一のAIモデルで全部見ているわけではないんですか?
先輩複数のモデルと実行環境を組み合わせたサブエージェントを並列で動かして、オーケストレーターが集約する構成をとっているよ。
後輩人間がレビューを開く前に一次チェックが終わるスピード感なんですね。
先輩そうだね。早い段階で機械的な確認を済ませる狙いがあるよ。
なぜ今必要なのか:AIコーディング普及による「レビュー待ち行列」の破綻
AIコーディングエージェントの普及によって、開発者1人あたりが投入するコード量が急増しました[16]。GitHubでは、Copilot coding agentの公開後5か月以内に100万件超のPRがマージされたと報告されています[17]。また、Copilot code reviewは6,000万件超のレビューを処理し、1年足らずで10倍に拡大しました[18]。
開発者は短時間で複数のエージェントセッションを起動できるようになりました[19]。一方で、人間のレビュー処理能力は急には増えません[19]。その結果、従来のレビュー依頼から承認までの待ちループが破綻しやすくなっています[19]。LinkedInでも2025年第4四半期に、最初の人間レビューまでのP90時間(上位90パーセンタイル値)が上昇する現象が起きました[16]。
さらに、AIが機能全体を一度に実装して巨大なPRを作成すると、レビュアーの文脈把握が難しくなります[20]。フィードバック品質が落ちてPRが放置され、十分な確認がされないままマージされる懸念も生じます[20]。
加えて、MSR ’26掲載の研究では、AIエージェントが作成したPRの平均最大冗長性が人間PRの約1.87倍に達したと示されています[21]。表面的には整って見えても、不要な重複や技術的負債が蓄積するリスクが存在します[21]。また、CIテストの失敗を隠すためにテストを削除したり、lintスキップを差し込んだりする不適切なコード変更への警戒も求められています[42]。
後輩AIでコードを生成する速度だけが上がって、レビュー側がボトルネックになっていたんですね。
先輩コードの到着量に対して人間の処理能力が変わらないから、待ち行列が伸びてしまうんだ。
後輩巨大なPRや冗長なコードが増えると、人間のレビュアーも確認しきれなくなりますね。
先輩だからこそ、レビューの一次受けを自動化して負担を軽減する仕組みが必要になっているよ。
単一モデルの限界をどう超えたか:独立並列検証と3層ルール合成の仕組み
従来の単一モデルによるレビューには構造的な弱点がありました。モデル固有の学習バイアスにより、同じ種類の見落としが繰り返されたり、低シグナル(重要度の低い)指摘が過剰に出たりする点です[43]。また、1つのルールファイルだけでは、全社方針とリポジトリ固有の規則を両立させることが困難でした[44]。
LinkedInの基盤は、異なるモデルとハーネスを持つサブエージェントをPRごとに並列実行します[22]。各エージェントは他者の出力を参照せず、PR全差分をコードベースや最近の変更履歴の文脈で独立して検査します[23, 24]。先行エージェントの結論に引きずられるアンカリングを防ぐ設計です[23]。
オーケストレーターは、複数モデルが独立して同じ問題を指摘した場合に、それを高信頼度のシグナルとして扱います[25]。単独の指摘についても自動で破棄せず、妥当性を検証した上で重要度を評価します[25]。既存パターンに反する指摘や化粧的な指摘、後続コミットで既に対応された内容は投稿前に抑止されます[28]。
ルール設定には「3層カスタマイズフレームワーク」を採用しています[7]。組織共通ポリシー、リポジトリ固有のアーキテクチャ規則、PRごとの用途やリスク別ガイダンスを合成する仕組みです[26]。例えば、決済サービスのようなセキュリティ重要領域とフロントエンドの実験的機能とで、異なるレビュー基準を適用できます[27]。
後輩エージェント同士が相談するのではなく、お互いの答えを見ずに独立して検査するんですね。
先輩そうすることで、特定のモデルの思い込みに引きずられず、複数の指摘が一致したときに強い根拠として扱えるんだ。
後輩ルールもリポジトリやPRのリスク度合いに応じて切り替えられるなら、無駄な指摘も減りそうです。
先輩全社共通の規約と個別リポジトリの要件を両立させる工夫だね。
開発ツールから本番インフラへ:SLA・品質評価ゲート・運用監視の体制
LinkedInはAIコードレビューを単なる開発支援ツールではなく、PR処理のクリティカルパスに位置する本番インフラとして運用しています[30]。
実行基盤はGitHub Webhook、永続イベントキュー、水平スケールするKubernetesワーカープールで構成されます[8]。各ワーカーホストは最大12件のPRを同時処理します[8]。SLA(サービス水準合意)としては、PRイベントを5秒未満でキューに格納し、約90秒以内にレビューを開始、大半を10分未満で完了する目標を定めています[11]。
品質管理においては、モデルやプロンプト、ハーネスの変更を出荷する前に、本番版との盲検・多ラウンドのペア比較評価を実施します[15, 41]。提示順によるバイアスを排除した上で、総合的に本番版と同等以上と判定された変更のみを本番環境へ適用します[41]。
運用体制には、ページング対応のオンコール、遅延や提案受入率のエンドツーエンド監視、段階的ロールアウト、外部プロバイダー障害時の縮退運転が含まれます[9]。
後輩プロンプトやモデルを変えるときも、本番環境と盲検比較してテストしているんですか?
先輩評価器を使って客観的に比較し、現行バージョンと同等以上の結果が出ないと出荷できない仕組みになっているよ。
後輩オンコールや縮退運転まで備えているのは、まさに本番インフラの扱いですね。
先輩PRの進行を止めないために、基盤自体の可用性と速度基準を厳格に管理しているんだ。
誰に何が影響するのか:開発者・レビュアー・運用者の新たな役割分担
本基盤の導入に伴い、エンジニアリング組織内の各役割における責務の比重が変化しています。LinkedInの全PRにおいて、最終的な変更の承認権限は人間に残されています[14]。AIレビューは人間の代替ではなく、支援と加速を目的としています[31]。
開発者は、PRを作成した後にまずAIの一次指摘を確認し、修正を反映してから人間のレビュアーに依頼する動きが定着しつつあります[32]。
人間レビュアーの役割は、構文ミスなどの機械的な欠陥探索から、設計意図や事業の優先順位、リスクトレードオフといった文脈判断へシフトします[33]。差分からは見えない暗黙知やアーキテクチャの妥当性を評価する最終責任者としての役割です[29]。
シニアエンジニアやアーキテクトは、個別PRの反復レビューから、全社やリポジトリのルール設計、実行可能なプレイブックの整備へと専門知を投入する形に移行します[45]。また、SREやプラットフォーム担当者は、モデルやプロバイダーの障害対応、SLO管理など、LLMを組み込んだ本番サービスの信頼性維持を担います[34]。
後輩人間のレビュアーの仕事がなくなるわけではないんですね。
先輩最終的な承認権限は人間にあるよ。一次的なチェックをAIが済ませることで、人間は設計意図や事業判断に集中できるようになるんだ。
後輩先にAIの指摘を直してからレビューを頼めるなら、お互いのやり取りもスムーズになりますね。
先輩レビュー依頼前の手戻りを減らす効果が期待されているよ。
導入効果と残された課題:提案受入率63.9%の解釈と運用の限界点
LinkedInが実施したマージ後評価(7日間・1,727件のPR・5,230件のコメント)では、AIによる提案の総合受入率は63.9%でした[12, 13]。カテゴリ別では、並行性バグが100%、ロジックエラーが80%、バグ修正が58.1%、リファクタリングが43.5%、セキュリティが40.6%となっています[13]。
| 指摘カテゴリ | 提案受入率 |
|---|---|
| 並行性バグ | 100% |
| ロジックエラー | 80.0% |
| バグ修正 | 58.1% |
| リファクタリング | 43.5% |
| セキュリティ | 40.6% |
| 総合受入率 | 63.9% |
受入率はAIの正確性を直接示す絶対指標ではなく、開発者が有用と判断して採用した割合を示します[38]。非採用の提案がすべてAIの誤りとは限らず、文脈依存の判断や主観が影響します[29, 38]。
一方で、マルチエージェント構成には固有のコストと課題が存在します。サブエージェントを追加するごとに計算量やトークン消費、レイテンシーが増加します[35]。また、複数モデルが誤った結論で一致するケースや、回答レベルで合意していても推論が整合していない現象も学術研究で報告されています[36, 37]。
さらに、PR本文やリポジトリ内ルールなどの未信頼コンテンツを扱う際の間接プロンプトインジェクション対策や、機密コードの送信制御といったセキュリティ統制も重要な論点です[39, 40]。大規模なAIコードレビュー基盤の実用化には、モデルの並列化だけでなく、厳格な運用ゲートと人間の最終判断を組み合わせた統制体制が不可欠です。