何が起きたのか:GitHub Issue「85%削減」の実態と背景
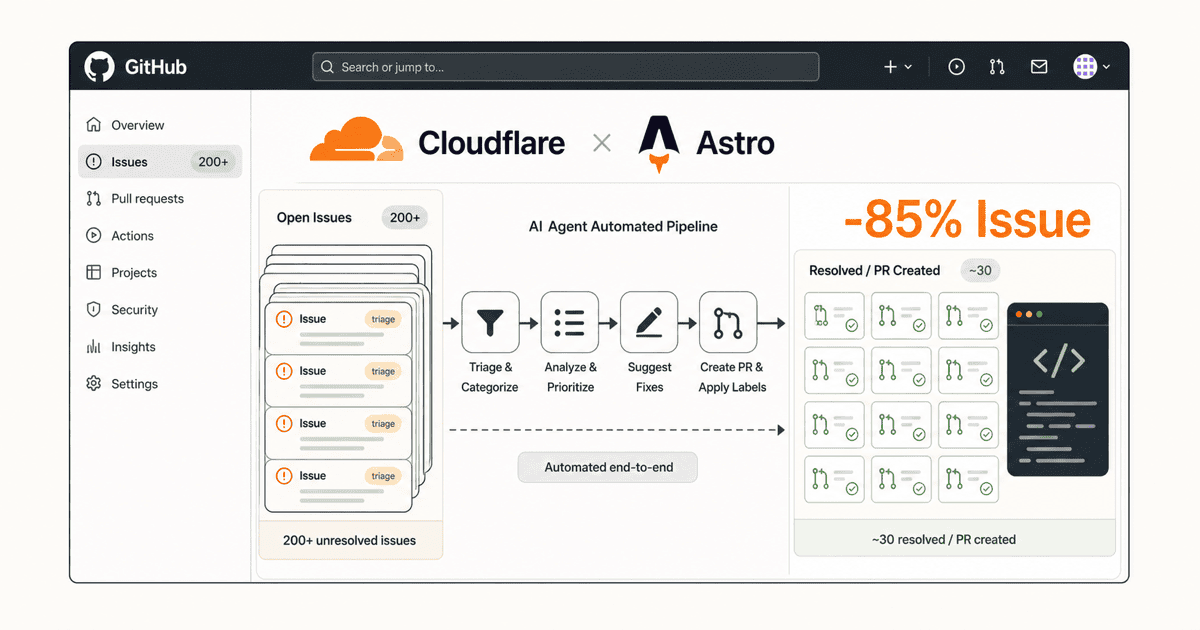
米Cloudflareはオープンソースフレームワーク「Astro」の開発リポジトリにおいて、未解決のGitHub Issue件数を200件超から約30件へと減らし、約85%の削減を報告しました[4, 17]。対象期間は2026年初めから2026年8月4日の公式発表時点までの数か月間とみられますが、厳密な開始日や終了日は公表されていません[1]。
注意が必要なのは、この「85%削減」という数字の解釈です。これは特定の母集団における厳密なバグ解決率や処理速度を示したものではなく、期間中のオープンIssue残数を比較した概算値とみられています[3, 5, 18, 33, 46]。また、Issueラベルや種別による分母や分子の詳細な抽出条件も開示されていません[3]。そのため、この数値はオープンIssue残数のスナップショット比較として捉えるのが正確です[5]。
後輩85%削減って、リポジトリに届いたバグが85%の確率で直ったという意味ではないんですか?
先輩そうだね。あくまでオープン状態のIssue残数が200件超から約30件に減ったという比較で、厳密な解決率ではないんだ。
後輩なるほど。残数のスナップショットとしての数字なんですね。
先輩うん。だから数字のインパクトだけで判断せず、どういう前提の数値なのかを把握しておくことが大切だよ。
なぜ今実現できたのか:4段階のサブエージェント分離と誤診防止設計
今回導入されたAIワークフローは、主にバグや不具合報告を対象としています。処理は「再現」「原因診断」「意図された挙動かの検証」「修正」という4つの独立した段階に分割されています[2, 23, 34]。大規模言語モデル(LLM)がバグのない問題に無理やり解決策を適用しようとする偏りを防ぐため、各段階は隔離されたサブエージェントが担当し、発見事項を共有コンテキストではなく「report.md」ファイルを介して順次引き渡します[9, 23, 35]。
不具合の誤診や不適切な修正を防ぐための安全設計も組み込まれています。Astroのリポジトリに定義されたスキルでは、再現ができなかった場合や環境制約がある場合は後段の処理をスキップします[10, 35]。診断の確信度(confidence)が低い場合や、調査結果が「意図された挙動(intended-behavior)」と判定された場合も修正は試みません[10, 11, 26, 35]。確度が低い段階での推測によるコード変更は行わず、失敗テストや手掛かりを残す仕様になっています[11, 26, 38]。
修正が実行される場合でも、修正後のビルド、再現確認、単体テストの作成、回帰確認が必須要件となっています[12, 26, 38]。例えばホットモジュールリプレイスメント(HMR)の処理において、エージェントが特定の条件分岐を繰り返し変更し、対象バグは修正したもののテスト不足により別の回帰を引き起こした事例がありました[12, 48]。この際はコードベース側にロジックを説明するコメントを追加することで、エージェントの誤った変更を防ぐよう改善されたと報告されています[12, 48]。開発チームはエージェントの失敗を、テスト不足やドキュメント不足を検知してコードベースを改善するシグナルとして活用しています[12, 39]。
後輩エージェントが勝手に推測してコードを書き換えてしまう心配はないんですか?
先輩再現できない場合や診断の確信度が低い場合は、推測での修正を行わずに処理を打ち切る設計になっているよ。
後輩テストや回帰の確認まで必須になっているんですね。
先輩そうだね。さらにサブエージェント同士を隔離してreport.mdで結果を渡すことで、思い込みによる誤診も防いでいるんだ。
何が変わるのか:従来のラベルBotや外部委託との決定的な違い
従来のGitHub Issueフォームは、入力項目やバリデーション、初期ラベルを定義してIssue本文を整形する仕組みです[19]。また、代表的な自動化であるルールベースの仕組みや「actions/stale」などは、無活動期間に応じたラベル付けやクローズといった状態管理を担当します[20, 21]。これらは受付や分類の自動化には役立ちますが、コードを実行して不具合を再現したり、原因を調査してコード修正を行ったりする工程はカバーしていません[21, 22]。
これに対し、Cloudflareが活用するAIエージェント方式は、単なるバグかどうかの判定にとどまりません。再現情報不足、CI環境の制約、再現不能、修正不能、修正待ちといった多様な中間状態を扱います[24, 47]。さらに修正候補をブランチへプッシュし、プレビューリリースを発行して報告者に確認を求めるなど、従来のテンプレートやラベルBotよりも広い実行能力を持ちます[25, 36]。
一般的な外部委託によるトリアージでは、人間のエンジニアがL1の受付からL2の調査、L3の修正までを担当し、サービス水準合意(SLA)や契約形態に基づいて運用されます[30]。AIエージェント方式は、これらの受付から再現・診断・修正・報告者確認までの工程を非同期のワークフローとして自動実行し、保守担当者が手作業でバックログを管理する負担を軽減する点に特徴があります[32, 45]。ただし、導入にあたってはモデル推論費用やCI実行枠、プロジェクト固有スキルの開発・保守といったコストが発生します[31]。
後輩これまでのラベル付けBotとは何が根本的に違うんでしょうか?
先輩ラベル付けなどの状態管理だけでなく、実際にサンドボックスでコードを動かして再現や修正、プレビューの作成まで進められる点だね。
後輩トリアージの受付だけでなく、修正候補の検証まで一連の流れで動くんですね。
先輩その通り。保守担当者が手作業でIssueを管理する負担を減らすアプローチなんだ。
誰に影響するのか:報告者・メンテナー・コントリビューターの新たな役割分担
この自動化システムにおいて、人間の関与は重要な検証ゲートとして位置づけられています。AIが修正候補を作成してプレビューリリースを発行すると、Issueの報告者は自身のプロジェクトで修正パッチを試すよう求められます[6, 25, 36]。報告者が動作を確認したコメントを投稿すると、システムがそれを検知して初めて正式なPull Request(PR)を作成します[6, 7, 25, 36]。
コメントの判定では、検証モデルが内容を確認・拒否・判定不能に分類します[7]。拒否された場合は却下状態(fix rejected)に移り、判定不能な場合は処理を行わず、確認された場合のみPR作成へ進みます[7]。プレビュー確認を省略して自動でPRを作成する設定(auto-pr-on-fix)も存在しますが、標準設定では確認を優先するフローが有効になっています[16, 37]。ただし、公開情報で確認できるゲートはPR作成までであり、PR作成後のレビューやマージがどのように運用されているかまでは明らかにされていません[8, 27, 42, 50]。また、報告者が無応答の場合の期限規定は公開仕様に示されていません[49]。
メンテナーの働き方にも変化が生まれています。Cloudflareの報告によると、メンテナーが日常的なIssue処理に費やす時間が減ったことで、Discordでのコミュニティ対応や仕様策定(RFC)、コントリビューターとの協働作業により多くの時間を充てられるようになりました[40]。また、コントリビューターに関しても、個別のバグ修正だけでなく、リポジトリ固有のスキル定義やテスト、ドキュメントを整備することでエージェントの精度向上に寄与する道が生まれています[41, 55]。
後輩報告者が自分の環境でプレビューを試して、動くかどうか返事をするんですね。
先輩そう。報告者が確認のコメントをして初めて自動でPRが作成される仕組みになっているよ。
後輩メンテナーはその分、コミュニティ対応や設計の議論に集中できるわけですね。
先輩公開資料によると、日常的なバックログ対応の時間を減らして協働に注力できるようになったと報告されているね。
導入と運用の現実解:有限制御・コスト・セキュリティの境界線
自律型エージェントを安全に運用するため、パイプラインには多層的な停止制御が組み込まれています。Bot自身のコメントによる自己誘発ループを防ぐため、ルーターはBotの発言を無視します[13, 29, 43]。また、修正確認済みや対応不要などの終端ラベルが付与されたIssueでは処理を終了します[13, 29, 43]。トリアージ失敗時の自動再試行は最大3回に制限されており、これを超えた場合はメンテナーが手動で解除するまで再試行されません[14, 28, 43]。さらに、ワークフローはIssueごとに同時実行を1件に制限し、ジョブ実行時間の上限を60分に設定しています[15, 28, 44]。
一方で、導入や運用における課題や留意点も存在します。Issue本文やコメントは第三者が自由に入力できるため、GitHub Actionsランナー上でシェルコマンドを実行し、リポジトリの書き込みトークンを扱う構造上、プロンプトインジェクションへの警戒が議論されています[51]。また、公式のセットアップ例ではアクションの参照にタグが使われていますが、GitHubのセキュリティガイドラインではコミットSHAへの固定が推奨されています[52]。なお、Astroの脆弱性報告は専用窓口(security@astro.build)へ非公開で送る規定となっており、今回のIssue削減の成果に脆弱性対応は含まれていません[57]。
運用コスト面では、モデル推論費やCI利用枠の考慮が必要です。公開アクションのデフォルト設定ではトリアージにClaude Opus 4.6、検証にClaude Sonnet 4.6が指定されています[53]。Anthropicの現行価格はOpus 4.6が入力1MTokあたり5ドル・出力25ドル、Sonnet 4.6が入力3ドル・出力15ドルです[53]。Workers AIを利用する場合は1日1万Neuronsの無料枠があり、超過分は1,000Neuronsあたり0.011ドルが課金されます[54]。GitHub Actionsも非公開リポジトリでは無料枠超過分が課金対象となります[54]。
他プロジェクトへの適用においては、単にActionを導入するだけでなく、プロジェクト固有のスキル定義(SKILL.md、reproduce.md、diagnose.md、verify.md、fix.mdなど)やテスト環境、ドキュメントの整備が必要とされています[55, 56]。


