なぜ今か:コーディングエージェントの台頭と検索ツールの再評価
ソフトウェア開発の主役は、人間のエディタ操作からAIエージェントの自律ループへと移行しつつあります。コーディングエージェントは、コードの検索、ファイルの読み取り、編集、テスト実行という一連の工程を反復して処理を進めます [19]。この自律的な反復作業において、コードベース内から必要な情報を探し出す検索ツールは、エージェントの実行能力を直接左右する基幹機能となりました [19]。
従来の開発環境では、言語サーバープロトコル(LSP:エディタと言語ツールの間でコード補完や定義ジャンプなどの意味解析機能を通信するための共通規格)が重要な役割を担ってきました。しかしLSPは、もともと人間のエディタ操作を支援するために設計されたものであり、エージェントの文脈取得に特化したAPIではありません [20]。実際にOpenAI Codex CLIなどの最新実装では、システムプロンプトやパッケージ構成において、テキスト検索ツールであるGrep(特に高速なripgrep)を優先して使用する指示が明示的に組み込まれています [7]。
何が起きたか:実証実験が示すGrep優先の実態とタスク依存性
このGrep優先の傾向は、単なる実装の偶然ではありません。モデルやプロンプト、実行ループを同一に揃えて検索ツールのみを変更した公開対照実験により、再現性のある挙動として確認されています [1]。シンボル名を手がかりに対象ファイルを特定する位置特定(localization)タスクでは、モデルにツールの自由選択を認めた場合、意味解析ツール(semantic tool)の選択率はOpus 4.8で0%、Sonnet 4.6で4%、Haiku 4.5で6%と極めて低い水準にとどまりました [2]。さらにOpus 4.8に対してLSPの優先利用を強制したところ、タスクの成功率は100%から89%へと低下しました [2]。
一方で、対象シンボルのすべての呼び出し箇所を洗い出す参照列挙(reference-completeness)タスクでは、エージェントの選択行動に変化が見られました。同モデル群の意味解析ツール選択率は45%から57%へと上昇し、タスクの目的に応じて道具を使い分ける傾向が示されています [3]。この参照列挙タスクにおいて、LSPは適合率(precision:報告した箇所が実際に正解である割合)で1.00を記録し、Grepの0.76を大きく上回りました [3, 16]。しかし再現率(recall:正解参照箇所の網羅率)は両者とも約0.66と同等であり、Opus 4.8ではLSP利用時のトークン(AIが文章を処理する基本単位)消費量がGrep単体と比べて19%増加しました [3, 16]。
| タスク種別 | モデル / ツール | 意味解析ツールの選択率 | 適合率 (Precision) | 再現率 (Recall) | トークン消費増減率 (対Grep比) |
|---|---|---|---|---|---|
| 位置特定 (localization) | Opus 4.8 | 0% | - | - | - |
| 位置特定 (localization) | Sonnet 4.6 | 4% | - | - | - |
| 位置特定 (localization) | Haiku 4.5 | 6% | - | - | - |
| 参照列挙 (reference-completeness) | Opus 4.8 | 45% | LSP: 1.00 / Grep: 0.76 | LSP: 0.66 / Grep: 0.66 | +19% |
| 参照列挙 (reference-completeness) | Sonnet 4.6 | 50% | - | - | - |
| 参照列挙 (reference-completeness) | Haiku 4.5 | 57% | - | - | - |
なぜ差が出るのか:言語の壁ではなく「語彙的ノイズ」が決める有効性
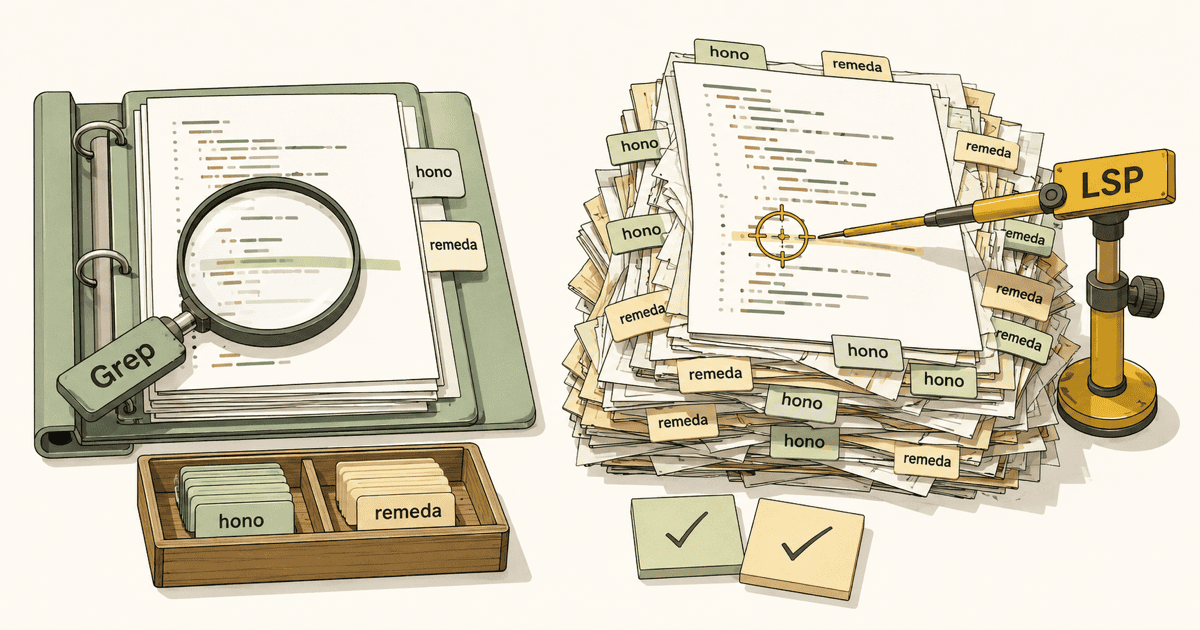
LSPが有効に機能するかどうかを分ける要因は、プログラミング言語の静的型付けの有無ではありませんでした。実験結果の分析によると、結果を左右したのはコードベース内に存在する同名語などの「語彙的ノイズ」の量でした [4]。
同じTypeScriptで書かれたリポジトリを比較した場合でも、その効果は対照的です。語彙的ノイズが少ない整ったコードベース(remeda)では、LSPとGrepのF1スコア(適合率と再現率の調和平均)の差は0.000にとどまり、LSP側でトークン消費量が16%増加しました [4, 17]。これに対して、同名シンボルが多く語彙的ノイズが激しいコードベース(hono)では、LSPの活用によってF1スコアが0.245(または0.246)改善し、トークン消費量も12%削減されました [4, 17]。ノイズの少ない環境では単純な文字列一致で十分な成果が得られる一方、衝突の多い環境において初めてLSPによる正確な意味解析がコスト削減と精度向上に寄与します。
何が変わるか:意味の正確さから「文脈返却インターフェース」の勝負へ
エージェントにとっての検索性能は、検索エンジンの純粋な精度だけで決まるものではありません。ツールの出力形式や返却される文脈の量、それに伴う追加のファイル読み取り回数といった「インターフェース設計」が、実行効率に大きな影響を与えます [8, 11, 21]。
同一のLSPバックエンドを用いた実験では、参照の該当ファイルと位置情報のみを返す従来の実装から、該当するソース行のテキストをインラインで同時に返す形式へ改変しました。この変更だけで、複数ファイルにまたがる名前変更タスクの1発成功率(pass@1)は0.67から0.83へと大幅に上昇しました [5, 18]。さらに、エージェントがコードを確認するために行う後続のファイル読み取り回数は、1エピソードあたり15.2回から3.2回へと約5分の1に激減しました [5, 18]。Grepが本来備えている「一致行を即座にまとめて提示する」という行指向の出力形式が、エージェントの認知負荷を減らす上で実利的な強みを発揮しています。
後輩エージェントがGrepを多用するのは、単に高度な意味解析を扱いきれないからではないんですか?
先輩能力の限界というより、返ってくる情報の形が行動に合っているかどうかの問題だね。
後輩位置情報だけ渡されると、確認のためにファイル全体を何度も読み直す手間が発生するわけですね。
先輩そうなんだよ。最初から該当行のコードが見えていれば、余計なファイル読み取りを挟まずに次の判断へ進めるんだ。
後輩そう考えると、ツールの賢さだけでなく、エージェントが次に何をしたいかに合わせたデータ設計が問われているんですね。
先輩まさにそこだね。ツールの使い勝手は、AIエージェントにとっても処理効率を分ける重要な境界線だよ。
運用コストの現実:起動・環境依存・復旧における運用の摩擦
開発基盤としての運用コストの面でも、両者には明確な隔たりが存在します。Grep系のツールは、プロジェクト固有の意味解析用インデックスや常駐サーバーを必要とせず、ファイルを直接走査して即時にテキスト行を返せます [12]。そのため、利用開始にかかる事前の摩擦が極めて少なく済みます。
一方でLSPの導入には、対象言語ごとのプラグインや言語サーバーの実行バイナリの配備が必須となります。場合によってはビルド設定やコンパイル設定ファイル(compile_commands.jsonなど)の準備も求められます [13]。たとえばClaude Codeの環境では、Grepがripgrepベースの常設機能として即座に使えるのに対し、LSPはクラウド実行セッションにおいて言語サーバーが起動されず非アクティブになります [6, 22]。またLSPでは、インデックス作成中に解析サーバーがクラッシュした場合、プロセスの再起動やインデックスの無効化といった手動の復旧対応を迫られる運用上の課題も報告されています [14]。
誰に影響するか:エージェント開発者とツール基盤設計者がとるべき適応戦略
これらの実証結果は、GrepがLSPに対してあらゆる面で常に優れていることを意味するわけではありません [10]。実際にGitHub Copilotを統合したVS Code公式の実装では、意味検索、Grep、使用箇所検索、ファイル検索をタスクやインデックスの状態に応じて自動的に組み合わせる設計が採用されています [9]。
エージェント開発者やツール基盤の設計者には、状況に応じた使い分けが求められます。シンボル名の探索や語彙的ノイズの少ないコードベースでは、起動摩擦の少ないGrepを初手として活用する方針が合理的です。一方で、同名語の衝突が激しい参照解決タスクでは、ソース行をインラインで返すよう調整されたウォーム済みのLSPへ切り替える設計が適しています [23, 25]。さらに、コメントや設定ファイル、文字列リテラルまで横断して修正する必要がある編集作業では、構文解析に依存しないGrepの網羅性が強みとなるため、双方の特性を活かしたハイブリッドなルーティング設計が今後の標準となります [15, 24]。


