単一構成での負荷集中
セルフホストの通常モードでは、本番実行の並列数に既定上限がありません。同時実行が増えるとNode.jsのイベントループが圧迫され、性能低下や応答不能につながることがあります[1]。
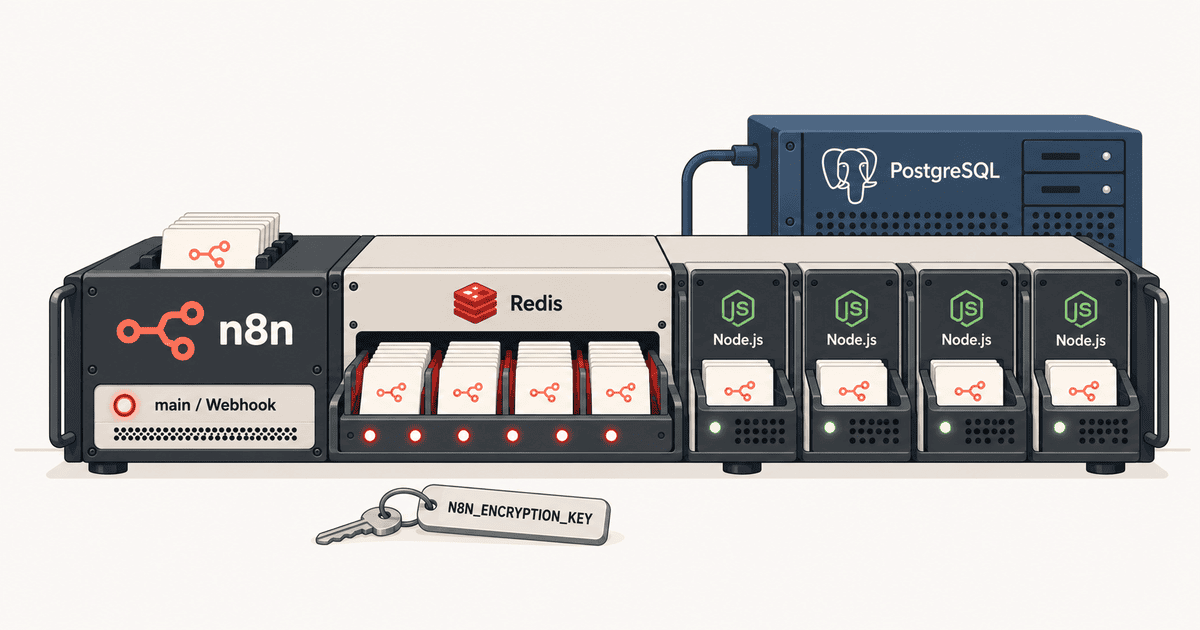
キューモードではmainやWebhookプロセッサーが受付を担い、workerが実行します。処理を分離する分、受け渡しの負荷や遅延も加わります[2]。
補足:Webhookとは
WebhookはHTTPを使って外部からイベントを通知する仕組みです。
導入を検討するなら、単一構成で負荷を扱えるかを確かめ、分離による効果と遅延を実測します。
導入時の条件と負担
運用ではRedis・DBの接続と保存先、暗号鍵の共有を管理します[4]。本番Webhookを専用プロセッサーへ振り分けるなら、ロードバランサーの経路も設計します。重い受付処理をmainにも流すと、編集・閲覧用UIへ負荷が及ぶことがあります[3]。
Community editionでもキューモードを利用できます。workerを増やすことと、main自体を複数にするmulti-mainは別です。multi-mainはセルフホストのEnterprise向け機能です[16]。セルフホストで画像や文書などのバイナリデータをS3へ保存するには、BusinessまたはEnterpriseと有効なライセンスが必要です[17]。
キューモードではDBへバイナリを保存する構成も選べます。
実行経路と保存先
実行データをDBに保存する構成では、mainがタイマーやWebhookから実行を生成し、そのIDをRedisのキューへ渡します。workerはIDを使ってDBから実行情報を読み、結果をDBへ保存します。ワークフロー定義・認証情報はDBに、待機ジョブとプロセス間の通知はRedisに置きます[5, 7]。
Webhookプロセッサーの増設とworkerの増設は別です[6]。手動実行をworkerへ渡す設定は既定で無効です。本番実行と手動実行の処理先は分けて確認します。
図はキューモードの実行経路を基にしています。Webhookの応答を実行完了まで待ち、実行データをDBに保存する場合の概略です。外部保存を選ぶ構成では、データ本体の保存先も別に照合します。
| 対象 | 保存先・役割 | 移行時の確認対象 |
|---|---|---|
| ワークフローと実行データ | Fairwinds事例ではPostgreSQL | 保存対象のデータと接続先 |
| 待機ジョブ | Redis | キューと接続設定 |
| 画像・文書などのバイナリ | 利用する保存モードによる | 過去ファイルも読める保存先 |
| 保存済み認証情報を使う鍵 | 各プロセスへ同じ既存鍵を配布 | DBと併せて保持する鍵 |
認証情報は暗号化してDBに保存され、自動生成した鍵は通常~/.n8nにあります[9]。移行時には既存のN8N_ENCRYPTION_KEYを保持し、main・worker・Webhookプロセッサーへ同じ鍵を設定します。既存の認証情報の復号には元の鍵が必要です。DBと別に鍵の復元方法を確認し、復元できなければ認証情報の再登録も検討します。
公式の復号実装もその環境の暗号鍵を使っています。同じ認証情報を使えるかまで検証します。公開サンプルの新規鍵生成例は新規構築向けで、既存環境の鍵を置き換える手順ではありません。
キューモードはfilesystemモードのバイナリ保存に非対応です[8]。v2.0の変更点では、キューモードのバイナリ保存の既定はdatabaseとされています。S3へ切り替える場合は、既存ファイルの保持方法と移動方法を分けて計画し、過去のデータも読み取れるか検証します。
Fairwindsの移行事例
2026年10月16日、CNCFブログにFairwinds担当者がAmazon EKSでの本番運用・移行事例を寄稿しました。以下は同社の構成での事例です。
補足:Helm・Pod・PVCとは
Helm chartはKubernetesへの配備設定です。Podはコンテナを動かす単位、ノードはPodを動かすホスト、PVCは永続ストレージを要求する仕組みです。StatefulSetはPodごとの識別とストレージを、DeploymentはPodの複製や更新を管理します。
旧community chartはmainをStatefulSetで動かし、PodごとにPVCを持たせていました[10]。比較した公式chartの永続化構成は、mainをDeploymentで動かし、一つのPVCを共有する形でした。EBS gp3を複数ノードへ同時に接続できない点が問題になりました[11]。RWOは単一ノードからの読み書きで、同一ノード上の複数Podによるアクセスは可能です[12]。
公式chartのv1.0.0のvaluesでは、persistence.enabledは既定でfalseです。有効ならmain用PVCを使い、無効なら一時領域を使います。
Fairwindsがvolumeを調べると、ワークフローと実行データはPostgreSQL、待機ジョブはRedis、ファイルはS3にあり、暗号鍵などはSecrets Managerで管理されていました。mainのvolumeに残すデータはないと判断しました。
そこでmainの永続化を無効にし、DB・Redis・S3・IAM・secretsを保持したまま切り替えています[13]。永続化無効時のemptyDirは一時領域として扱い、保持が必要なデータはDBや外部保存先に置きます[14]。
同社の報告では、復元したDBを使って本番から分離した環境でテストし、既知のワークフローの完了、接続先への到達性、切替前の構成へ戻す手順を確認しました。DBのスナップショットと秘密情報のバックアップも保存しています。
n8nのコンテナイメージの版は変えずにchartを切り替えました[18]。chartとアプリの更新を分け、ローカルディスクを外せるかは保存データを調べて判断する事例です。
公開サンプルはchart 1.0.0を固定し、そのtagのChart.yamlの既定appVersionは2.9.0です。この既定値からFairwinds本番のimage版は特定できません。
公式READMEは安定版chart 1.xと、mainで開発する2.0 RCを区別しているため、サンプルの設定へ開発ブランチの値をそのまま混ぜないようにします[15]。
停止と再試行の検討
Fairwindsの報告はWebhookの受付停止から待機ジョブの処理、各Podの停止までの順序を示していません[19]。以下は各構成で検証する運用案です。
- Webhookとタイマーなど、新しい実行を始める経路の停止・切替方法を決めます。
- DB・Redis・ファイル・既存鍵を保持し、受付済み要求、待機ジョブ、実行中の処理を分けて照合します。Redisは接続先に加え、DB番号と、キューのprefix設定も照合します。
- 実行完了や応答に必要なworker・main・受付プロセスと依存先を残し、猶予内に終わらない処理をどう扱うか決めます。
- 旧プロセスの撤去後も未完了を照合し、外部操作の結果を確認してから再実行の可否を判断します。
N8N_GRACEFUL_SHUTDOWN_TIMEOUTは終了を待つ時間の上限です。Kubernetesの終了猶予にはpreStopの時間も含まれます。猶予内に完了するかと、超えた処理の扱いを検証します。
v2.0の変更点はstalled jobに対するBullの自動再試行を廃止したと記しています。一方、2.43.7のworker終了時の中断・再開機能は既定では無効です。所定の終了手順で中断できる本番実行を、ノードの切れ目で中断し、再開用の待機状態として保存します。長いノード処理が終了猶予を超える場合や、WebhookのHTTP応答を待つ実行などには制約があります。
ノード内で失敗時に再試行する設定Retry On Fail、失敗した実行を手動で再実行する操作、送信元によるWebhook再送も区別します。外部APIで登録が成功し、応答だけ失われた場合を考えます。同じ要求を再送すれば、登録を二重に求める可能性があります。
重複を抑える設計案として、同じ業務操作を識別するIDと処理状態を保持します。呼び出し先APIが冪等性キーに対応する場合、同じ操作には同じキーとパラメータを使って再送します[20]。
この例でも、外部APIの成功後、処理済み記録を保存する前に障害が起きる場合を考えます。AWSの再試行設計の解説は、受信サービス側で重複抑止の記録と変更操作を一体の原子的な操作にする要件を示しています。結果不明なら照合や人の判断が必要です。
Helmのrollbackはリリースを以前のリビジョンへ戻す操作です。外部APIで済んだ登録の取り消しは別に計画します。キュー側の保証については、Spanner queuesの原子性と再配信・ACKも参照できます。