何が起きたか:BigQueryのAI.CHUNK_DOCUMENT関数がGA提供開始
Google Cloudは2026年10月21日、BigQueryのtable-valued関数であるAI.CHUNK_DOCUMENTを一般提供(GA)としました[1]。公式リリースノートの日付に関しては、2026年6月13日のGoogle Security Operations(SecOps)における検出カテゴリ「Non-prioritized IoC Matching rules Category」の追加や[1]、2026年10月23日のGoogle Cloud全体リリースノートにおけるCloud Monitoring Ops Agent 2.73.0の脆弱性修正とは発表日・対象機能ともに異なる別件であり[2]、BigQueryの個別リリースノートにおけるGA告知日は2026年10月21日です[4]。
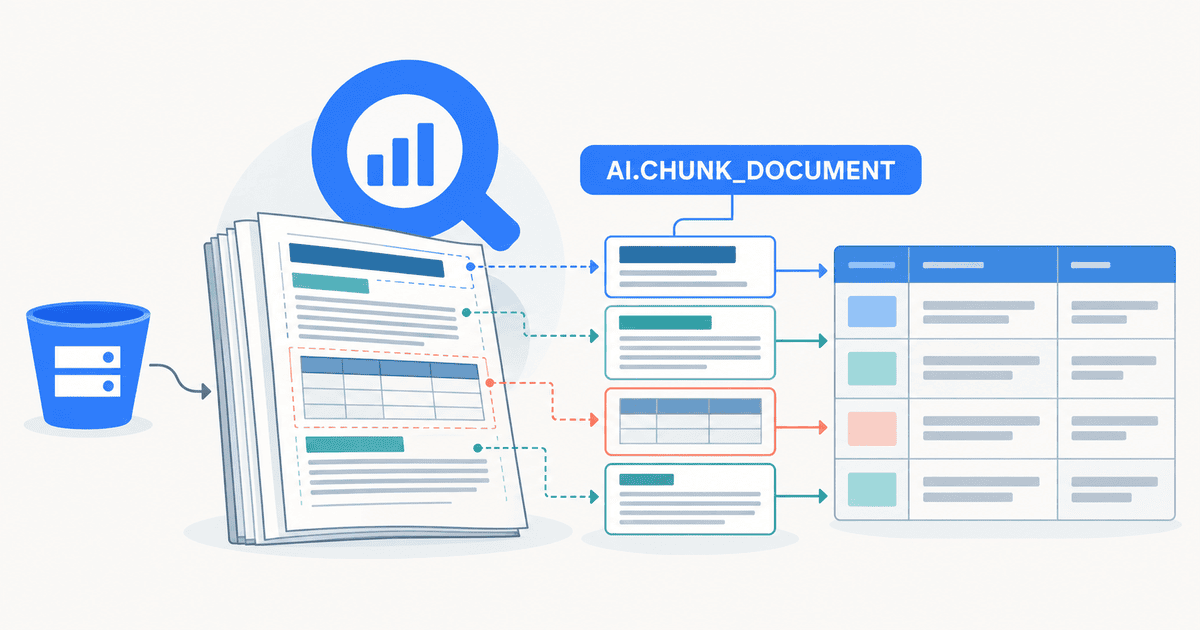
本機能は、Document AIのレイアウト解析(Layout Parser)を利用して非構造化文書を解析し、見出し、節、段落、リスト、表などの構造情報に沿った意味的なテキストチャンクを生成するtable-valued関数です[3]。生成されたチャンクは、ベクトル埋め込みの作成や検索拡張生成(RAG)のワークフローに最適化された形で出力されます[3]。
補足:table-valued関数とは
複数行・複数列で構成されるテーブル形式の結果を返すSQL関数です。FROM句などで通常のテーブルと同様に参照できます。
なぜ今か:非構造データ分析の集約とパイプライン複雑化の解消
企業における非構造化データの活用では、データウェアハウスからのデータ持ち出し、複雑なLLMパイプラインの結合、分散した検索インデックスの管理といった運用課題が指摘されていました[5]。とりわけRAGパイプラインの構築においては、PDFなどの文書ファイルを意味のあるチャンクへ分割する前処理工程で、Pythonのプログラミングスキルや外部ライブラリの導入が求められる場面が多く見られました[6]。
Google Cloudは2024年にも、ML.PROCESS_DOCUMENTとDocument AI Layout Parserを組み合わせてPDFをSQL構文で解析・分割する手順を紹介していました[7]。今回のAI.CHUNK_DOCUMENTのGA提供は、エンドツーエンドの非構造データ分析基盤をBigQuery上に整備し、外部基盤との煩雑なデータ受け渡しを削減して前処理をSQL環境へ集約する狙いがあると読み取れます[5]。
なお、ソースコードの構文解析に基づく分割を扱った既存のコード検索RAGの知見とは異なり、本記事ではPDFや業務文書などの一般文書を対象とした構造解析と、BigQuery SQLによるチャンク生成の導入条件を主題として整理します[8]。
何が変わるか:SQLで完結するRAG前処理と各機能の役割分担
AI.CHUNK_DOCUMENTが果たす役割は、文書のレイアウト構造を解析して意味的なチャンクを出力することです[15]。RAGパイプライン全体を構築する際は、前後の処理を担うBigQueryの各機能と連携させます[15]。
処理の入力元となる元文書はCloud Storageに配置し、Cloud Storage URI、object table、あるいはObjectRef列を返すサブクエリ経由でAI.CHUNK_DOCUMENTに渡します[10]。関数を実行すると、バックエンドでプロジェクトごとに1つ用意されるDocument AI Layout Parserプロセッサが自動管理され、個別のプロセッサ配備を行わずに構造化されたチャンク群がテーブル形式で行として出力されます(Document AI APIの事前有効化が必要です)[9]。
関数が返したチャンク結果を永続的に保持するには、SQL側でCREATE TABLE AS SELECT(CTAS)構文を用いてBigQueryのテーブルへ書き込みます[11]。後続のベクトル化では、AI.EMBED関数を用いてAgent Platformの埋め込みモデルを指定し、テキストチャンクの埋め込み表現を生成します[12]。検索実行時は、入力された質問クエリを同様にAI.EMBEDでベクトル化し、VECTOR_SEARCH関数を用いてテーブル内の類似チャンクを抽出します[13]。最終的な回答生成では、検索されたチャンクをプロンプトのコンテキストに組み込み、AI.GENERATE関数を通じてGemini Enterprise Agent Platformのモデルを呼び出します[14]。
このように、AI.CHUNK_DOCUMENTは文書分割に特化した関数であり、データの永続化、埋め込み、検索、生成はそれぞれ独立したBigQueryの機能が担当する構成となっています[15]。
誰に影響するか:構造化文書を扱う実務者と適用領域
本機能の主な対象は、Cloud Storageに蓄積された業務文書をBigQuery環境で管理し、RAGシステムの構築を進めるデータエンジニアやMLエンジニアです[16]。これまでPDFやOffice文書のチャンク分割処理をPythonスクリプトや外部フレームワークで運用していた現場において、SQLによるシンプルな前処理パイプラインを組む選択肢が生まれます[16]。
適用が適しているのは、見出し階層、表、箇条書きリストなどの文書レイアウト自体が文脈の意味を担っている形式です[18]。GA対応形式であるPDF、HTML、DOCX、PPTX、XLSX、XLSMのうち、仕様書、業務マニュアル、調査レポート、決算説明資料などは構造解析の恩恵を受けやすい文書群といえます[17]。一方で、アクセスログやセンサーデータのように意味的な文書構造を持たないテキストデータでは、固定長分割を採用することも考えられます(固定窓方式では単語や文、段落が途中で分断されるリスクが伴います)[18]。
パイプラインの設計判断としては、GA対応形式を標準的なパラメータで処理する場合はBigQuery内の構造解析を採用し、CSS依存のデザイン再現が不可欠なWebページや、独自の分割境界・オーバーラップ制御を細かく調整したいケースでは外部前処理を残すといった切り分けが妥当と考えられます[19]。
後輩既存のPythonで組んだ前処理スクリプトは、すべてBigQueryのSQLに置き換えるべきなんですか?
先輩文書の種類と要件によるね。見出し階層や表の構造が重要なPDFや業務文書であれば、ウェアハウス内で一貫して処理できる価値は高いよ。ただ、CSSデザインに依存したHTML文書や、細かな重なり幅の制御が必須のシステムなら、外部前処理を維持する構成も合理的だね。
後輩文書の特性や制御要件に応じて使い分ける判断が必要なんですね。
文書分割の仕組み:構造解析チャンキングと固定長方式の差異
AI.CHUNK_DOCUMENTの分割アルゴリズムは、Document AI Layout Parserによるレイアウト構造解析に基づいています[20]。見出し、節、段落、リスト、表などの構造的要素を認識し、構造境界をまたぐ意味的な文脈を保持しながらチャンクを生成します[20, 22]。
特徴的な設計として、祖先見出し(ancestral headings)や表ヘッダーの自動保持が挙げられます[21, 23]。下位の節や表の途中に位置するテキストであっても、その上位にある見出し階層やテーブルの見出し行がチャンク情報に付与されます[21, 23]。これにより、類似度検索によって単一のチャンクのみが抽出された場合でも、LLMが適切な回答を生成するために必要な構造的文脈が保たれます[21]。
関数の挙動を制御する引数として、チャンクの目標最大サイズをトークン単位で指定するchunk_sizeが用意されています[24]。chunk_sizeはINT64型の引数で、設定可能な範囲は1から2000トークン、省略時の既定値は1000トークンです[24, 25, 27]。
従来の固定長分割方式では、文字数やトークン数の上限値とともに、前後のチャンク間で一定量を重複させるオーバーラップ幅(overlap length)を指定して文脈の途切れを緩和する設計が一般的でした[26]。これに対しAI.CHUNK_DOCUMENTでは、レイアウト解析に基づいて文書の自然な区切りを認識するため、機械的な固定長分割とは異なるアプローチをとっています[20, 26]。
利用条件と前提要件:対応形式・提供リージョン・認証権限
AI.CHUNK_DOCUMENTを導入する際には、提供地域、文書形式、API設定、およびIAM権限の前提要件を確認する必要があります。
利用可能なリージョンは、USおよびEUのマルチリージョン、ならびにeurope-west2(ロンドン)とeurope-west6(チューリッヒ)を除くUS・EU内のシングルリージョンに限定されています[28, 37]。外部リソース接続を利用する場合は、接続自体も対象データセットと同一のロケーションに配置する必要があります[34, 37]。
対応する文書形式はDocument AI Layout Parserの仕様に準拠しており、GAとしてサポートされているのはPDF、HTML、DOCX、PPTX、XLSX、XLSMの6種類です(これら以外の形式はPreview扱いとなります)[30, 31, 38]。
関数を実行するプロジェクトでは、Document AI API(documentai.googleapis.com)の事前有効化が必須です[32]。プロセッサが存在しない場合、BigQueryがプロジェクトごとに単一のLayout Parserプロセッサを自動で作成・管理します[32]。
文書の入力方式には、Cloud Storage URIの直接指定(ワイルドカード指定可能)、refという名前のObjectRef列を持つテーブルやobject table、および同列を返すサブクエリが利用できます[29, 36]。認証方式にはエンドユーザー認証(EUC)とCloud Resource connection方式があり、指定方法によって求められる権限が異なります[29, 33, 36]。
| 認証方式 | 適用条件・構成 | 実行ユーザーに必要な権限 | サービスアカウントに必要な権限 |
|---|---|---|---|
| エンドユーザー認証(EUC) | ・Cloud Storage URIの直接指定 ・ connection_id省略時の既定動作 | ・Document AI Editor(初回プロセッサ作成時)または Document AI Viewer(既存利用時) ・Storage Object Viewer または Storage Object User(対象バケット) ・BigQuery Job User(実行プロジェクト) | なし(ユーザー権限で直接実行) |
| Cloud Resource connection | ・object tableの利用 ・ connection_idを明示指定・接続APIの有効化と同一ロケーション配置 | ・BigQuery Connection User(roles/bigquery.connectionUser)・BigQuery Job User(実行プロジェクト) ・BigQuery Data Viewer(参照テーブル) | ・Document AI Editor(初回プロセッサ作成時)または Document AI Viewer(既存利用時) ・Storage Object Viewer(対象バケット) |
Cloud Resource connectionを新規作成する場合は、BigQuery Connection API(bigqueryconnection.googleapis.com)を有効化し、作成者にBigQuery Connection Admin権限を付与した上で、データセットと同一リージョンに接続リソースを作成します[34]。いずれの方式でもBigQuery Job User権限が必要です。BigQueryのテーブルを参照する場合は、BigQuery Data Viewer権限も必要です[35]。
運用上の制約と仕様:サイズ上限・クォータ・エラーハンドリング
本番運用の設計にあたっては、関数の出力仕様、エラー通知の仕組み、基盤となるDocument AIの制限値やAPIクォータを把握しておく必要があります。
AI.CHUNK_DOCUMENTの出力スキーマには、チャンク識別子であるchunk_id(INT64)、開始・終了ページを表すstart_pageおよびend_page(INT64)、テキスト本文のcontent(STRING)、処理結果を示すstatus(STRING)が含まれます[39]。さらに、元文書の識別情報としてuri、content_type、md5_hash(いずれもSTRING)、generation、size(INT64)、updated(TIMESTAMP)、構造メタデータを保持するmetadata(ARRAY<STRUCT<name STRING, value STRING>>)、およびオブジェクト参照であるref(ObjectRef)が出力されます[39]。
処理の成否はstatus列に記録されます[39, 47]。正常に分割された行のstatusは空文字となり、ファイルの破損、読み取り不能、ファイルサイズ超過などによって処理に失敗した場合はエラーコードとエラーメッセージが格納されます[39, 47]。なお、失敗時の自動再試行の有無や、複数ファイルを一括処理した際に一部のファイルが失敗した場合にクエリ全体がエラー終了するのか部分結果が返されるのかについては、公式リファレンス上に明記されていません[48]。
文書形式ごとに検出可能な要素や固有の制限が存在します。PDFでは図・段落・表・タイトル・見出し・ページヘッダー・フッターが検出されますが、複数ページにまたがる表が別々の表として分割される場合があります[40, 41, 42]。HTMLでは段落・表・リスト・タイトル・見出し・ヘッダー・フッターが検出対象となるものの、CSSに依存した視覚的書式を取りこぼすことがあります[40, 41, 42]。DOCXやPPTXでは段落・表・リスト・タイトル・見出しが検出されますが、入れ子構造になった表(ネストされた表)やPPTXの非表示スライドはサポート外です[40, 41, 42]。XLSXおよびXLSMでは整数・浮動小数点数・文字列を含む表が検出されますが、シート内の複数表検出には対応していません[40, 41]。
ファイルサイズとページ数の上限に関しては、公式ドキュメント間で記述に差異が見られます。Document AI共通のLimits資料ではオンライン要求の上限が40 MB・15ページと記載されている一方、Layout Parser専用ガイドではオンライン処理の上限が全形式20 MB・15ページ(PDF)とされています[43]。非同期のバッチ処理上限については、PDF 1件あたり1 GB・500ページと定められています[44]。ただし、AI.CHUNK_DOCUMENTが内部実行でオンライン処理とバッチ処理のどちらを呼び出しているかは公式資料に記載がなく、バッチ処理の上限値(1 GB・500ページ)をそのまま本関数の入力上限として扱えるかは確認できません[45]。
また、Document AIのAPI割当量(Quota)にも留意が必要です。基本リクエストは1ユーザーあたり毎分1,800件に制限されています[46]。オンライン処理リクエストの割当量は、USおよびEUマルチリージョンではプロジェクト・プロセッサ種別ごとに毎分120件、単一リージョンでは毎分6件となっており、同一プロジェクト内のすべてのアプリケーションで共有されます[46]。大規模なバッチ処理を同一プロジェクト内で並行稼働させる際は、クォータ制限による待機の発生に備えた設計が求められます。
後輩数百ページある報告書PDFも、この関数を使えばそのまま一括でチャンク化できるんでしょうか?
先輩そこは仕様の確認が必要だね。Document AI Layout Parserのバッチ処理は最大500ページまで対応しているけれど、AI.CHUNK_DOCUMENTが内部でバッチ処理を使っているのかオンライン処理を使っているのかは公表されていないんだ。
後輩もしオンライン処理の上限である15ページが適用されるなら、大きな文書は事前にページ単位で切り出しておくなどの対策を考えておく必要がありますね。
コスト構造の実際:各工程の課金対象と試算基準
SQLクエリで一連のRAGパイプラインを完結できる構成であっても、課金体系は処理工程ごとに独立しています[49]。各フェーズの課金対象と単価基準を把握した上で、個別に費用試算を行う必要があります。
文書分割フェーズでは、Document AI Layout Parserの処理ページ数に応じた料金が発生します[49]。初回チャンク分割を含むLayout Parserの公開通常料金は、月間の処理量に基づき1,000ページあたり10米ドルです[50]。BigQueryが自動管理するプロセッサに対してアイドル保持料金は発生しません[49]。
クエリ実行自体には、通常のBigQueryコンピュート料金が適用されます[49]。オンデマンド料金体系では処理データ量に基づき1 TiBあたり6.25米ドルが課金され、請求アカウントごとに毎月最初の1 TiBは無料枠が適用されます(Capacity Pricing利用時はスロット使用量に基づきます)[51]。
テキスト埋め込みフェーズにおいて、AI.EMBED関数でAgent Platformのエンドポイントを指定した場合、Gemini Embeddingの入力利用料が別途発生します[52]。公開料金はオンライン要求で1,000 countあたり0.00015米ドル、バッチ要求で1,000 countあたり0.00012米ドルです[52]。一方、BigQuery内蔵モデルを使用する場合はBigQueryスロットが消費され、Agent Platformの利用料金は発生しません[52]。
ベクトル検索フェーズにおけるVECTOR_SEARCH関数の実行費用は、オンデマンド構成であれば基底テーブル、インデックス、および検索クエリのスキャンデータ量に基づいて計算されます(Editions構成では消費スロット量)[53]。Vector Indexは、組織内の割当上限内であれば作成および更新の処理費用はかかりませんが、稼働中インデックスのアクティブストレージ保管料が課金対象となります[53]。
ストレージ保管費用としては、元文書ファイルを保管するCloud Storageの費用(ストレージクラス、保管場所、操作回数、データ取得料、転送量)と、CTAS構文で永続化したチャンクおよび埋め込みテーブルを保管するBigQueryのストレージ費用がそれぞれ個別に計上されます[54]。さらに回答生成まで組み込む場合、AI.GENERATE経由で呼び出すGemini Enterprise Agent Platformモデルの利用料金も別枠で見積もる必要があります[55]。
| 処理工程 | 課金対象サービス | 課金単位・課金基準 | 公開価格・料金の目安 |
|---|---|---|---|
| 文書分割 | Document AI Layout Parser | 処理ページ数(月間合計) ※自動管理プロセッサの保持料なし | 1,000ページあたり10.00 USD |
| クエリ実行 | BigQuery コンピュート | オンデマンド:スキャンデータ量 Capacity:スロット消費時間 | オンデマンド:1 TiBあたり6.25 USD (月間最初の1 TiBは無料枠) |
| ベクトル埋め込み | Agent Platform または BigQuery | Agent Platformモデル:入力カウント数 内蔵モデル:BigQueryスロット | オンライン:1,000 countあたり0.00015 USD バッチ:1,000 countあたり0.00012 USD |
| ベクトル検索 | BigQuery コンピュート / ストレージ | 検索クエリ・インデックスのスキャン量 ※インデックス作成更新処理は上限内無料 | オンデマンド料金(6.25 USD/TiB)等 アクティブインデックスの保管料 |
| 回答生成 | Agent Platform | Geminiモデルへのリクエスト量 | モデルごとの利用料金(従量課金) |
| データ保管 | Cloud Storage / BigQuery | GCS:容量、操作、取得、転送 BigQuery:テーブルアクティブ保存量 | 各サービスの標準ストレージ料金表に準拠 |
検索品質の検証設計:客観的評価の進め方と評価指標の限界
AI.CHUNK_DOCUMENTは文書構造を保持したRAG前処理を目的として設計された機能ですが、本機能を採用したことによる検索精度の向上を事前検証なしに断定することはできません[63]。導入にあたっては、自社の実文書に基づいた客観的な評価環境を設計し、定量的な比較測定を行う必要があります[63]。
客観的評価の第一歩となる正解データ(Golden Dataset)の作成では、実運用で想定される文書群から代表的な質問と正解のペアを固定セットとして用意します[56]。質問のバリエーションとして、言い換え表現、単純質問、複数要素を含む複合質問、誤字や表記揺れを含む質問、さらには文書内に答えが存在しない回答不能ケースを網羅し、各質問に対して根拠となる原文の該当箇所を紐付けておきます[56]。
評価対象となる文書コーパスは、GA対応形式(PDF、HTML、DOCX、PPTX、XLSX、XLSM)ごとに層別化して管理します[57]。特に表構造を含む文書や、ページをまたいで配置された表といった構造解析の難易度が高いケースは独立したカテゴリとして集計し、形式別の得手不得手を把握できるようにします[57]。
ベースラインとの統制比較では、同一の抽出テキストに対して固定長分割や文境界分割などの基準手法を用意し、テスト条件を厳密に揃えます[59]。質問セット、埋め込みモデル、検索アルゴリズム、生成モデル、プロンプトテンプレートを同一に保ち、分割方式のみを変化させて差異を測定します[59]。この際、取得件数(Top-K)を固定する評価だけでなく、生成モデルに渡す総コンテキストのトークン予算を固定した比較(fill-to-budget)も併用します[59]。また、chunk_size引数については既定値の1000トークンだけでなく、設定可能範囲(1〜2000トークン)から複数の代替設定を試行し、生成された実際のチャンク長分布を計測して記録します[58]。
評価指標の測定では、検索性能と生成品質を分離して評価します[60, 61]。
- 検索性能の評価:各質問に対して正解根拠を含むチャンクが上位に取得されたかを検証し、Precision@K、Recall@K、MRR(Mean Reciprocal Rank)を算出します。回答可能な質問と回答不能な質問は分けて集計を行います[60]。
- 生成品質の評価:正解が一意に定まる短答形式ではExact Match(完全一致率)を測定します[61]。それ以外の応答では、正解性(correctness)、回答の網羅性(completeness)、検索文脈への忠実性(groundedness)、質問への関連性(relevancy)を個別に評価します[61]。
自動評価手法を採用する際には、評価指標自体の特性と限界への配慮が不可欠です。学術論文コーパスを用いた先行研究では、特定の設定下においてRAGAsのfaithfulness(忠実性)スコアの信頼性に限界が見られ、回答関連度のスコアが検索コンテキストの妥当性と乖離する事象が報告されています[62]。
したがって、LLM judgeによる自動スコアリングのみに依存して結論を下すことは避け、生成結果のランダム性による揺れを考慮しつつ、一定割合のサンプルに対して人手による確認を実施する必要があります[63]。自社の文書形式や検索要件に応じた厳密な比較評価を経て、本機能の採用是非と最適なパラメータを判断することが重要です[63]。
後輩見出しや表の構造を維持できるなら、従来の固定長分割より検索精度が上がったと判断して良いんでしょうか?
先輩実測していない段階で改善したと決めつけることはできないよ。構造を保持することでコンテキストが豊かになる設計ではあるけれど、自社の文書セットで正解データを作って、同一の検索モデルやプロンプト条件下で数値を比較検証する必要があるね。
後輩LLMによる自動評価スコアだけに頼らず、人手でのサンプリング確認を交えながら、検索指標と生成指標を分けて測定するのが確実なんですね。


