なぜ今か:本番でCPUとメモリーが増加する困りごとと従来の観測限界
Cloudflare Workers(Cloudflareが提供するコード実行サービス)の運用担当者は、本番でCPU時間(CPUがコードを実行した時間)やメモリー使用量の増加を調べることがあります。メモリー指標はV8 isolate(JavaScriptの軽量な実行環境)ごとの使用量です [4]。関数別のCPU消費やメモリー割り当ては、原因を探す手掛かりになります [11]。
既存の観測手段には、実行ごとのInvocation Log(呼び出しログ)があります。Invocation Logには、各呼び出しのCPU timeとWall time(経過時間)が記録されます [1]。RequestやResponseなどの関連メタデータも含まれます [2]。また、集約指標のWorkers metricsでは、実行ごとのCPU timeの履歴分布を確認できます [3]。各呼び出し時点のV8 isolate memory usage(メモリー使用量)の推移も把握できます [4]。
Workersにおける時間指標の違いを把握しておくことも重要です。CPU timeは、CPUがWorkerコードを実行した実時間です [5]。この時間には、fetch(外部データを取得する処理)やデータベースへの問い合わせなどの外部サービスとの入出力(I/O)待ちは含まれません [5]。一方、Wall timeはJavaScriptコンテキストが開いていた経過時間です [5]。この時間には、外部I/Oの待ち時間やwaitUntil(応答後も非同期処理を継続させる仕組み)のハンドラー内の処理時間を含みます [5]。
Wall timeは、クライアントが応答を受け取るまでの時間と一致するとは限りません [6]。レスポンス送信後もwaitUntil内の処理が継続すると、Wall timeは長くなります [6]。反対に、レスポンス転送の完了前にコンテキストが閉じると、Wall timeは短くなります [6]。I/O待ちを含む応答時間を示す指標としてRequest durationがあります [7]。現行のグラフを利用できるのは、Smart Placement(Workerの実行場所を最適化する機能)が有効な場合に限られます [7]。
| 指標 | 測定対象 | I/O待ち(fetchやKV(キー・バリュー型のストア)など)の扱い | 条件・提供状況 |
|---|---|---|---|
| CPU time [5] | CPUがWorkerコードを実行した時間 | 含まれない | - |
| Wall time [5, 6] | JavaScriptコンテキストが開いていた経過時間 | 含まれる(waitUntil内の処理を含む) | - |
| Request duration [7] | データセンター到着から応答配信までの時間 | 含まれる | Smart Placement有効時 |
これらのログや集約指標では、各呼び出しのCPU時間の分布や、その時点のisolateのメモリー使用量を確認できます [3, 4]。Invocation LogではCPU timeを、Workers metricsではメモリー使用量を確認できます。その上で、CPU消費やメモリー割り当てが集中する関数を特定するには本番プロファイル(本番環境で関数のCPU使用状況やメモリー割り当てを記録するデータ)が役立ちます [11]。ローカルのDevTools(開発者ツール)でもCPU profile(関数ごとのCPU使用状況の記録)を取得できますが、本番特有の挙動をローカルで再現しにくい場合があります [8]。本番と同じ種類や量のリクエストトラフィックを再現することが難しいためです [9]。そこで、本番のトラフィックが流れているコードを調べる手段として、本番プロファイルを利用できます [11]。
後輩メトリクスやログを見れば、CPU時間やメモリーの数値は把握できますよね。それだけでは対策できないんですか?
先輩メトリクスでは、Worker単位で実行ごとのCPU時間の分布や、その時点のisolateのメモリー使用量を確認できるよ。関数別のCPU消費や割り当てを調べる手掛かりとして、本番プロファイルも使えるんだ。
後輩ローカルのDevToolsで同じコードを動かしても、本番特有のアクセス状況を再現するのは難しいですよね。
先輩その通りだね。本番のトラフィックが流れている状態で、実行中のコードを直接観察する手段が必要になるよ。
何が起きたか:本番の関数単位でCPUとメモリー割当を可視化するオンデマンド機能が登場
Cloudflareは2026年10月9日、WorkersとDurable Objects(状態を持つオブジェクトを実行する仕組み)向けの新機能を発表しました [10]。本番環境でCPUとメモリーをオンデマンドでプロファイリングする機能です。公式ブログはIntroducing on-demand CPU and memory profiling with flamegraphs for Workers and Durable Objectsです。本機能は、本番コードにおいてCPU消費やメモリー割り当てが集中している関数を特定する手掛かりとなります [11]。
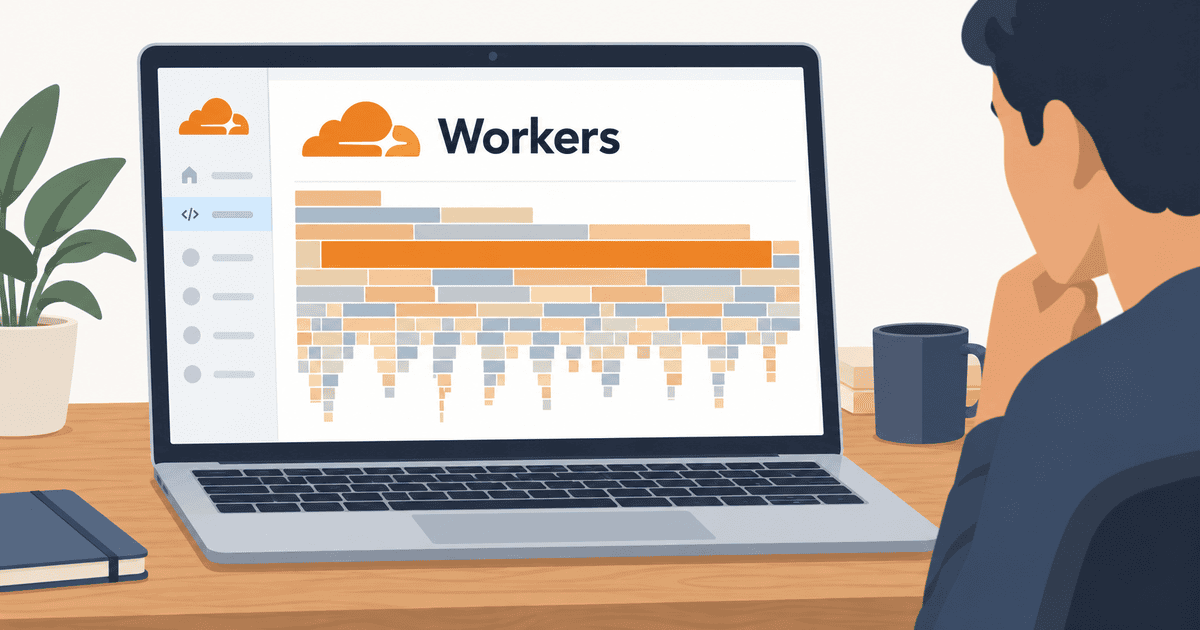
計測はCloudflare Dashboard、cf CLI(コマンドライン操作ツール)、Cloudflare API(プログラムから利用する接続口)から実行できます [12]。公式ドキュメントはProfiling in productionです。開発者はCPU profileまたはHeap profile(メモリー割り当ての記録)を取得できます。採取したデータはDashboard上でflamegraph(関数ごとの負荷を矩形の幅で示すフレームグラフ)として表示できるほか、profileファイルとしてダウンロードすることも可能です [12]。
プロファイルの種類によってサンプリング手法が異なります。CPU profileでは、V8 CPU profilerが1ミリ秒間隔でサンプリング(一定間隔で実行状況の一部を記録する方法)を行います [13]。CPU消費が集中している関数を探す手掛かりになります [13]。一方、Heap profileでは、取得中に、累計512 kBのメモリー割り当てごとにスタックトレース(関数呼び出し履歴)をサンプリング採取します [14]。サンプリング対象となった各割り当てを引き起こした関数呼び出しの連鎖が記録されます [14]。
後輩CPUだけでなくメモリーのプロファイルも取れるんですね。Heap profileはどうやって採取しているんですか?
先輩取得中に、累計512 kBのメモリー割り当てごとに関数の呼び出し経路をサンプリング採取する仕組みだよ。
後輩全オブジェクトを追跡するのではなく、512 kBごとの抽出なんですね。ヒープスナップショットのように生存オブジェクト全体を見るわけではないんですか?
先輩そうだね。採取ウィンドウ中の割り当てを捉えるサンプリングだから、主要な割り当て箇所の傾向を把握する用途に向いているよ。
仕組み:リクエストと並行して採取するロック制御
オンデマンドプロファイリングでは、直近に活動したロード済みのisolateを計測対象とします [15]。計測では、すでに稼働しているisolateを利用します [16]。また、過去ログの時刻範囲を指定して過去の実行を再現する仕組みとは異なり、指定した取得期間中に発生した活動を直接記録します [16, 17]。
Workers Runtime(Workerの実行環境)は、プロファイラーの開始や停止などのライフサイクル操作を行います [18]。Workers Runtimeは、その操作の間だけisolate lock(排他ロック機構)を保持します [18]。サンプリング中はisolate lockを解放し、通常のリクエストを並行して実行します [18]。また、サンプリング結果のシリアライズ(データ変換)もクリティカルセクション(排他ロックが必要な処理区間)の外で処理します [18]。開始・停止時の操作と、結果のデータ変換を分けて処理する設計です。
後輩本番のisolateでプロファイルを取ると、実行中のリクエスト処理を止めてしまいませんか?
先輩isolate lockを保持するのはプロファイラーの開始と停止の操作時だけで、サンプリング中はロックを解放しているよ。
後輩計測を使う前後の動作は、どう確認すればよいですか?
先輩ロックを短く保つ設計と、計測による性能への影響は別だよ。同じ条件でCPU時間や応答時間を比較して、影響を確認しよう。
何が変わるか:フレームグラフの読み解き方と社内事例に見る性能改善
Dashboard上のflamegraph(フレームグラフ)では、各矩形が関数呼び出しを表します [19]。グラフをたどることで関数の呼び出し関係を把握できます [21]。フレームの幅は、その関数に帰属するCPU時間または割り当てメモリー量に比例します [20]。幅が広いフレームほど、プロファイル全体への寄与が大きいことを意味します [20]。
フレームグラフを読む際は、横軸の意味に注意が必要です。横位置は関数が実行された時刻を表しません [22]。左から右への並びはサンプルの集計結果であり、時系列を示すものではありません [22]。
画面上の表では、Selfが子孫呼び出しを除いた当該フレーム自身の値を示し、Totalは子孫呼び出しを含む合計値を示します [23]。Percent of profileは、部分ツリーを拡大表示した場合でも採取全体を分母とした割合を表します [23]。Heap profileが測定するのは採取中の割り当てであり、保持中のメモリーではありません [23]。
TypeScriptなどでビルドしたWorkerでは、source map(変換前後の対応付け情報)を有効にすることが重要です [24]。公式ドキュメントはSource maps and stack tracesです。source mapを有効にすると、プロファイル上の難読化された関数名を元のコードに対応付けて確認できます [24]。ビルド後のJavaScriptの位置も、元のファイルや行番号に対応付けられます [24]。
Cloudflareは、公式の社内事例として2つの改善実績を報告しています。1つ目は、R2 binding(オブジェクトストレージ連携)を実装した高トラフィックWorkerの事例です。50秒間のCPU profileにおいて、genericR2JsonReplacer関数がプロファイル内CPU時間の5%超を占めていました [25]。JSON.stringifyはJavaScriptの値をJSON形式に変換する関数です。各ノードで呼ばれるreplacer(置換関数)がJSONツリーを再走査していました [25]。重複走査の修正により、同関数自体の処理速度が2.7倍に向上しました [26, 27]。
2つ目は、社内Workerのメモリー割り当てに関する事例です。本番Heap profileを調べたところ、無効化したと考えられていたPrometheus(メトリクス収集・監視のためのソフトウェア)のコードが一部動作していました [28]。このコードは、プロファイル内の割り当てのおよそ66.7%を占めていました [29]。開発チームがこのコード経路を完全に削除した結果、Workerのメモリー使用量が改善しました [30]。
具体的には、各呼び出し時点のV8 isolate memory usageのP999(99.9パーセンタイル値)が133 MBから118 MBに低下しました [31]。1 isolateあたり128 MBのメモリー上限に対し、削除後は約10 MBの余裕(headroom)を確保できました [31]。
| 状態 | P999 isolate memory usage [31] | 128 MB上限に対する余裕 [31] |
|---|---|---|
| Prometheus経路の削除前 | 133 MB | 上限超過(余裕なし) |
| Prometheus経路の削除後 | 118 MB | 約10 MB |
後輩事例では関数が2.7倍速くなったりメモリーが改善したりしていますね。導入すればどんなWorkerでも同じように改善しますか?
先輩それは早合点だよ。この事例は特定の実装で生じていた重複走査や不要なコード経路を修正した結果なんだ。
後輩Prometheusの約66.7%という数値も、採取ウィンドウ中の割り当て比率であって、常時保持されているメモリー比率ではありませんよね。
先輩まさにそこが注意点だね。フレームグラフが示す指標の母数や測定条件を取り違えないように読む必要があるよ。
実務:採取の手順と測定の制約
本番環境の最適化に本機能を活用するには、Heap profileの測定特性を正しく把握する必要があります。Heap profileが測定するのは、採取ウィンドウ中に発生したメモリー割り当てです [32]。保持中のメモリー量や、割り当てられたオブジェクトが現在も生存しているかどうかは示しません [32]。本機能はheap snapshot(ヒープ全体の状態記録)とは異なります [32]。保持中の量や生存状態を示さないため、このプロファイルだけでメモリーリークを確定することはできません(本稿の解釈) [32]。
プロファイルに現れるのは取得ウィンドウ内の割り当てに限られるため、起動時などウィンドウ外で発生した割り当ては確認できません [33, 34, 35]。また、プロファイルの採取対象は直近に活動したロード済みのisolateです [15]。過去に終了した特定リクエストを、ログの時刻指定によって後から採取することはできません [16, 17]。
採取対象の指定方法にも注意が必要です(公式ドキュメント:Profiling in production)[12]。通常Workerの場合、要求したWorkerの稼働中isolateから1つが無作為に選ばれます [11]。この選び方を踏まえ、本稿では1回の採取だけで全体を判断せず、複数回の採取や集約指標と照合する方法を提案します。一方、Durable Objectsを対象にする場合は、所有WorkerのIDまたは名前、Durable Objectのnamespace ID(名前空間の識別子)を指定します。また、64桁の16進数によるactor ID(オブジェクト実体の識別子)も指定します。これらにより、稼働中のprimary actor(そのオブジェクトを担当する実体)を明示して採取します [12]。
プロファイルを採取する際は、トラフィックの要件を満たす必要があります。対象環境には採取前と採取中の両方でトラフィックが存在していなければなりません [12]。ログ画面の過去期間指定やフィルターは採取に影響せず、過去の実行記録を取得する機能ではありません [17]。
バージョンの指定方法にも配慮が必要です [12]。Dashboardではactive deployment(現在のデプロイ)内のバージョンを選択できます。一方、CLIやAPIで「latest」を指定すると直近に作成されたバージョンが対象となり、未デプロイの場合があります [12]。意図しないバージョンの採取を避けるには、実際に稼働しているバージョンUUID(一意な識別子)を明示して指定します [12]。
Dashboardでは採取時間(duration)を1,000〜50,000ミリ秒(1〜50秒)に設定でき、既定値は10秒です [12]。すでに認証が完了し、Worker IDと稼働バージョンUUIDが設定されている環境では、cf CLIを用いて以下のコマンドでCPUプロファイルを取得できます [12]。CLIは標準出力にpprof(プロファイルデータの保存形式)のバイナリデータを出力するため、ファイルにリダイレクトして保存します [12]。
cf workers versions profile "$VERSION_ID" --worker-id "$WORKER_ID" --duration-ms 5000 --profile-type cpu > worker-cpu.pprof
こうした測定仕様を踏まえ、本番環境の性能診断における実務手順を提案します(本稿の提案)。まず、調査目的に応じてCPUプロファイルまたはHeapプロファイルを選択します。次に対象のWorker、稼働バージョンUUID、およびトラフィックの活動状態を確認した上で、1〜50秒の範囲でプロファイルを採取します。
この手順案では、採取後にSelfやTotalの値に加え、採取全体を分母とするPercent of profileを確認して改善候補となる関数を絞り込みます。コードを修正した後は、初回の採取と同等の条件で再計測を行います。この手順案では、CPU time、応答時間、メモリー使用量など、利用可能な監視指標との照合も行います。採取条件と修正内容を記録し、改善効果を検証する方法を提案します。
後輩1回プロファイルを取得して問題の関数が見当たらなければ、調査は完了と考えてよいですか?
先輩通常Workerでは、稼働中のisolateを1つ無作為に選んでいるよ。Heap profileは、採取期間外の割り当てを記録しないんだ。
後輩だからこそ、条件を記録しながら複数回採取して、メトリクス全体と突き合わせる実務フローが大切なんですね。
先輩その通りだね。採取条件をそろえ、修正後の指標とコードを照合して、改善効果を確かめよう。