なぜ今エージェント専用の実行基盤が必要なのか:隔離と資源効率のジレンマ
従来型の仮想マシン(VM)は、OSを含むフルマシンの起動と構成が必要です。そのため、自律エージェントが処理の開始、一時停止、再開を頻繁に繰り返す運用では、仮想マシンの起動オーバーヘッドが累積し、全体の待ち時間を押し上げる要因となっていました[1]。
これに対し、コンテナ技術はホストOSのカーネルを共有するため、高速かつ軽量に稼働します。しかし、自律エージェントがモデルの生成した未信頼コードや任意の端末コマンドを実行する場合、共有カーネルやネットワーク境界を通じてホスト環境へ脱出(ブレイクアウト)したり、意図しないデータ漏えいが発生したりするセキュリティリスクがあります。そのため、実行環境には強固な隔離が求められます[2]。
自律エージェント特有の稼働パターンも、資源管理の課題となります。エージェントは、モデルの推論処理や外部ツールの実行応答、人間からのフィードバック入力を待つ間、長時間休止状態(dormant)に入ります。この休止中も専用のCPUやRAMを割り当て続けると、他のアクティブな処理に振り向けられる計算資源が浪費されます[3]。
標準のKubernetes環境にはPod自体を休止する機能がなく、Podのスケジューリングスループットや起動レイテンシにも制約があります。アイドル状態の計算資源をクラスタに返すにはPodを停止する必要があり、そのためエージェントの内部状態を外部ストレージへ退避して管理する仕組みが求められていました[4]。
後輩コンテナは起動が速くて手軽ですが、エージェントの実行基盤としては不足があるのでしょうか。
先輩コンテナはホストのカーネルを共有する設計だから、未信頼コードを実行させたときの脱出リスクを完全に防ぐのが難しいんだよ。一方で仮想マシンは隔離が強固だけれど、推論待ちで頻繁に止まるエージェントに対して起動時間や待機資源の浪費が大きすぎる。
後輩安全のために隔離を固めると資源効率が落ちて、効率を求めると脱出リスクが残るわけですね。この二者択一を解消するために専用基盤が必要になったと。
Agent Compute Engineの内部構造:microVMとTitaniumによる隔離・高速化
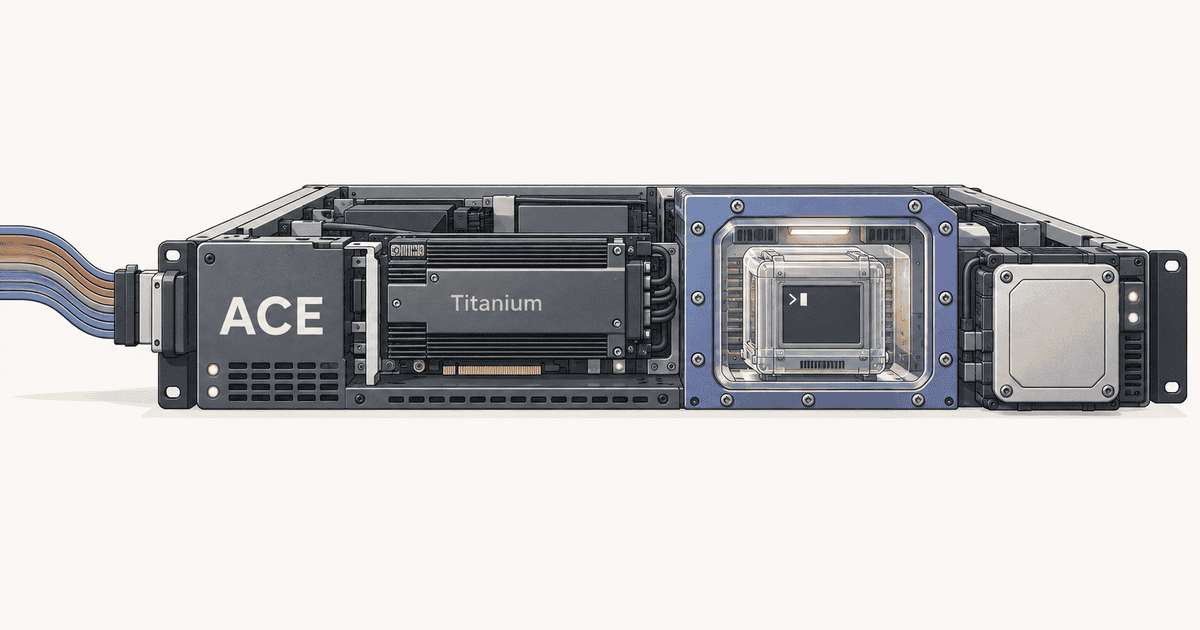
Google Cloudは2026年10月22日、こうした実行基盤の課題に対応する専用コンピュート基盤として「Agent Compute Engine(ACE)」を発表しました。ACEはGeminiの業務タスク向けエージェントを支える基盤としてすでに稼働しており、顧客向けには今後数か月以内にPreviewとして提供される予定です[5]。ACEはエージェントごとに高速起動するハードウェア隔離microVMを割り当て、待機中の資源効率を高める設計を採用しています[6]。
ACEの中核は、Cloud Hypervisor境界によってハードウェア隔離されたmicroVMです。各エージェント環境には独自のゲストカーネルとroot権限が与えられており[7]、実行コードとホスト側との分離境界を明確に保ちます[8]。さらに、インフラ層では「Titanium」(Titanium IPU)が連携し、I/O仮想化、ストレージ、暗号処理といった基盤負荷をホストCPUからオフロードして、処理と保護を担保します[9]。
アーキテクチャの分離も特徴です。モデルの呼び出しや次の行動決定を行う「ハーネス(brain)」は実行サンドボックスの外部に置かれ、生成コードの実行、シェルコマンド、ブラウザ操作といった処理は、隔離されたmicroVM内の「サンドボックス(hands)」が担います[10, 11]。ハーネスを外部に分離することで、サンドボックス内で未信頼コードが実行されても、制御層を保護する設計です[12]。
待機資源の効率化には、共通のOSテンプレートをメモリ上で共有するCopy-on-Write(CoW)メモリ共有技術を導入しています。これにより、複数のエージェントが同じ物理RAMページを共有でき、環境ごとに基本メモリを重複して確保する必要がありません[13]。さらに、ツール実行が終わってモデル推論待ちに入ると、microVM側からアイドル状態が通知されます。ホスト側は状態をチェックポイント化して休止させ、次の要求時にスナップショットから高速に再開します[14, 15]。
各microVMには専用のHyperdiskが割り当てられ、セッションをまたぐ実行ワークスペースやエージェントのコンテキスト情報を永続的に保持します[16]。セキュリティ面では、各microVMが固有のアイデンティティと短期認証情報で動作します。ゲスト環境内には永続的なシークレットやOAuthリフレッシュトークン、サービスアカウントキーを保持せず、インスタンスのメタデータサーバーへのアクセスも遮断します。外部サービスへのアクセス認証情報は、microVM外部のegress経路で注入されます[17]。顧客向けPreviewでは、開発者が環境イメージ、アイデンティティ、ネットワークアクセス、ライフサイクルを制御し、Googleが背後のフリート運用を管理します[18]。
補足:Cloud Hypervisorとは
Cloud Hypervisorは、エージェントごとにハードウェア隔離されたmicroVMを構成し、実行コードとホスト環境を分離する境界技術です。
補足:Copy-on-Write(CoW)とは
Copy-on-Writeは、リソースの複製要求があった際に物理的な複製を行わず同じ領域を参照させ、書き込みが発生した時点で初めて対象領域をコピーするメモリ管理技術です。
Agent Substrate on GKEの仕組み:Kubernetesマシン管理とエージェント実行の分離
Google CloudのフルマネージドサービスであるACEに対し、カスタマイズ性やマルチクラウド環境への可搬性を重視する組織向けに提供されるのが、オープンソースの実行基盤「Agent Substrate on GKE」です[19]。Agent Substrateは、Kubernetes環境でのマシンインフラ管理と、エージェントの高頻度な実行・休止処理を明確に分離します[20]。
この構成では、Kubernetes側はマシン、ノードの自己修復、フリートのオートスケーリング、クラスタの信頼性維持、Worker Podのライフサイクル管理といった基盤側の制御に専念します[21]。一方、エージェント処理の高頻度な実行切替は、Workerノード上の専用データプレーンで直接行います。エージェントを実行可能な計算資源へリアルタイムに載せ替えるための最小限の制御面を設け、Kubernetes標準の制御面が抱えるスケジューリングや起動遅延の制約を回避しています[22]。
標準のKubernetesではPod単位の休止がサポートされないため、Agent Substrateは「Actor」と呼ばれる単位でエージェントの状態を扱います。エージェントが推論待ちなどでアイドル状態に入ると、稼働中のアクティブメモリ(RAM)とローカルファイルをスナップショットとしてCloud Storageへ退避し、空いたWorkerをプールに返します[23]。
新たな実行要求が発生すると、プール内の準備済みWorker(pre-warmed worker)にCloud StorageからActorのスナップショットを復元し、処理を再開します[24]。高頻度の休止・再開をWorker上のデータプレーンで処理し、エージェントの状態復元を標準Podの作成・削除から切り離すことで、クラスタの高密度化と高速な復帰を両立させています[25]。
提供形態として、Google Cloudサービスとしてハードウェア隔離microVMを提供するACEに対し、Agent Substrate on GKEは自前のGKE環境に導入する実行層と位置付けられています[26]。現時点でAgent Substrate on GKEは評価・非本番環境向けに広く提供されており、本番環境向けのサポートはallowlist方式です[27]。
後輩Kubernetes上で動かすのであれば、通常のPodとしてオートスケールさせる方式では不十分なのでしょうか。
先輩Kubernetes標準のPodはスケジューリングや起動に制約があって、頻繁に休止と復帰を繰り返すエージェントのライフサイクルに対してオーバーヘッドが大きすぎるんだよ。
後輩ノードやマシンの管理はKubernetesに任せつつ、エージェントの休止と再開だけをWorker上の専用層で処理することで、スケジューラの負荷を避けているわけですね。
ACEとAgent Substrate on GKEの機能比較:管理責任・隔離境界・ネットワーク制御
ACEとAgent Substrate on GKEは、ともにエージェントの安全な実行と資源効率化を目指していますが、運用の管理責任、隔離方式の選択肢、ネットワークや認証情報の制御機能に明確な違いがあります。
隔離技術について、ACEはCloud Hypervisor境界のハードウェア隔離microVMを固定的に提供します。一方、GKE版のAgent Substrateでは、Cloud HypervisorのmicroVMに加えてgVisorによるサンドボックス分離を選択できます[28]。ただし、現行のAgent Substrate on GKEは、ActorコンテナへのGPUデバイスパススルー、混在CPUアーキテクチャのVM系列、ActorTemplate内での複数VMタイプの混在指定に対応していません[29, 30]。
ネットワーク制御と認証情報の取り扱いにも違いがあります。ACEではmicroVMごとに短期認証情報が付与され、サービス認証情報はmicroVM外部のegress経由で注入されます。接続先ポリシーはAgent Identity、IAM、Agent Gatewayの各ポリシー層が統括します[31]。
一方、Agent Substrate on GKEの現行公式ドキュメントには、EgressPolicyによるdefault-deny規則やホスト名ベースの規則、認証情報注入機能は未サポートと記載されています[32]。また、エージェントが休止状態に入ると、データベースセッションやMCP(Model Context Protocol)サーバーへのオープンなネットワーク接続は保持されません。そのため、スナップショット復元後に処理を再開する際は、エージェント側で外部サービスとの接続を再確立する設計が必要です[33]。Agent GatewayのGKE対応についても「近日提供」と案内されています[34]。
| 比較項目 | Agent Compute Engine (ACE) | Agent Substrate on GKE |
|---|---|---|
| 提供形態 | Google Cloud フルマネージドサービス[19] | オープンソース実行層(自社GKEクラスタに導入)[19] |
| インフラ管理責任 | Googleがインフラフリート全体を運用管理(利用者はイメージ・ポリシー等を設定)[18] | 利用者がGKEクラスタやノードを運用管理(SubstrateがWorker上のエージェント切替を制御)[21] |
| 隔離技術 | Cloud Hypervisor によるハードウェア隔離microVM[7] | Cloud Hypervisor microVM または gVisor[28] |
| ネットワーク制御・認証情報 | microVM外のegressで認証情報を注入、Agent Gateway・IAMで制御[31] | EgressPolicy(default-deny、ホスト名規則)や認証情報注入は未対応[32] |
| 休止時の外部接続 | 休止後の接続維持は公開情報で未確認 | データベースやMCP等のオープン接続は保持されず再接続が必要[33] |
| ワークスペース・コンテキストの永続化 | 専用Hyperdiskにより複数セッションにわたり保持[16] | Cloud Storageへのスナップショット退避により保持[47] |
| 主な制約 | クォータ・最大仕様等は非公開[56] | GPUパススルー非対応、混在CPU系列非対応、GKE 1.36/1.37要件[29, 30] |
| 提供ステータス | 今後数か月以内にPreview提供予定(Geminiで先行稼働)[5] | 評価・非本番向け提供中、本番サポートはallowlist方式[27] |
公表ベンチマークの測定条件と性能値の検証
GoogleはAgent Substrateのベンチマーク検証で、20万エージェントを対象に毎秒500回のアクティベーションを維持し、休止・再開レイテンシを500ms未満に抑えたと報告しています[34, 35]。
ただし、この500ms未満という数値は、事前起動済みのアイドルWorker(pre-warmed worker)に対し、Cloud Storageから休止中Actorのスナップショットを復元する処理時間を測定したものです。ゼロからのmicroVMのコールド起動時間を測定した値ではありません[36]。
また、公式発表では、レイテンシの統計分布(p50/p90/p99等)、20万エージェントのうち同時に稼働していた数と休止していた数の内訳、使用したホストマシンの仕様や台数、エージェントごとの状態サイズ、具体的なワークロード内容、比較対象の環境、失敗率、反復試行数、実行ログは公表されていません。公開されているGitHubベンチマーク手順にはp50・p90・p95・p99やリクエスト当たりの失敗率を記録する仕組みがありますが、20万エージェントの発表数値に直接結び付く実行ログや設定一式は、公開ページから確認できません[37]。
計算密度に関する主張も、前提条件の確認が必要です。Googleの発表では従来型コンピュート比で最大10倍、GKE公式ブログでは標準コンテナランタイム比で10倍、かつホスト当たり休止エージェント1,000超と報告されています。しかし、比較対象のインフラ構成、ホストのハードウェア仕様、エージェントの状態サイズは示されておらず、倍率を外部から再計算するのは困難です[38]。GitHubリポジトリのREADMEには「400ms未満の再開時間」「毎秒1,500回超のアクティベーション」という記載もありますが、該当数値の測定負荷条件、ホスト構成、分位点、エージェント数は特定できません。そのため、公式発表の20万エージェント検証値と同じ条件で直接比較することはできません[39]。
フルマネージド基盤であるACEについて、公式発表はmicroVMが「高速に起動する(boot rapidly)」と定性的に述べるにとどまり、コールド起動時間や再開時間、その分布などの具体的な数値は公表していません[40, 41]。また、今回確認された公式資料には、ACEとAgent Substrateのいずれについても、用途別のタスク実行成功率やモデルの回答精度に関する測定値は見当たりません[42]。
なお、別製品の「Agent Sandbox on GKE」では、統合warm poolからの割り当てについて、毎秒300 sandbox/cluster、サブ秒レイテンシ、割り当ての90%が200ms以内という値が公表されています。これはあらかじめ確保されたプールからの割り当て速度を示す値であり、コールド初期化やAgent Substrateのスナップショット復元性能とは区別して評価する必要があります[43, 44]。
| 測定・公表項目 | 公表値 | 測定対象・処理内容 | 公開されている前提・条件 | 非公開・未確認の前提条件 |
|---|---|---|---|---|
| Agent Substrate 休止・再開レイテンシ | 500ms 未満[34, 35] | 休止Actorのスナップショットを事前起動済みWorkerへ復元[36] | 20万エージェント規模、毎秒500アクティベーション[34] | レイテンシ分布(分位点)、同時稼働数と休止数の内訳、ホスト型・台数、状態サイズ、失敗率、実行ログ[37] |
| Agent Substrate 計算密度 | 10倍(従来型比/標準コンテナ比)、ホスト当たり休止1,000超[38] | 同一ホスト上で休止状態のエージェントを多重収容する密度[38] | 2026年10月発表・2026年9月GKEブログ記載[38] | 比較対象のインフラ構成、ホストのハードウェア仕様、エージェントのRAM・ディスクサイズ[38] |
| Agent Substrate README性能値 | 400ms 未満、毎秒1,500回超アクティベーション[39] | GitHubリポジトリ上で掲げられた再開レイテンシ・スループット[39] | GitHub READMEの記載[39] | 測定時の負荷条件、ホスト構成、分位点、測定エージェント数(発表ベンチマークと直接比較不可)[39] |
| Agent Compute Engine (ACE) 起動性能 | 定性表現(rapidly)[40] | microVMの起動全般[40] | 2026年10月発表の公式解説[40] | コールド起動時間、スナップショット再開時間、レイテンシ分布、実行成功率[40, 42] |
| Agent Sandbox on GKE 割り当て性能 | 毎秒300 sandbox/cluster、90%が200ms以内[43] | 統合warm poolからのsandbox割り当て(別製品)[43] | 2026年5月発表、GKEクラスタ内のwarm pool割り当て[43] | コールド初期化やスナップショット再開の数値ではない(別製品の仕様)[43, 44] |
セキュリティとデータ保護の実態:ハードウェア隔離の境界と外部防御の必要性
microVMによるハードウェア隔離は、未信頼コードの実行に伴うホスト環境への脱出(ブレイクアウト)を抑制する強固な実行境界として機能します。ただし、ハードウェア隔離を導入しても、エージェント運用の安全性全体が保証されるわけではありません。
例えば、プロンプトインジェクションやツールポイズニングによってモデルの思考・判断プロセスが誘導される攻撃や、エージェントに正当に付与されたツール権限の不適切な行使は、仮想マシンのハードウェア隔離境界では防ぎきれない脅威です。こうした脅威に対処するには、IAMによる厳格な最小権限設計や、Agent Gateway、Model Armorなどの実行時ガードレールを組み合わせた多層防御が不可欠と考えられます[45]。
ACEのガバナンス設計でも、microVM単体ではなく上位の制御層が重要な役割を担います。エージェントが実行する各アクションの監査証跡を記録し、人間ではなくエージェント自身に行動を帰属させるトレーサビリティは、microVM境界ではなくAgent Identity、Agent Gateway、ログ層が担います[46]。
エージェントの休止に伴う保存データの保護も、確認すべき重要事項です。ACEではHyperdiskにワークスペースやコンテキストが保持され、Agent Substrate on GKEではRAM上の稼働状態やローカルファイルを含むスナップショットがCloud Storageへ退避されます。これらの基盤ストレージは保存時暗号化を提供しており、顧客管理暗号鍵(CMEK)も適用できます[47]。
ただし、RAMやローカルファイルを含むスナップショットデータは、エージェントの実行停止後も外部ストレージ上に残ります。microVMの隔離機能が保護するのは実行中のプロセス境界です。保存データを保護するには、Cloud Storageバケットやディスク側のIAMアクセス制御、暗号鍵の管理、適切なライフサイクルルールやデータ削除設定を別途講じる必要があります[48]。
後輩microVMでハードウェア隔離されていると聞くと、セキュリティ対策は十分整ったように感じてしまいます。
先輩microVMが防ぐのは、実行されたコードがホストOSや隣の環境へ飛び出す脱出事故なんだよ。モデル自身が不正なプロンプトに誘導されて、与えられた正規の権限で勝手にデータを送ってしまうようなリスクは、仮想化の壁では防げない。
後輩足場の隔離とエージェントの権限制御は全く別のレイヤーなんですね。IAMやGatewayによる制御をセットで考えなければいけない理由が分かりました。
実務への導入判断とユースケース別の使い分け:提供状況・要件・評価方針
ACEとAgent Substrate on GKEを実務に導入する際は、自社の要件や運用体制に照らして使い分ける必要があります。
想定されるユースケースとして、ACEの公式資料では、対話型エージェントによるコード実行、ヘッドレスブラウザ操作、ソフトウェア開発ワークスペース、大規模なモデル評価や強化学習(RL)が挙げられています[49]。Agent Substrate on GKEのユースケースには、バックグラウンドで待機する生産性エージェント、未信頼コードの実行やツール呼び出し・データ分析を行う一時サンドボックス、端末コマンドとファイル編集を伴うコーディングエージェントがあります[50]。
インフラの運用管理を自社で抱えずにGoogle Cloudのマネージド基盤を利用したい場合や、エージェントのハーネス開発に注力しながら永続的なワークスペース環境を活用したい場合は、ACEが向いていると考えられます[51]。一方、既存のKubernetesクラスタと運用チームがあり、実行環境のカスタマイズや他クラウド・オンプレミスへの可搬性を重視する場合、または長時間休止するエージェントを自社クラスタ上で大規模に集約運用したい場合は、Agent Substrate on GKEが適しています[52]。
提供状況と導入条件も確認が必要です。ACEはGeminiで先行稼働していますが、顧客向けには今後数か月以内にPreviewとして提供する予定です[53]。Preview申込フォームでは、業務用メールアドレス、allowlist対象のGCP Project ID、ワークロード概要、希望機能、microVMごとのリソース形状(vCPU、RAM、ディスク)、総容量の記入が求められます[54]。ホストリージョンの希望先として、北米(us-central1、us-east4/us-east1、us-west1/us-west4)、欧州(europe-west1/europe-west4)、アジア太平洋(asia-southeast1/asia-northeast1)などが提示されています[55]。ただし、固有のプロジェクトクォータやリソース上限、審査基準は公表されていません[56]。ACE専用の確定料金も現時点では公表されておらず、Gemini Enterprise Agent Platformの料金ページに記載されたRuntime/Sandbox向け単価(Agent Compute: $0.085/vCPU-h、Agent Memory: $0.009/GiB-h)がACEに直接適用されるかは未確認です[57, 58]。さらに、マルチクラウド連携を担うAgent Gatewayは「preview soon」、トークン・コストガバナンスやモデルルーティングは「今四半期のPreview」とされています[59]。
Agent Substrate on GKEの導入には、GKE Standardクラスタ(バージョン1.36でbeta flags有効、または1.37以降)、Workload Identity Federation for GKEの有効化、スナップショット保存用のCloud Storageバケットが必要です(バージョン1.36ではノードの再作成が必要になる場合があります)[60, 61]。評価や非本番用途では全顧客がすぐに利用できますが、本番サポートはprivate GAプログラム経由のallowlist方式で、申請後48時間以内のフォローアップが案内されています[62, 63]。
最後に、実務での検証方針です。エージェント実行基盤を選定・導入する際は、公表数値をそのまま適用せず、自社の代表的なワークロードで実測することが重要です。実際のエージェント状態サイズに伴うスナップショット容量、休止からの復帰時に発生するツールやネットワークの再接続オーバーヘッド、アクセス集中時の復帰挙動を個別に検証する必要があります[64]。また、インフラとしてのスナップショット復元性能と、モデルやエージェントがタスクを正常に完遂できたかを示す実行成功率や回答品質は性質が異なります。そのため、両者を分けて評価基準を設計することが重要と考えられます[42, 64]。


